5-梯度下降——模型如何自己学会找最优参数
梯度下降——模型如何自己学会找最优参数
知识点概览
本视频系统讲解了机器学习中最核心的优化算法——梯度下降(Gradient Descent)。内容涵盖:
- 模型训练本质:通过数据搜索最优参数 $W$ 和 $b$
- 损失函数(Loss Function) 与 均方误差(MSE) 的定义
- 导数、偏导数 与 梯度 的数学概念及其几何意义
- 参数更新公式与 学习率(Learning Rate) 的作用
- 线性回归中梯度下降的完整推导与 NumPy 代码实现
- 学习率大小对收敛速度及稳定性的影响(收敛慢、震荡、梯度爆炸)
- 优化器演进:Momentum、AdaGrad、RMSprop、Adam
- 随机梯度下降(SGD) 与 小批量梯度下降(Mini-batch) 的工业实践
 *
1. 模型训练的本质:参数搜索
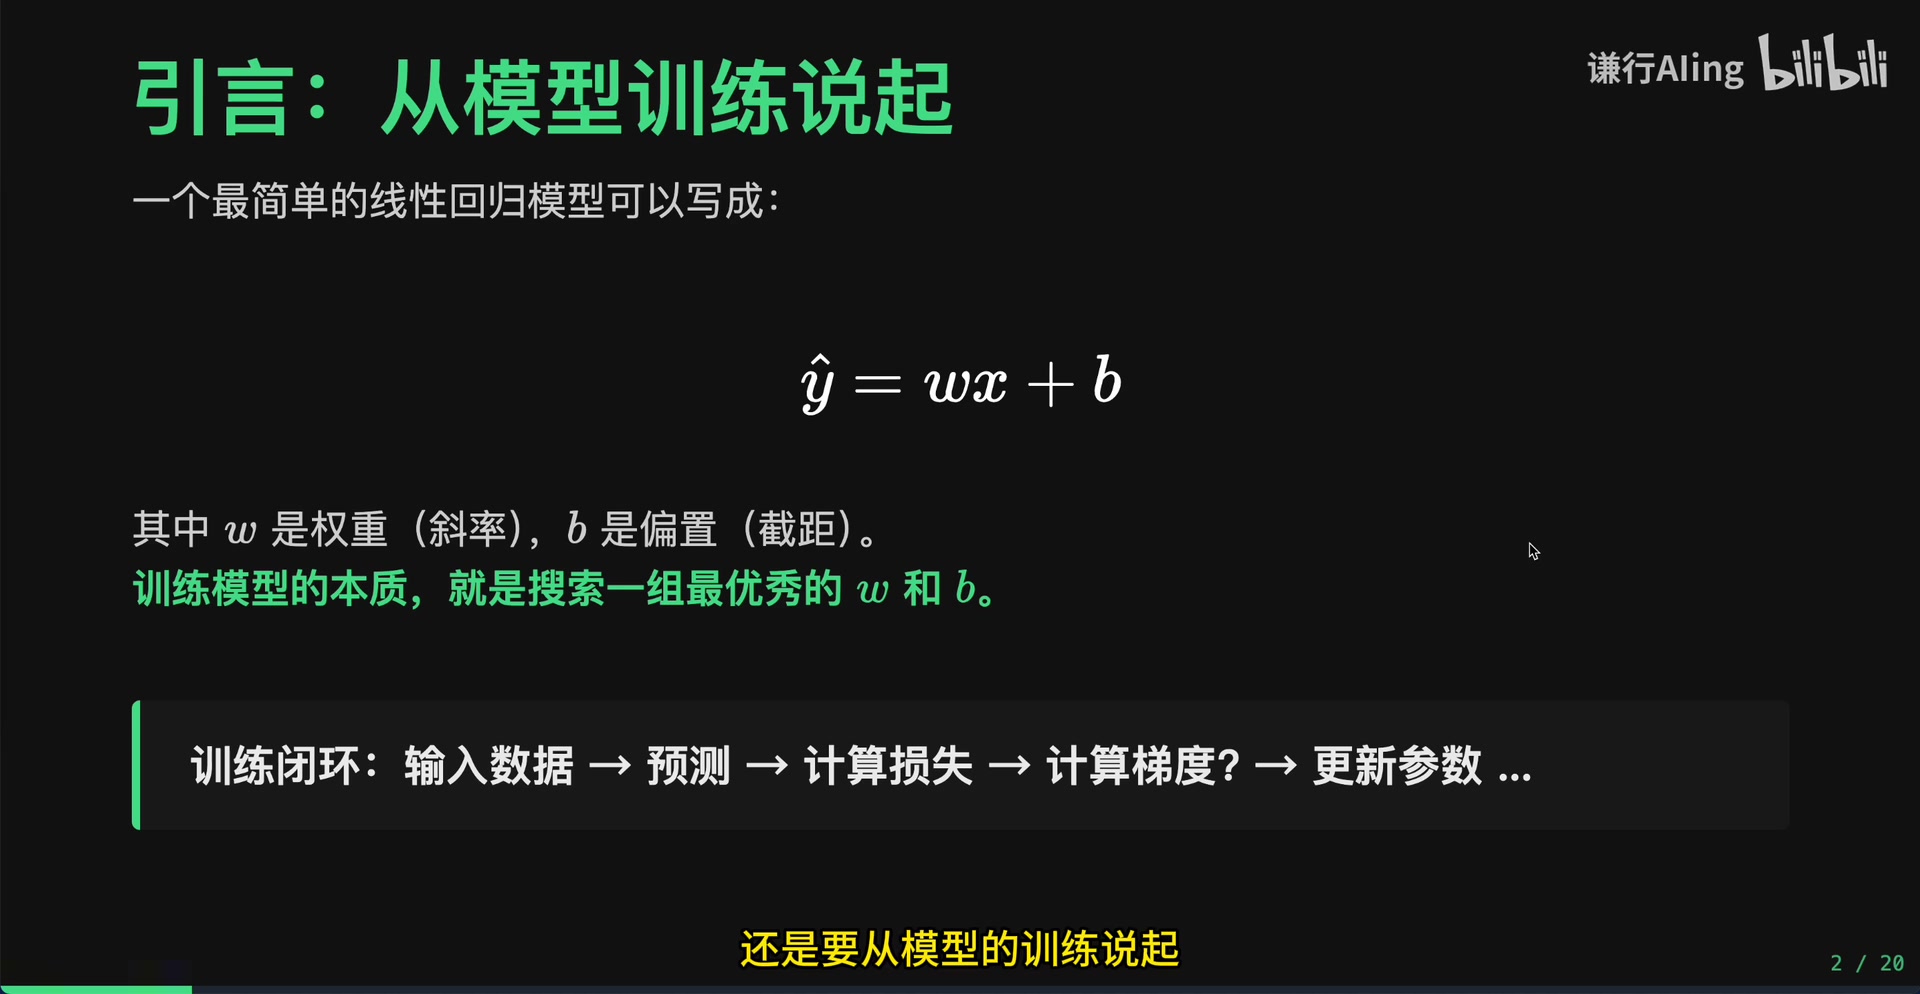
模型预测的准确性主要取决于参数的选择。在监督学习中,训练模型的本质是一个搜索过程:寻找一组最优的参数(如权重 $W$ 和偏置 $b$),使得模型能够尽可能拟合训练数据。
以最简单的线性模型为例:
$$\hat{y} = Wx + b$$
其中:
- $W$ 为权重(Weight)
- $b$ 为偏置(Bias)
训练过程通过不断输入数据、计算预测值与真实值的偏差(损失),并据此调整参数。这种参数调整的核心机制即为梯度下降。
 *
2. 损失函数:衡量预测偏差
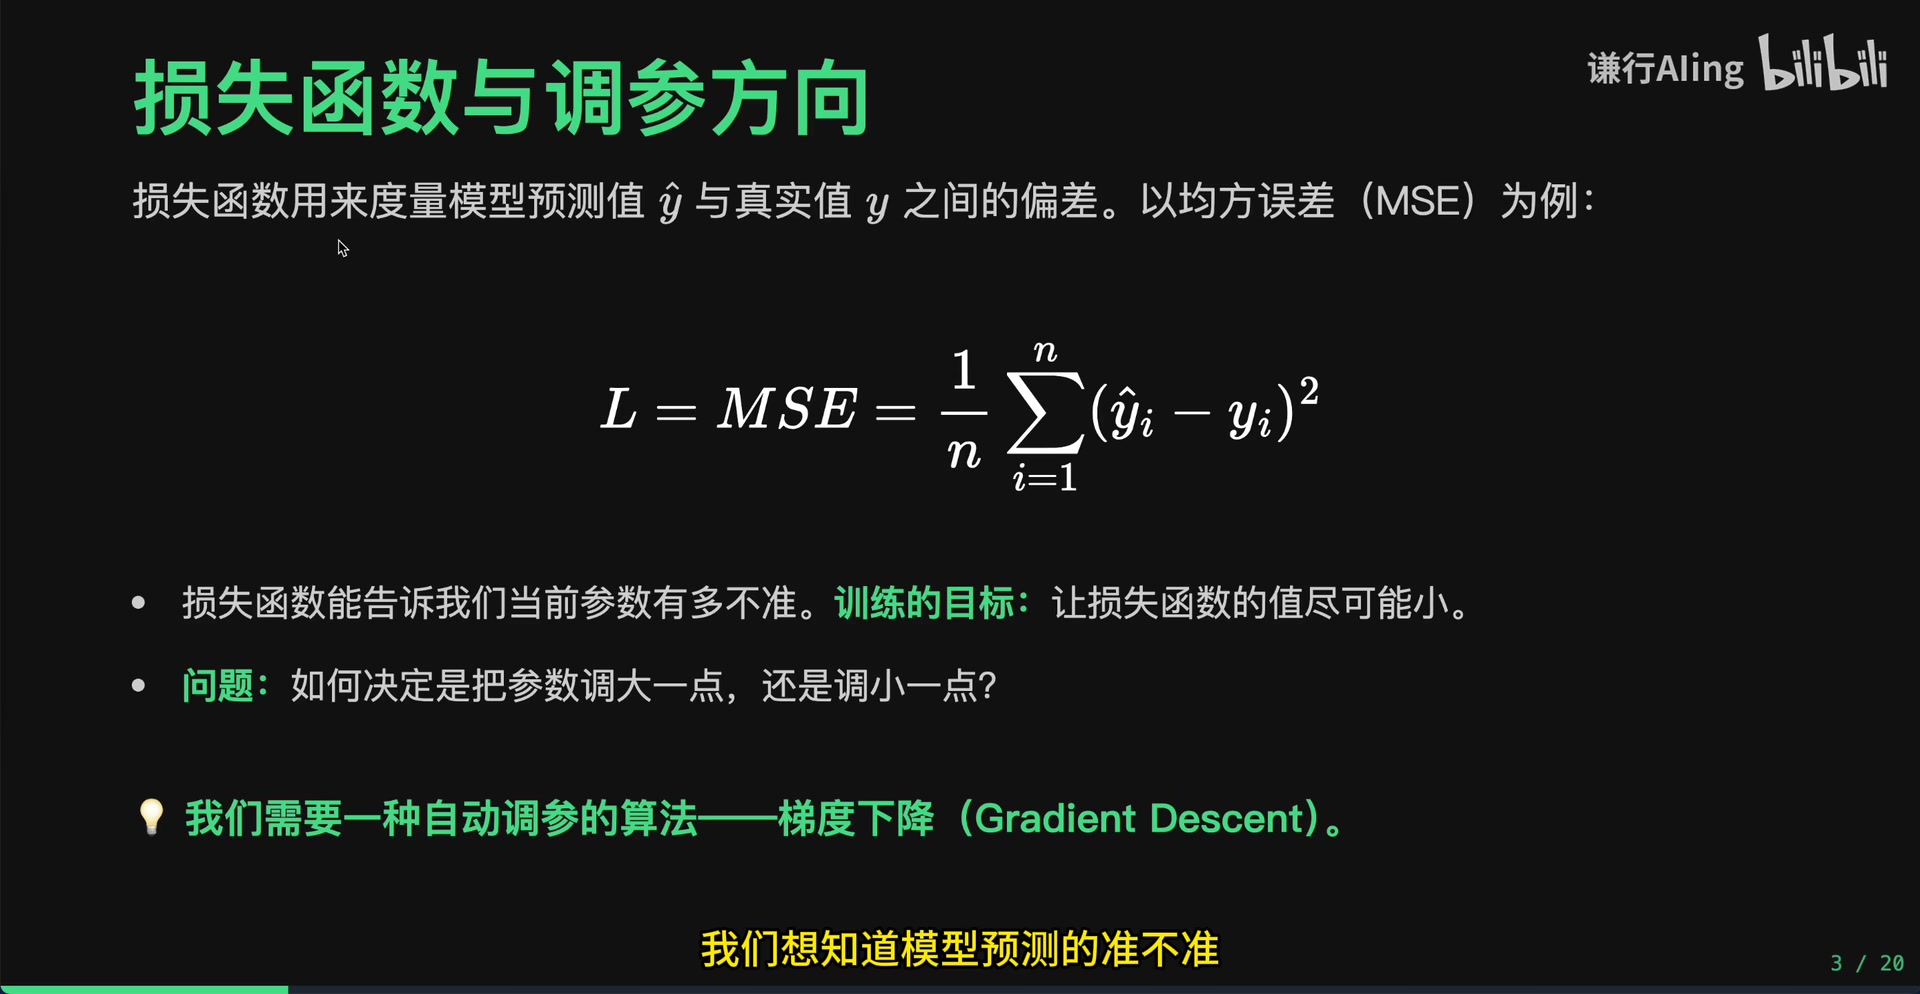
为了量化模型预测的准确性,需要引入损失函数(Loss Function)。在线性回归任务中,通常采用均方误差(Mean Squared Error, MSE):
$$J(W, b) = \frac{1}{N} \sum_{i=1}^{N} (y_i - \hat{y}i)^2 = \frac{1}{N} \sum{i=1}^{N} (y_i - (Wx_i + b))^2$$
其中:
- $N$ 为样本数量
- $y_i$ 为真实值
- $\hat{y}_i = Wx_i + b$ 为模型预测值
训练目标是使损失函数的值尽可能小。损失越小,说明参数越能准确反映数据的内在规律。
 *
3. 梯度下降的数学原理
3.1 导数:函数的变化率
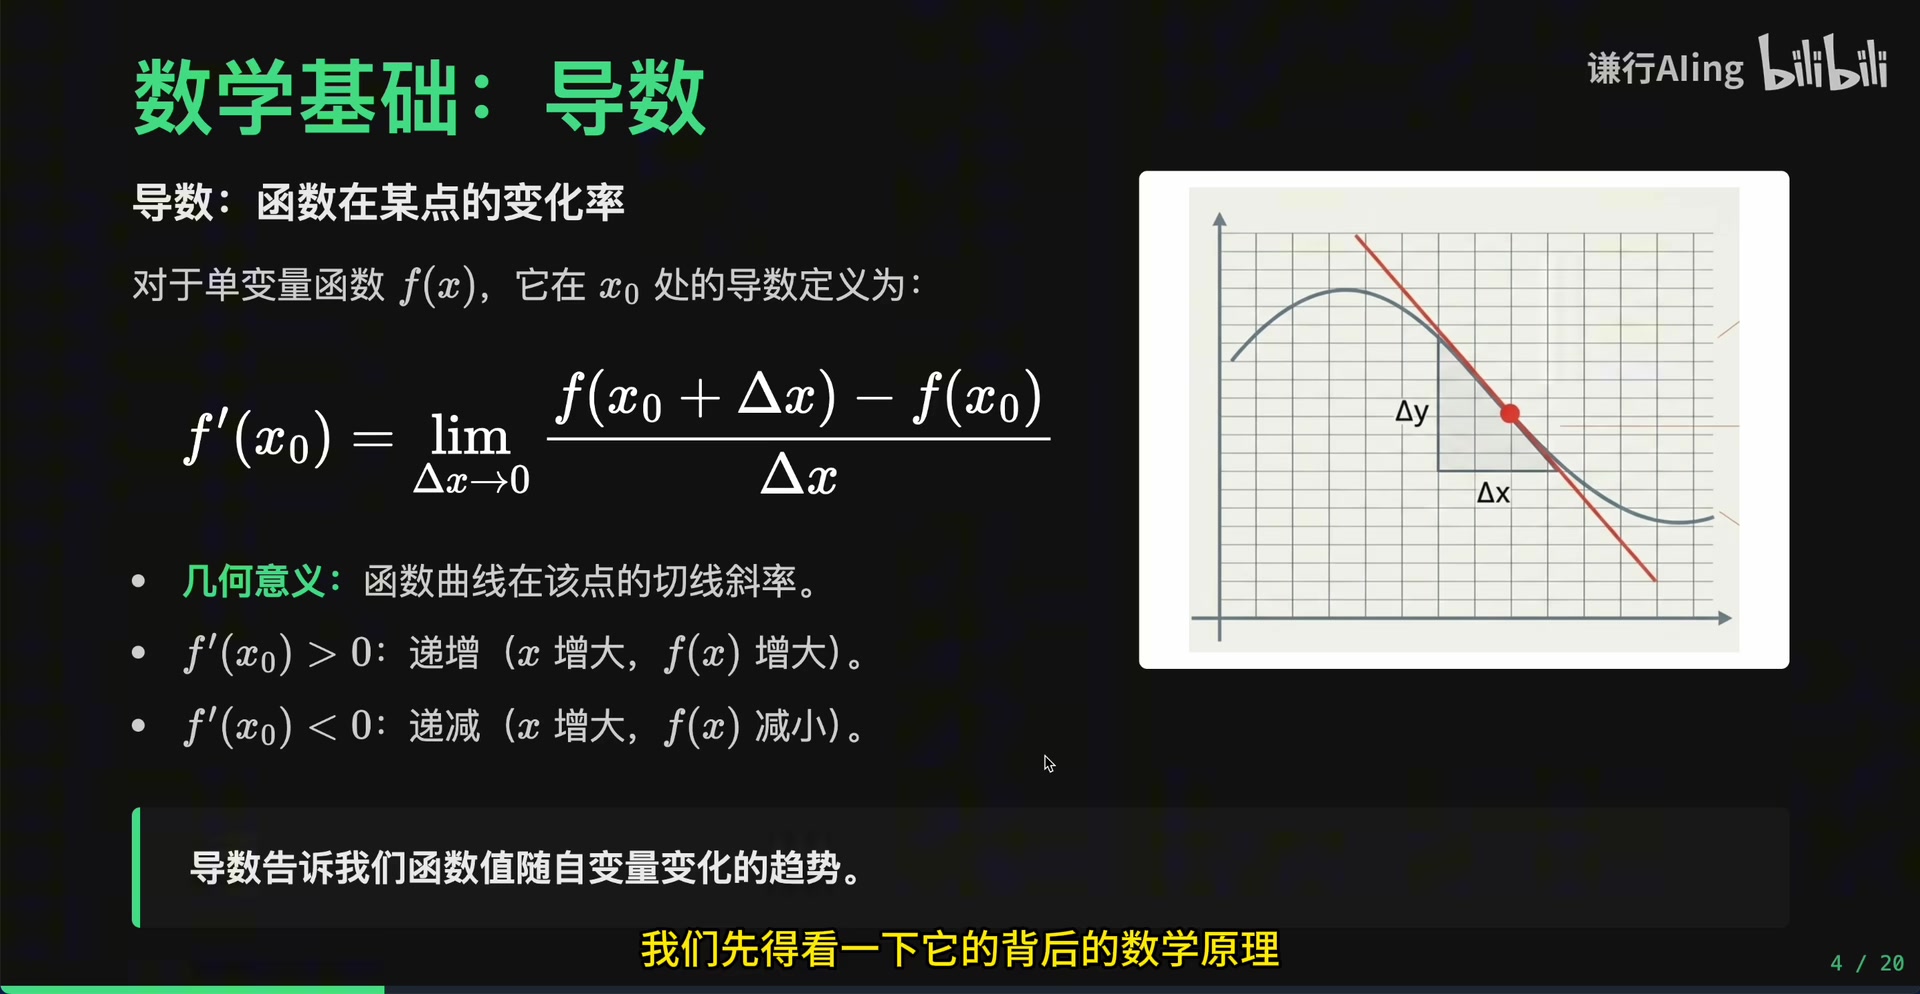
导数描述函数在某一点处的瞬时变化率。对于函数 $f(x)$ 在点 $x_0$ 处的导数:
$$f’(x_0) = \lim_{\Delta x \to 0} \frac{f(x_0 + \Delta x) - f(x_0)}{\Delta x}$$
几何上,导数即为该点处切线的斜率:
- 若 $f’(x) > 0$,函数值随 $x$ 增大而上升
- 若 $f’(x) < 0$,函数值随 $x$ 增大而下降
 *
3.2 偏导数:多变量函数的局部变化率
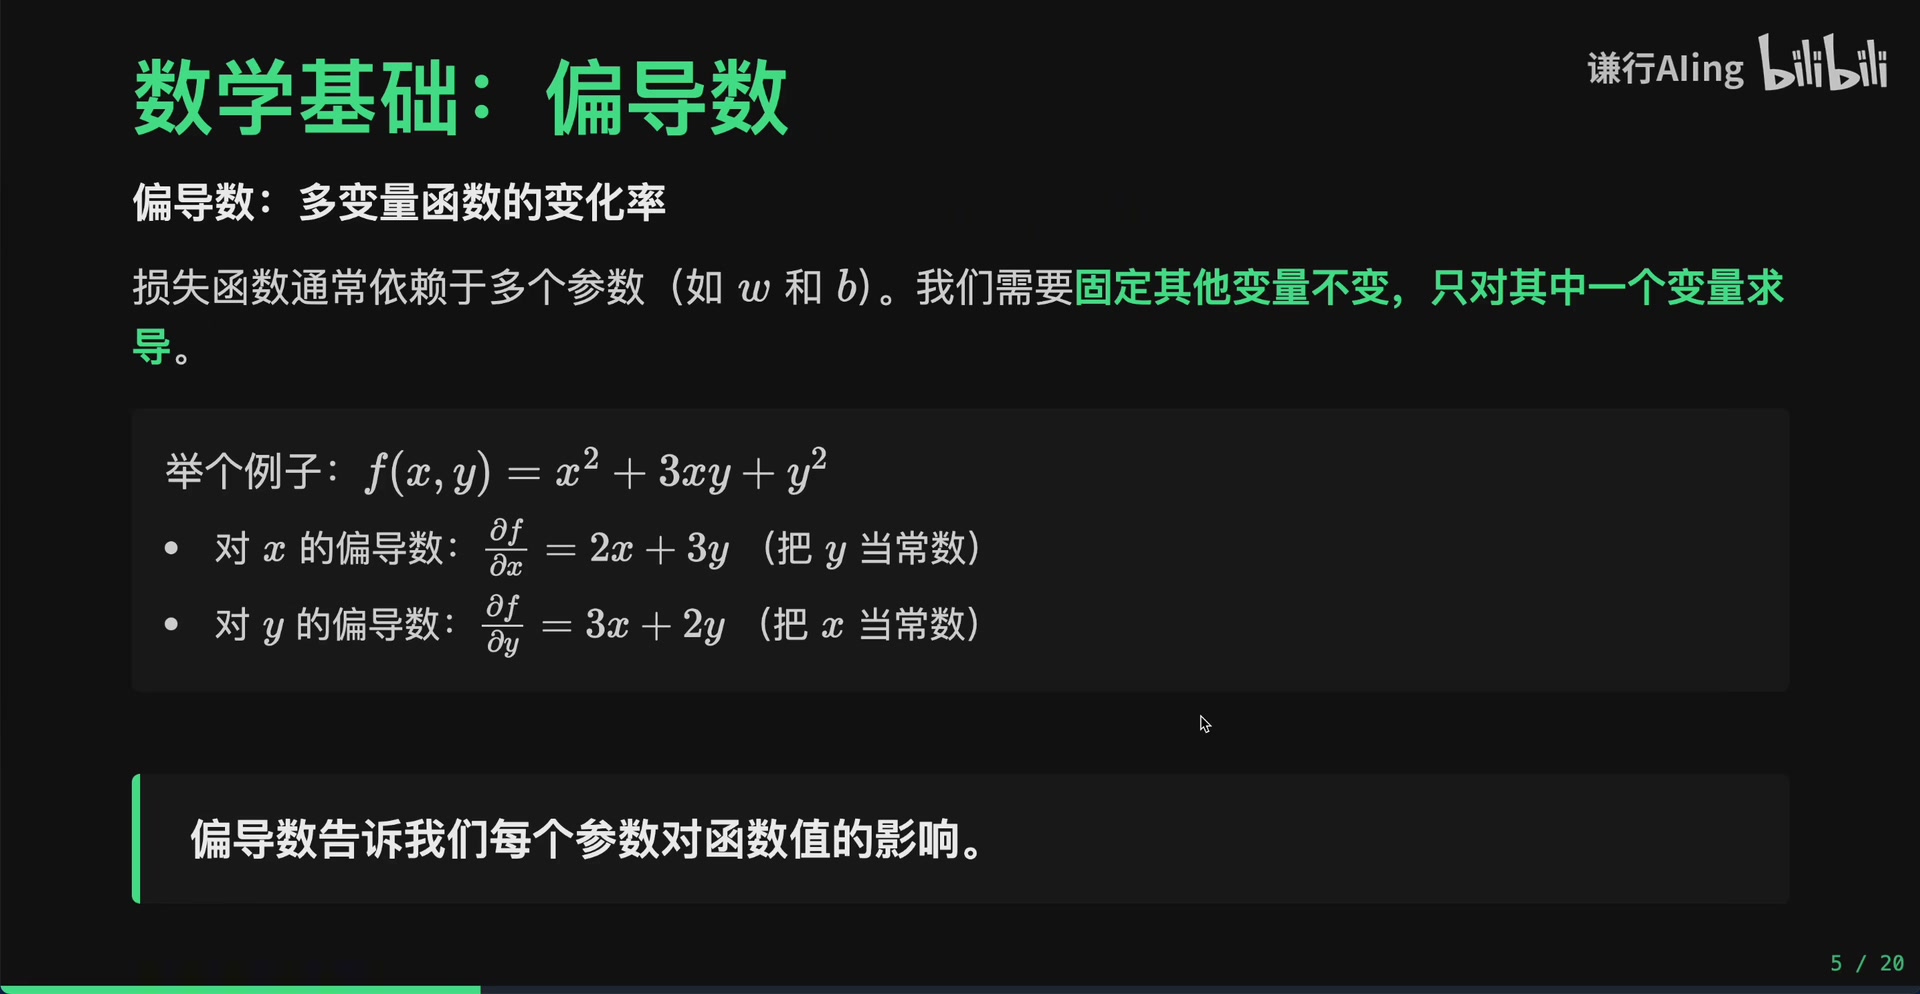
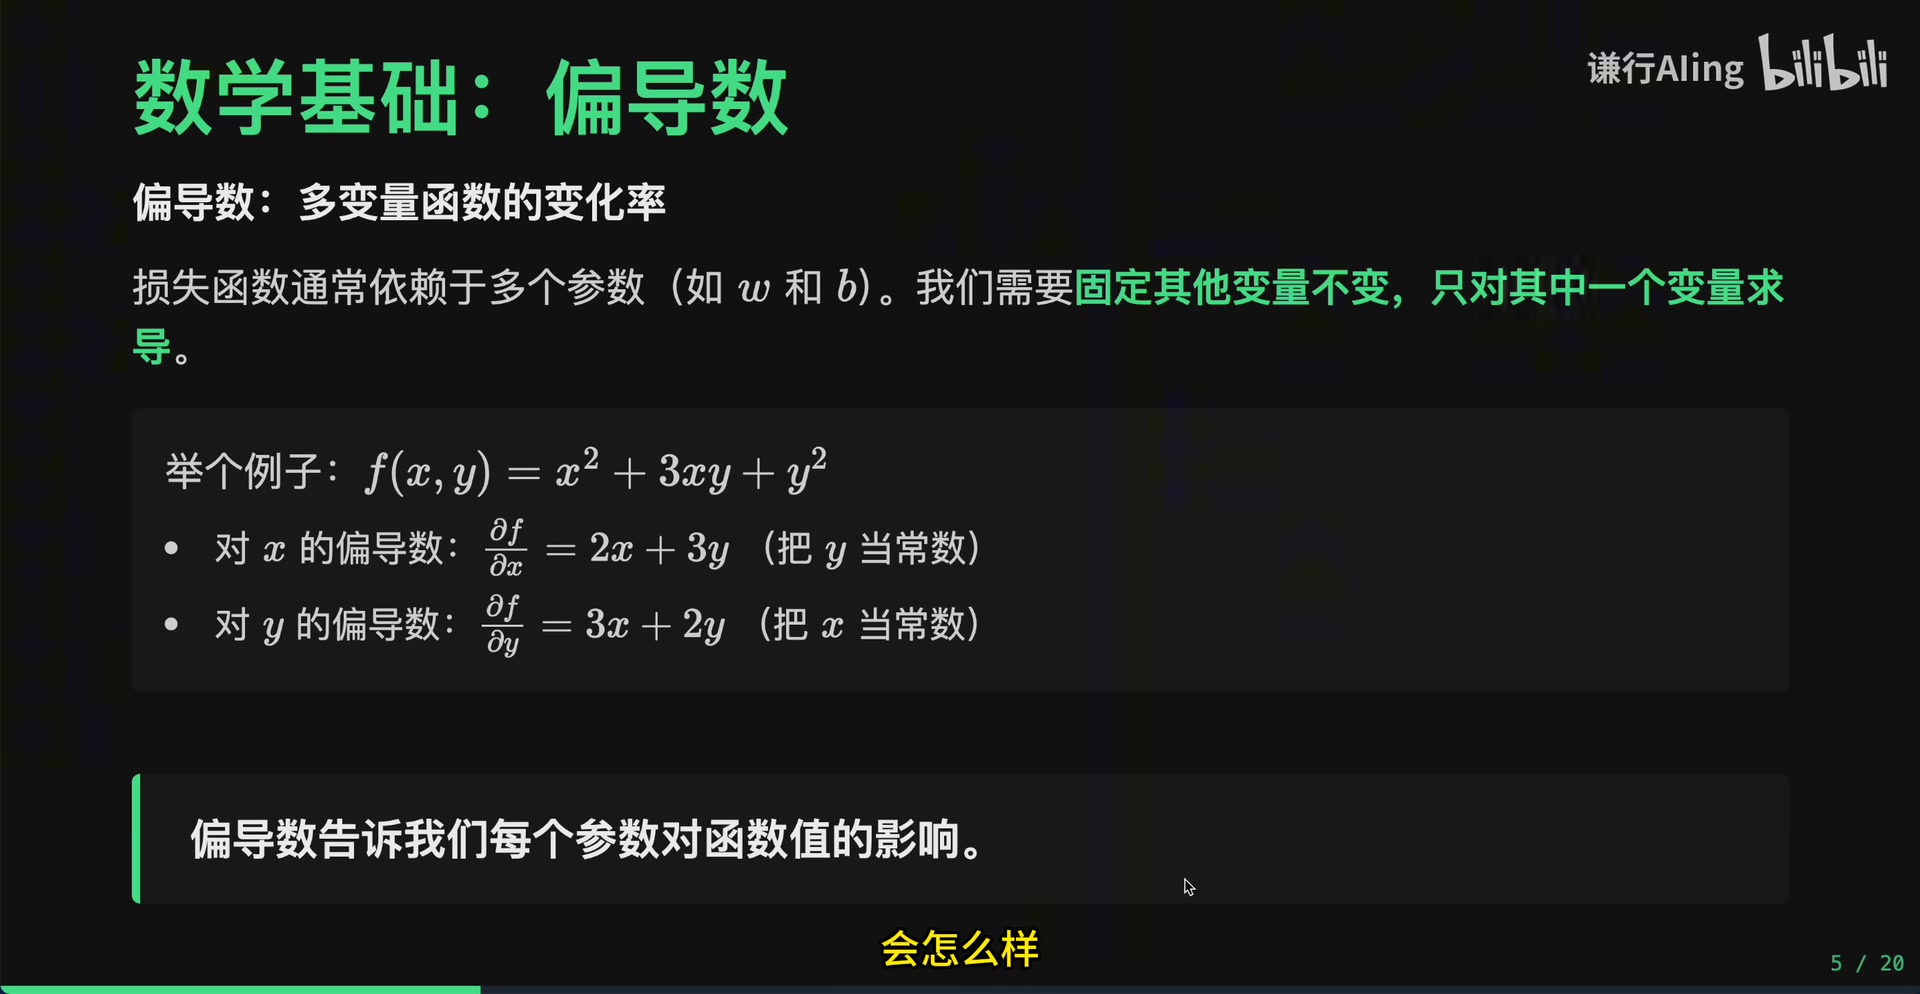
当函数依赖于多个参数时(如损失函数 $J(W, b)$ 同时依赖 $W$ 和 $b$),需要引入偏导数。求某一参数的偏导数时,将其他参数视为常数。
示例:设 $f(x, y) = x^2 + 3xy + y^2$
$$\frac{\partial f}{\partial x} = 2x + 3y$$
$$\frac{\partial f}{\partial y} = 3x + 2y$$
偏导数反映了单个参数对函数值整体影响的敏感度。
 *
3.3 梯度:偏导数构成的向量
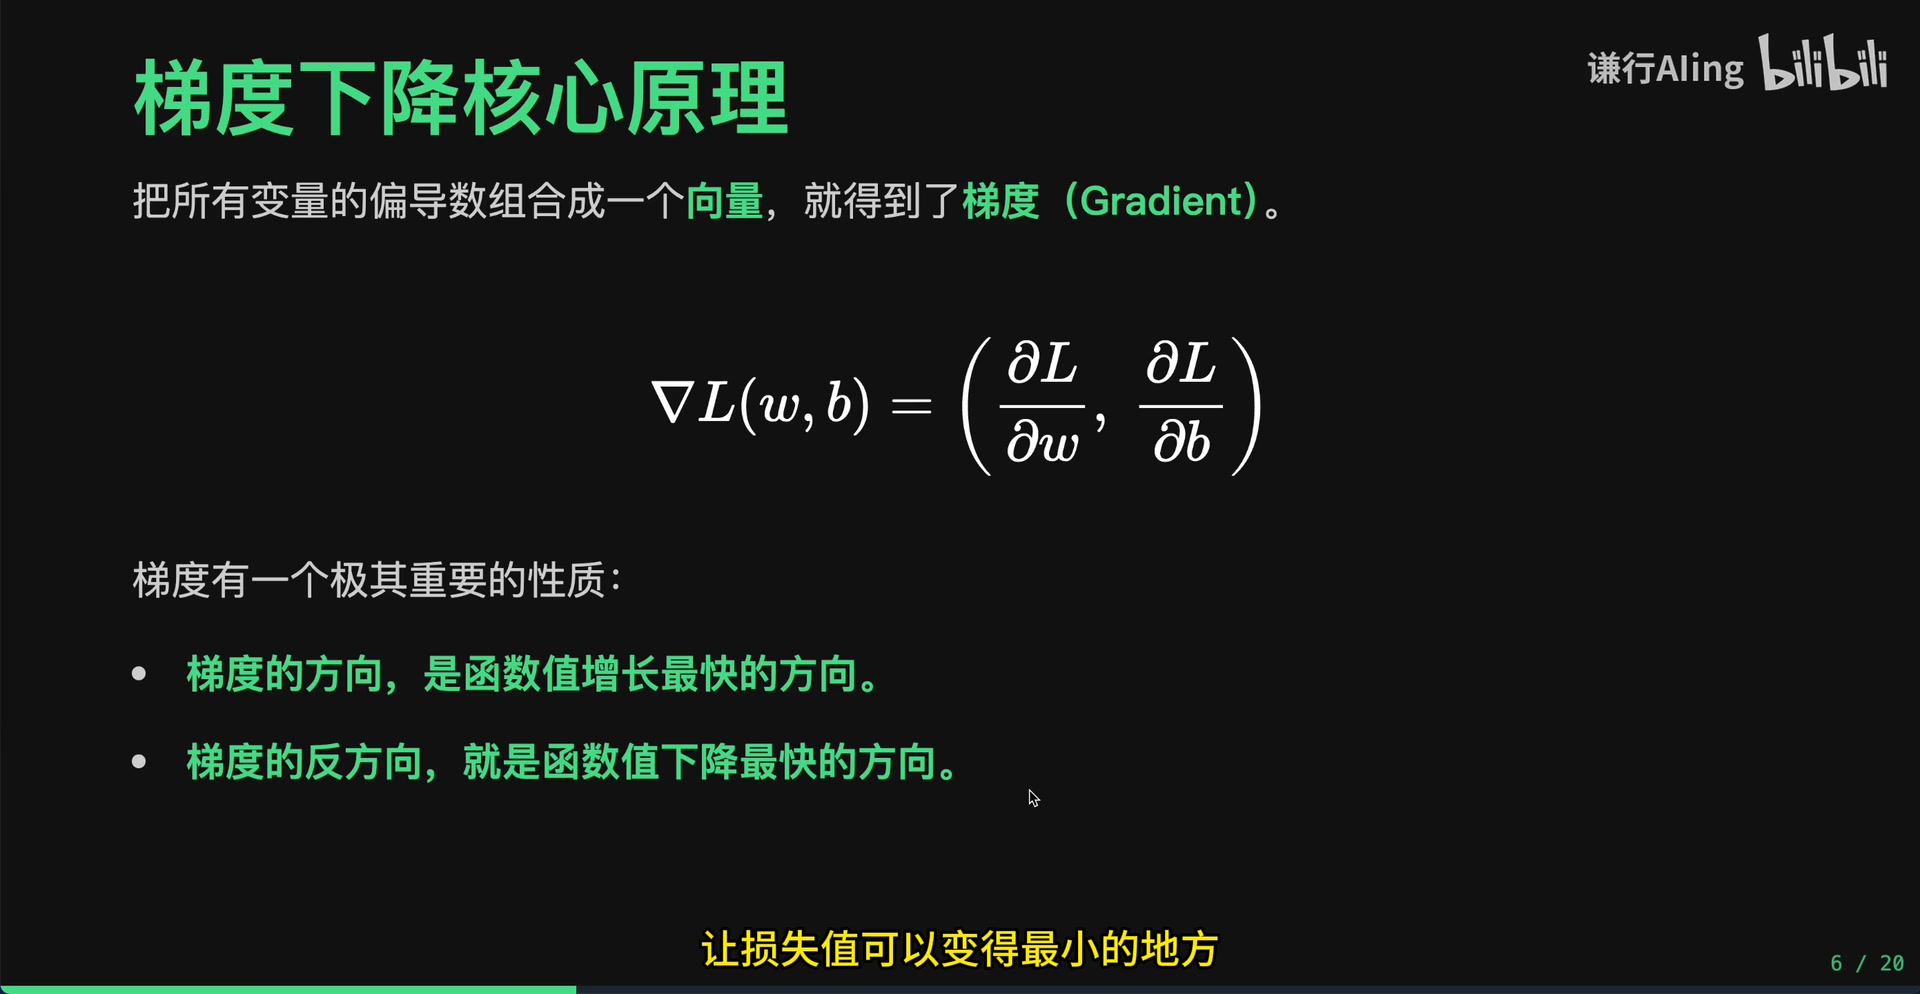
将所有参数的偏导数组合成一个向量,即为梯度(Gradient)。对于损失函数 $J(W, b)$:
$$\nabla J = \begin{bmatrix} \frac{\partial J}{\partial W} \ \frac{\partial J}{\partial b} \end{bmatrix}$$
梯度具有两个关键代数性质:
- 梯度方向是函数值增长最快的方向
- 梯度的反方向是函数值下降最快的方向
因此,沿着梯度的反方向调整参数,即可实现损失函数的快速下降,这一方向称为梯度下降方向。
 *
4. 参数更新与线性回归实例
4.1 参数更新公式
基于梯度下降的性质,参数的更新规则为:
$$\theta_{new} = \theta_{old} - \eta \nabla J(\theta_{old})$$
其中:
- $\theta$ 表示模型参数(如 $W$ 或 $b$)
- $\eta$(eta)为学习率(Learning Rate),是一个人为设置的超参数,控制每次更新的步幅
- 减去梯度是为了向函数值下降最快的方向移动
学习率的选择至关重要:
- 过大:参数更新幅度过大,可能越过最优解,导致震荡甚至梯度爆炸
- 过小:收敛速度极慢,训练时间成本过高
 *
4.2 线性回归的梯度推导
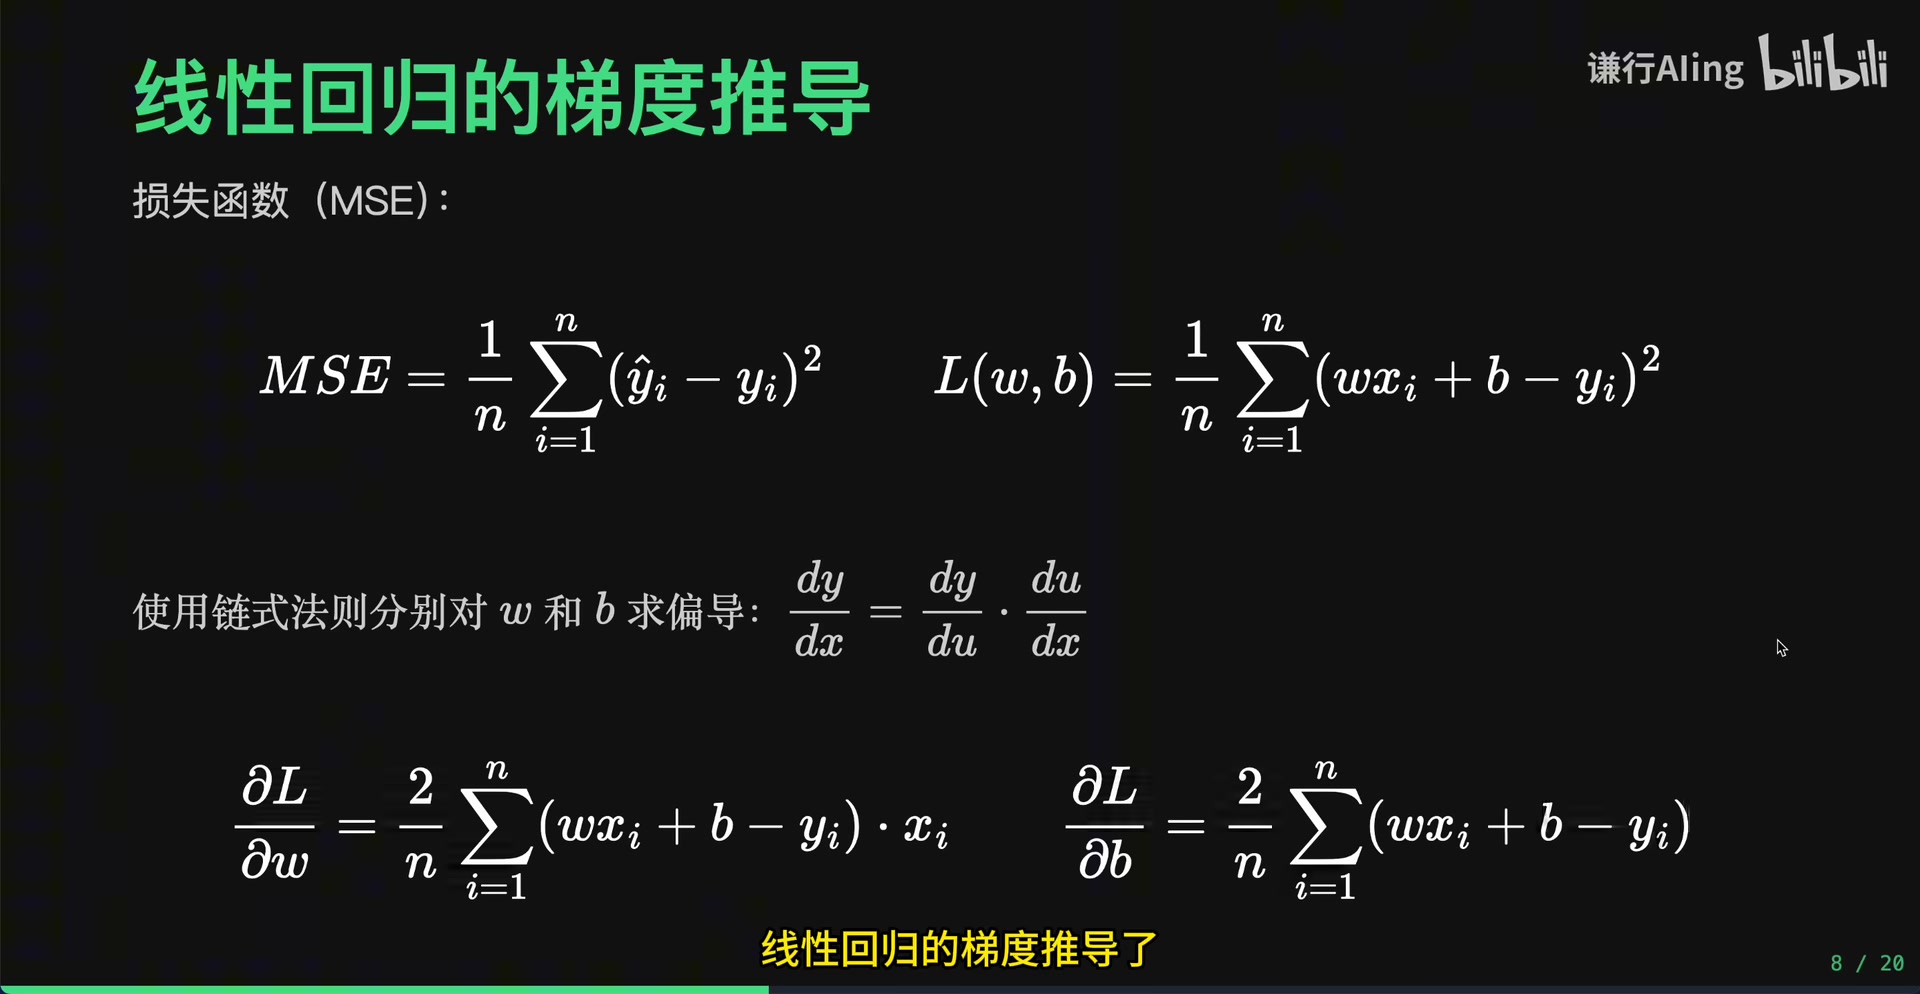
对于线性回归的 MSE 损失函数:
$$J(W, b) = \frac{1}{N} \sum_{i=1}^{N} (y_i - (Wx_i + b))^2$$
利用链式法则(Chain Rule),分别对 $W$ 和 $b$ 求偏导:
$$\frac{\partial J}{\partial W} = \frac{2}{N} \sum_{i=1}^{N} (\hat{y}_i - y_i) x_i$$
$$\frac{\partial J}{\partial b} = \frac{2}{N} \sum_{i=1}^{N} (\hat{y}_i - y_i)$$
注意:求导对象是损失函数,而非模型本身;$x_i$ 和 $y_i$ 在训练时作为已知样本被视为常数,变量仅为参数 $W$ 和 $b$。
 *
4.3 代码实现:房价预测
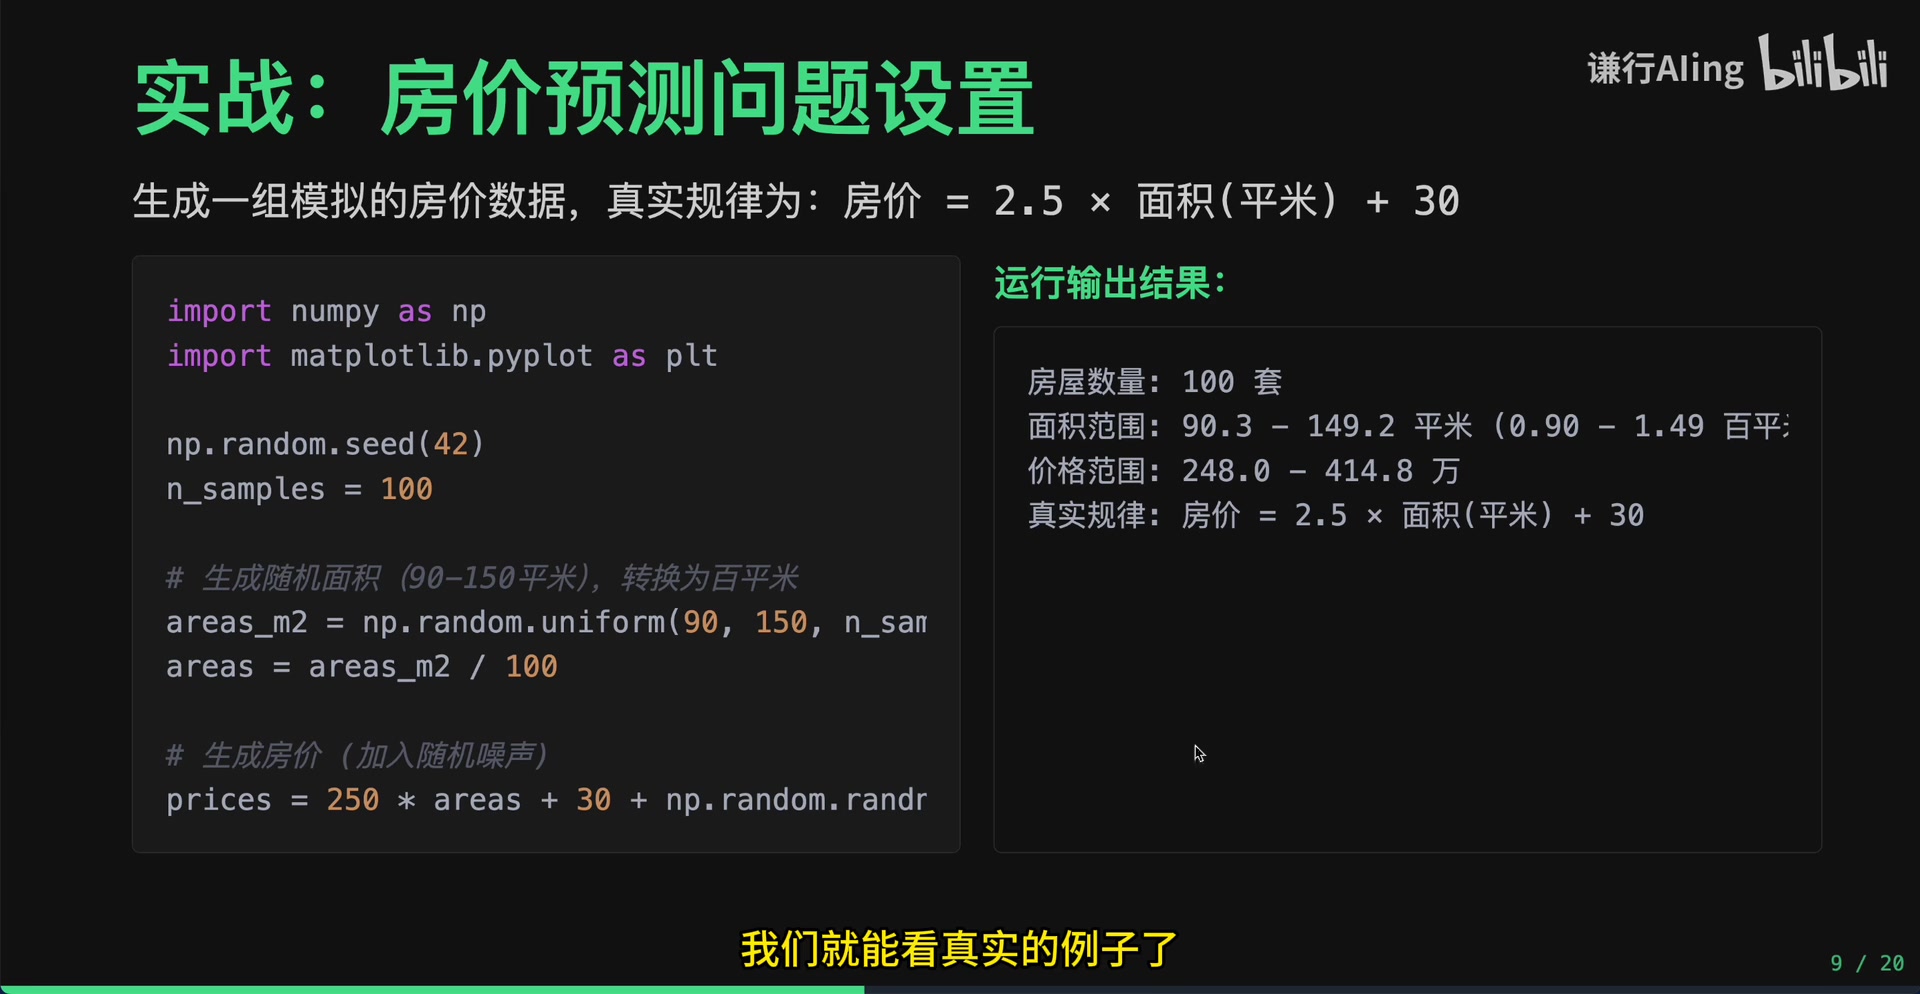
以下通过 NumPy 实现一个简单的梯度下降训练过程,拟合房价与面积的关系。
数据准备:
- 生成 100 套房屋的面积数据(范围 90–150 平方米)
- 为稳定梯度下降,将面积转换为”百平方米”(即 0.90–1.50)
- 真实规律设定为:$\text{price} = 2.5 \times \text{area} + 30$
训练设置:
- 初始参数:$W = 0$, $b = 0$
- 学习率:$\eta = 0.01$
- 训练轮数(Epoch):100,000
- 样本数 $N = 100$
核心训练循环:
# 预测值 |
训练结果:
- 训练 10 万轮后,得到 $W \approx 2.38$, $b \approx 43.6$
- 损失从初始的十万量级逐渐下降,后期下降趋于平缓
- 拟合直线虽不能完美预测所有点,但已能反映整体趋势
 *
可视化分析:
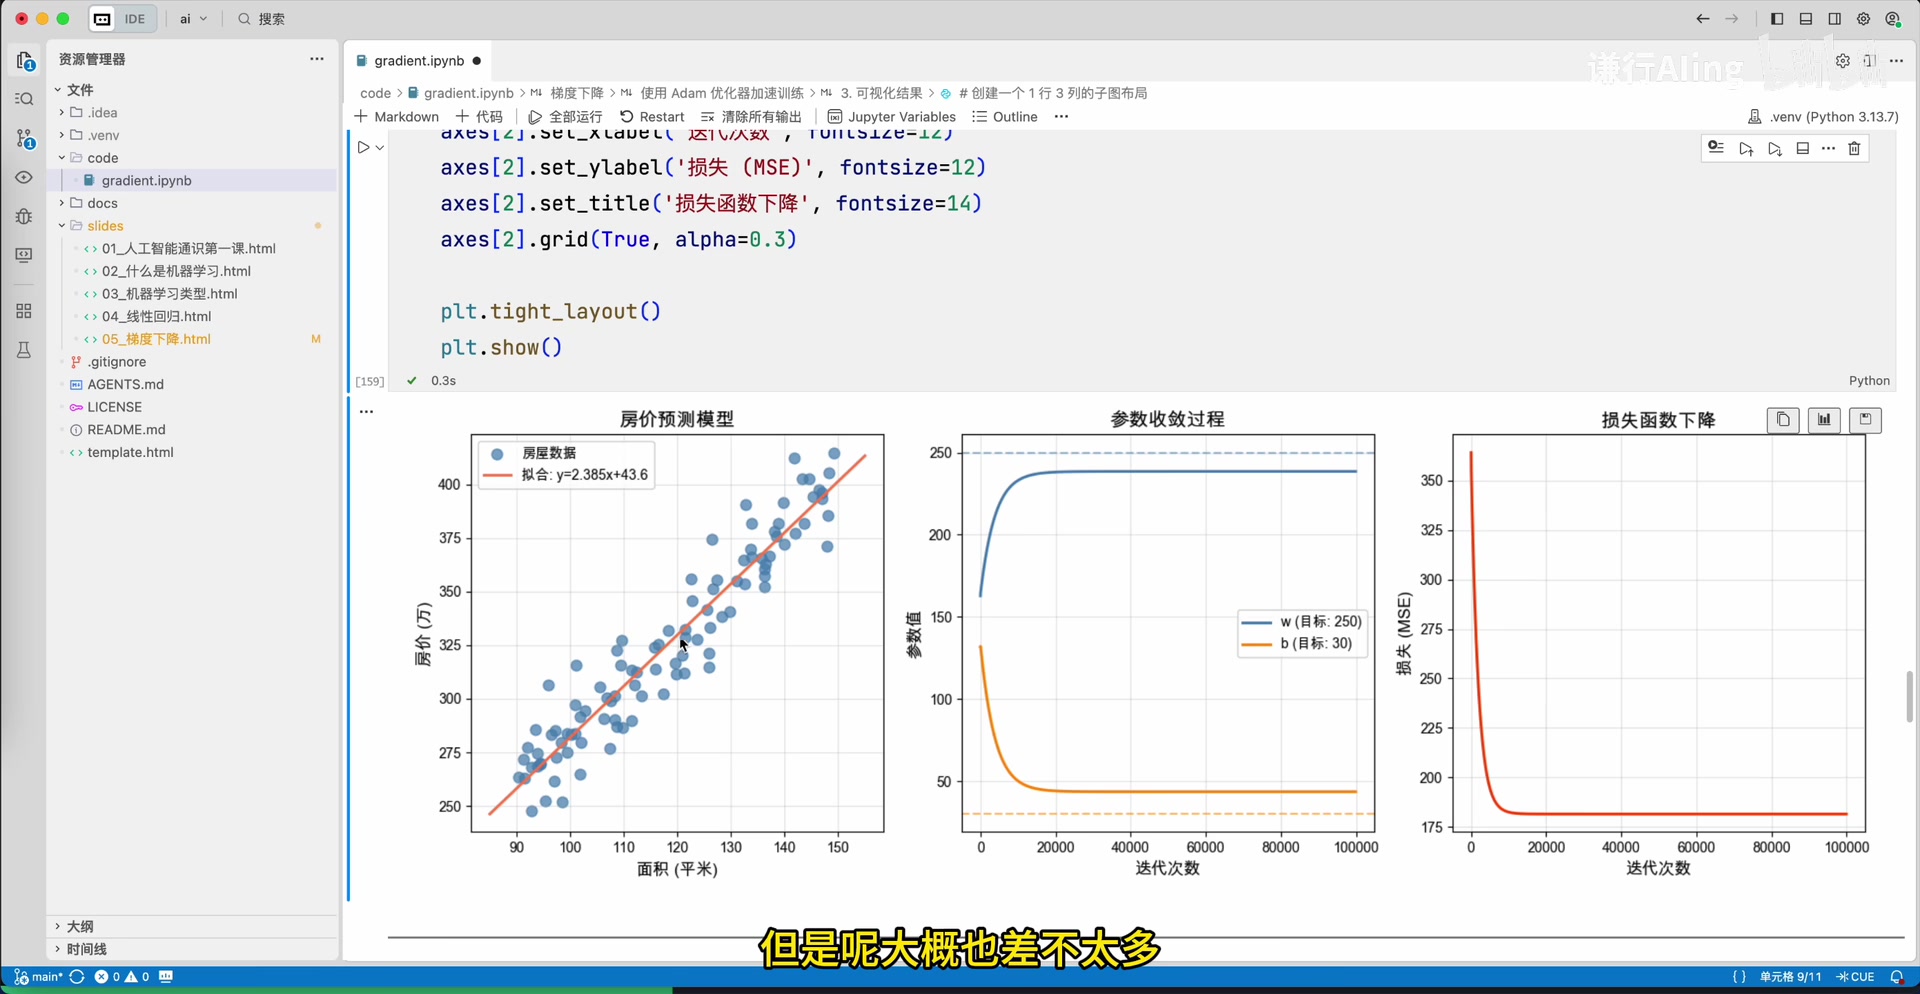 *
上图展示了拟合的直线与原始数据散点的关系。下图(参数收敛曲线)显示,随着训练轮数增加,$W$ 逐渐逼近真实值 2.5,$b$ 逼近 30,但后期收敛速度显著变慢。
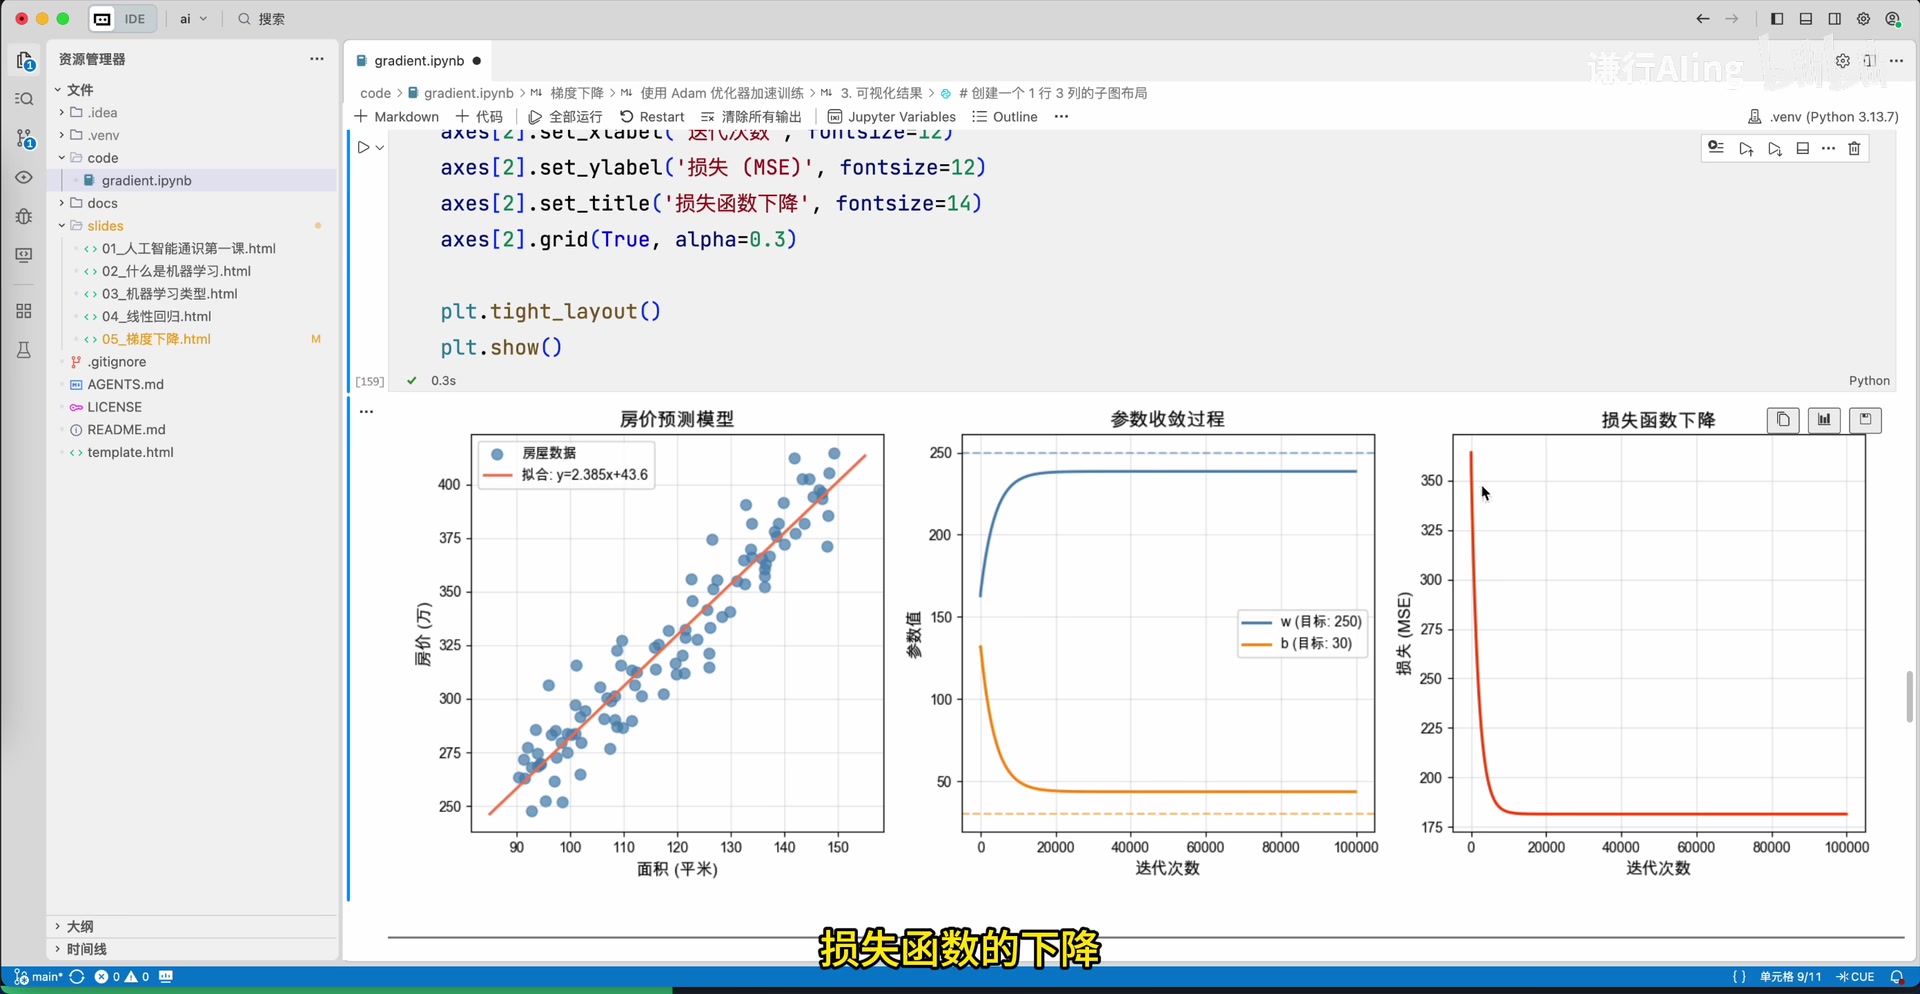 *
损失函数曲线表明:模型从”零分”提升到”60分”很快,但从”80分”到”90分”需要极长的训练时间,这是梯度下降的典型特征。
5. 学习率的影响
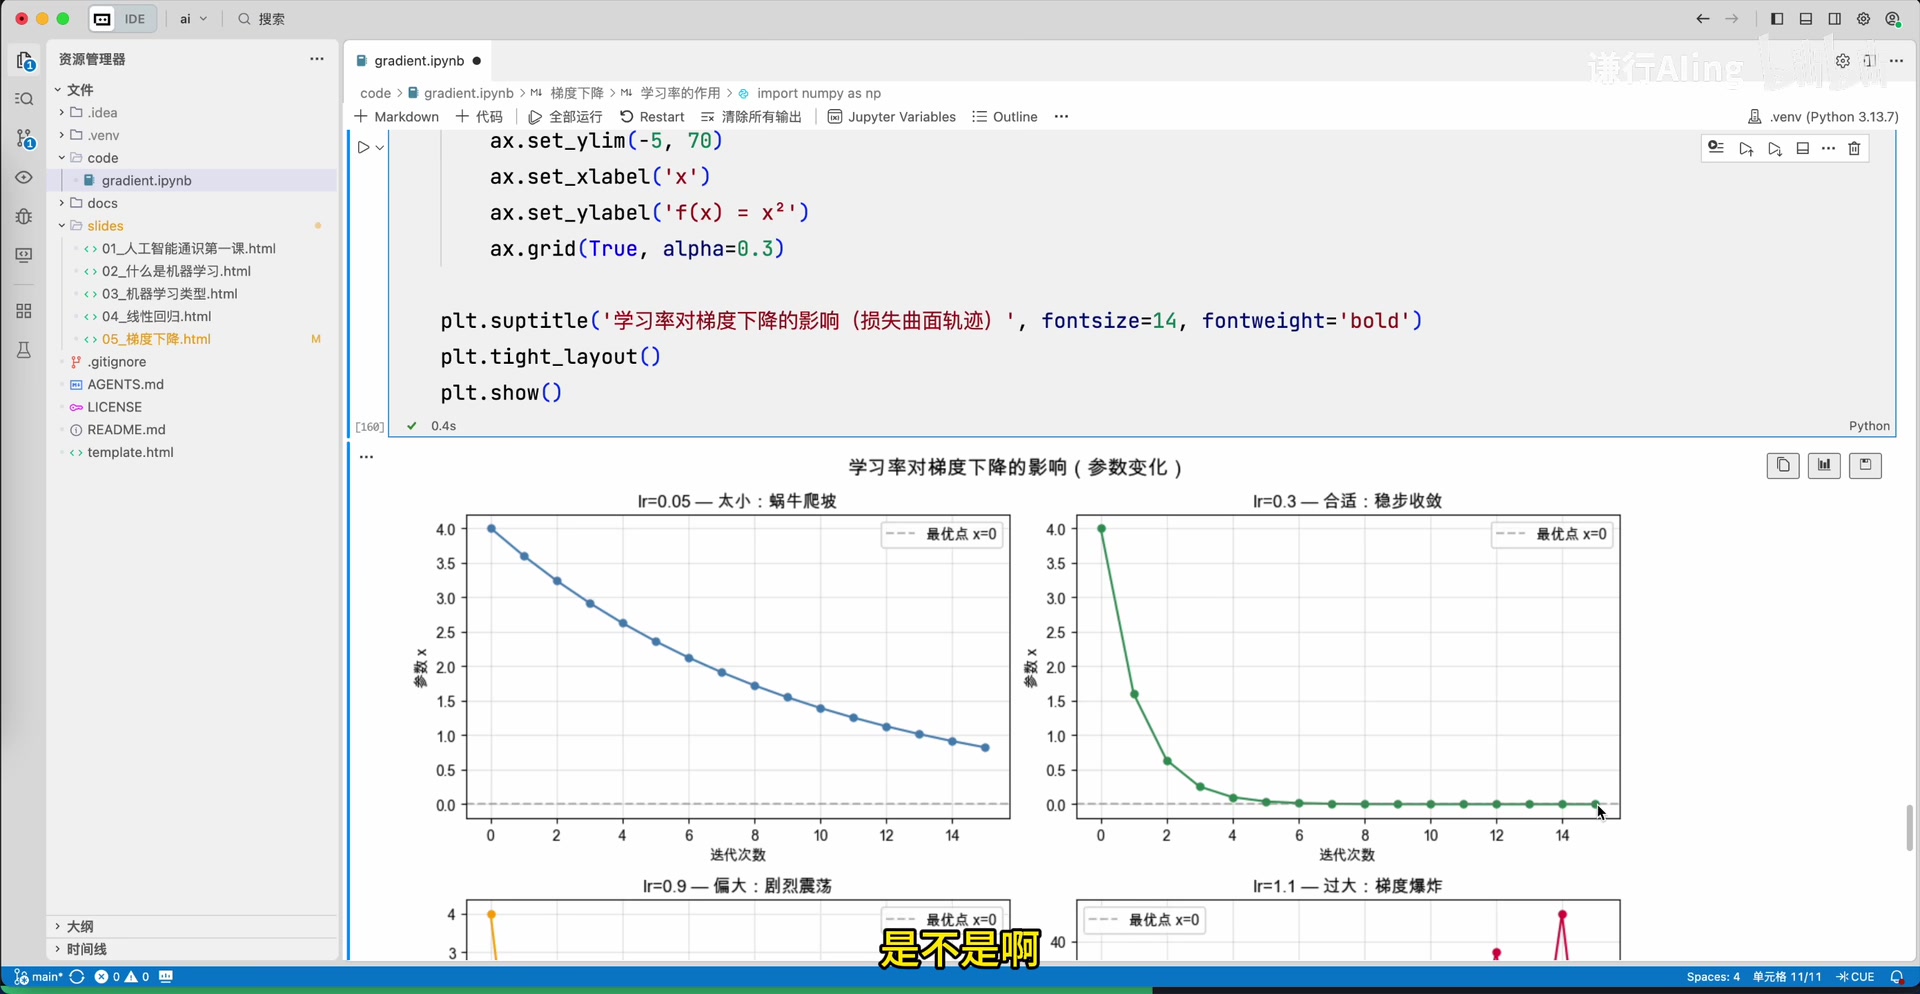
以拟合 $y = x^2$(最小值在 $x=0$)为例,对比不同学习率的表现:
| 学习率 | 现象描述 |
|---|---|
| $0.05$ | 步幅过小,15 轮内几乎无法收敛到最优解 |
| $0.3$ | 步幅适中,能快速且平稳地逼近零 |
| $0.9$ | 步幅过大,在最优解两侧来回震荡 |
| $1.1$ | 步幅极大,导致梯度爆炸(Gradient Explosion),参数发散 |
 *
结论:学习率必须谨慎选择。过大导致震荡或爆炸,过小则训练效率低下。此外,标准梯度下降还存在易陷入**局部最优(Local Minimum)**的风险。
 *
6. 优化器:从手动调参到自适应学习
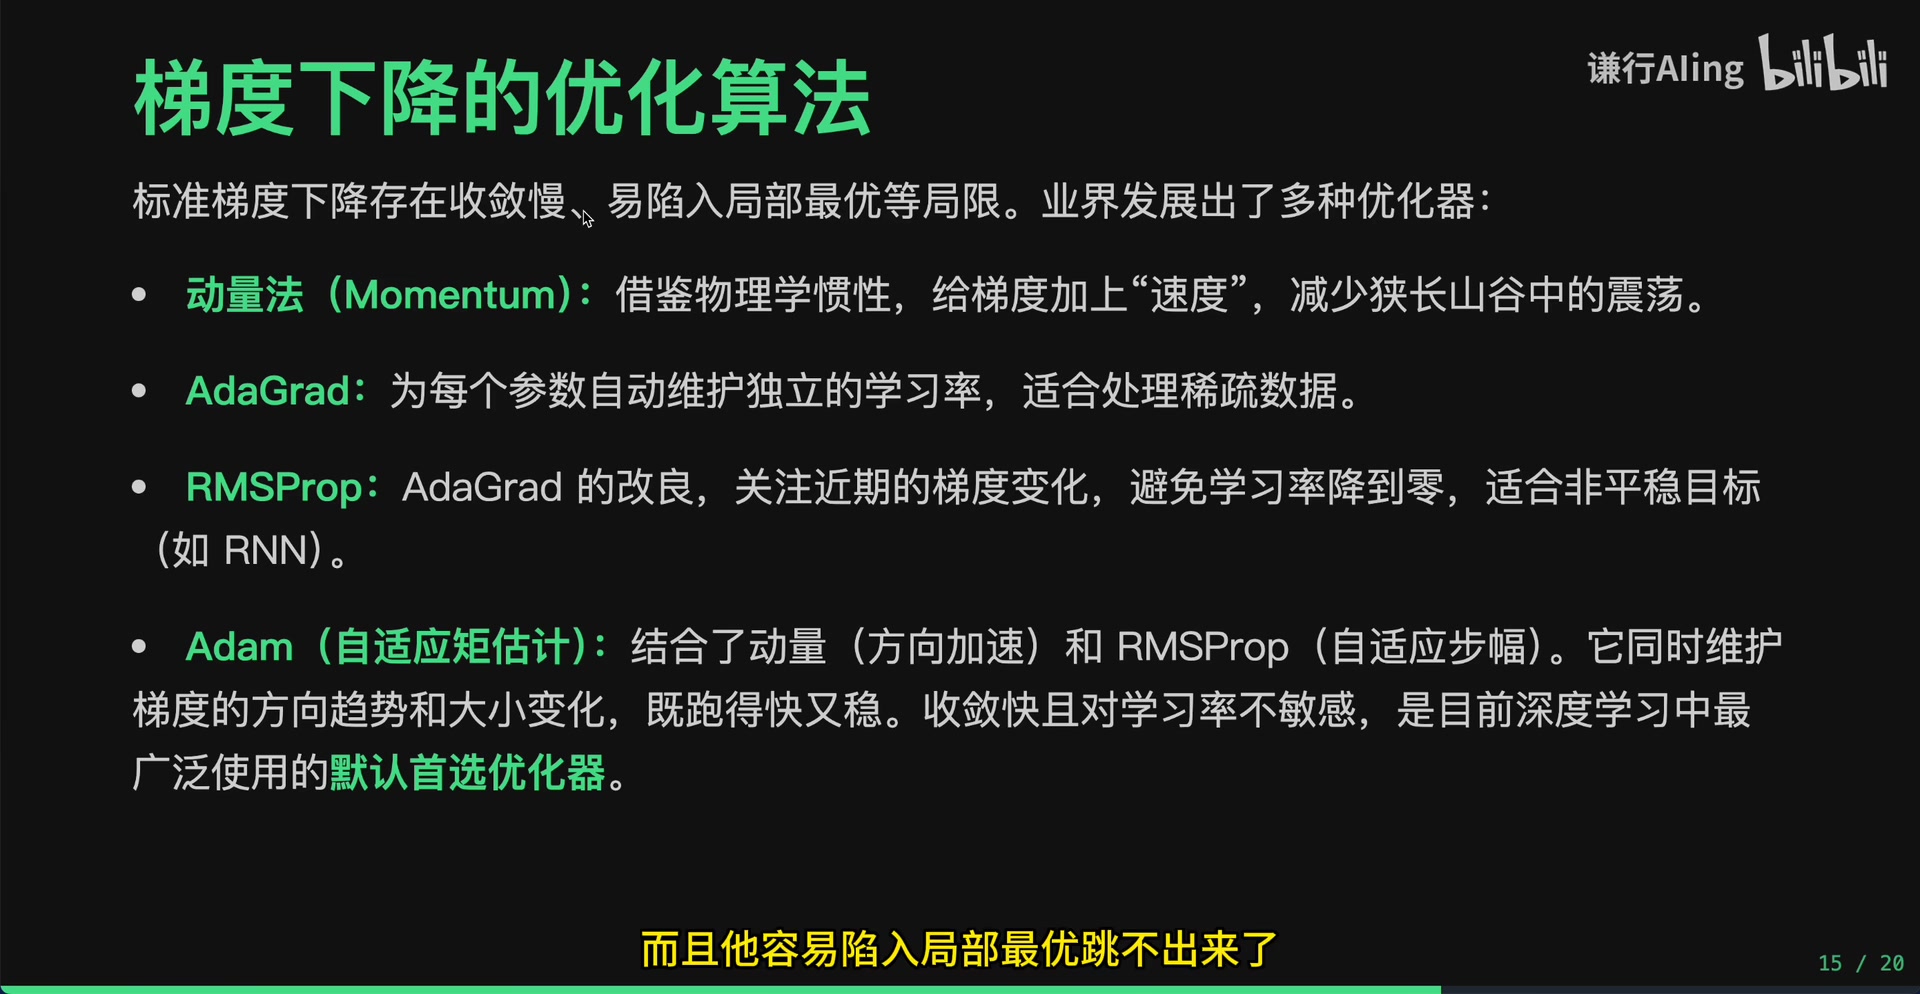
为解决标准梯度下降的缺陷,业界提出多种优化器,核心思路包括利用动量、自适应调整学习率等。
6.1 Momentum(动量法)
模拟物理学中的惯性概念,为梯度更新引入”速度”累加项。即使当前梯度很小,历史累积的动量也能帮助参数冲出局部最优的凹槽。
6.2 AdaGrad
核心思想是为每个参数维护独立的学习率。对于更新频繁(梯度累积大)的参数,学习率会自动衰减;对于更新稀疏的参数,则保持较大学习率。这解决了不同参数尺度差异大时单一学习率难以兼顾的问题。
6.3 RMSprop
对 AdaGrad 的改进。AdaGrad 可能因梯度无限累加而使学习率过早衰减至零。RMSprop 只关注近期梯度的平方均值,更适合非平稳目标函数。
6.4 Adam(Adaptive Moment Estimation)
结合了 Momentum 和 RMSprop 的优点:
- 既沿梯度方向做加速(一阶矩估计)
- 又自适应调整各参数的学习率(二阶矩估计)
优势:
- 收敛速度快且稳定
- 对学习率初始值不敏感,大幅减少人工调参成本
- 目前已成为深度学习和大模型训练的默认优化器
 *
效果对比:
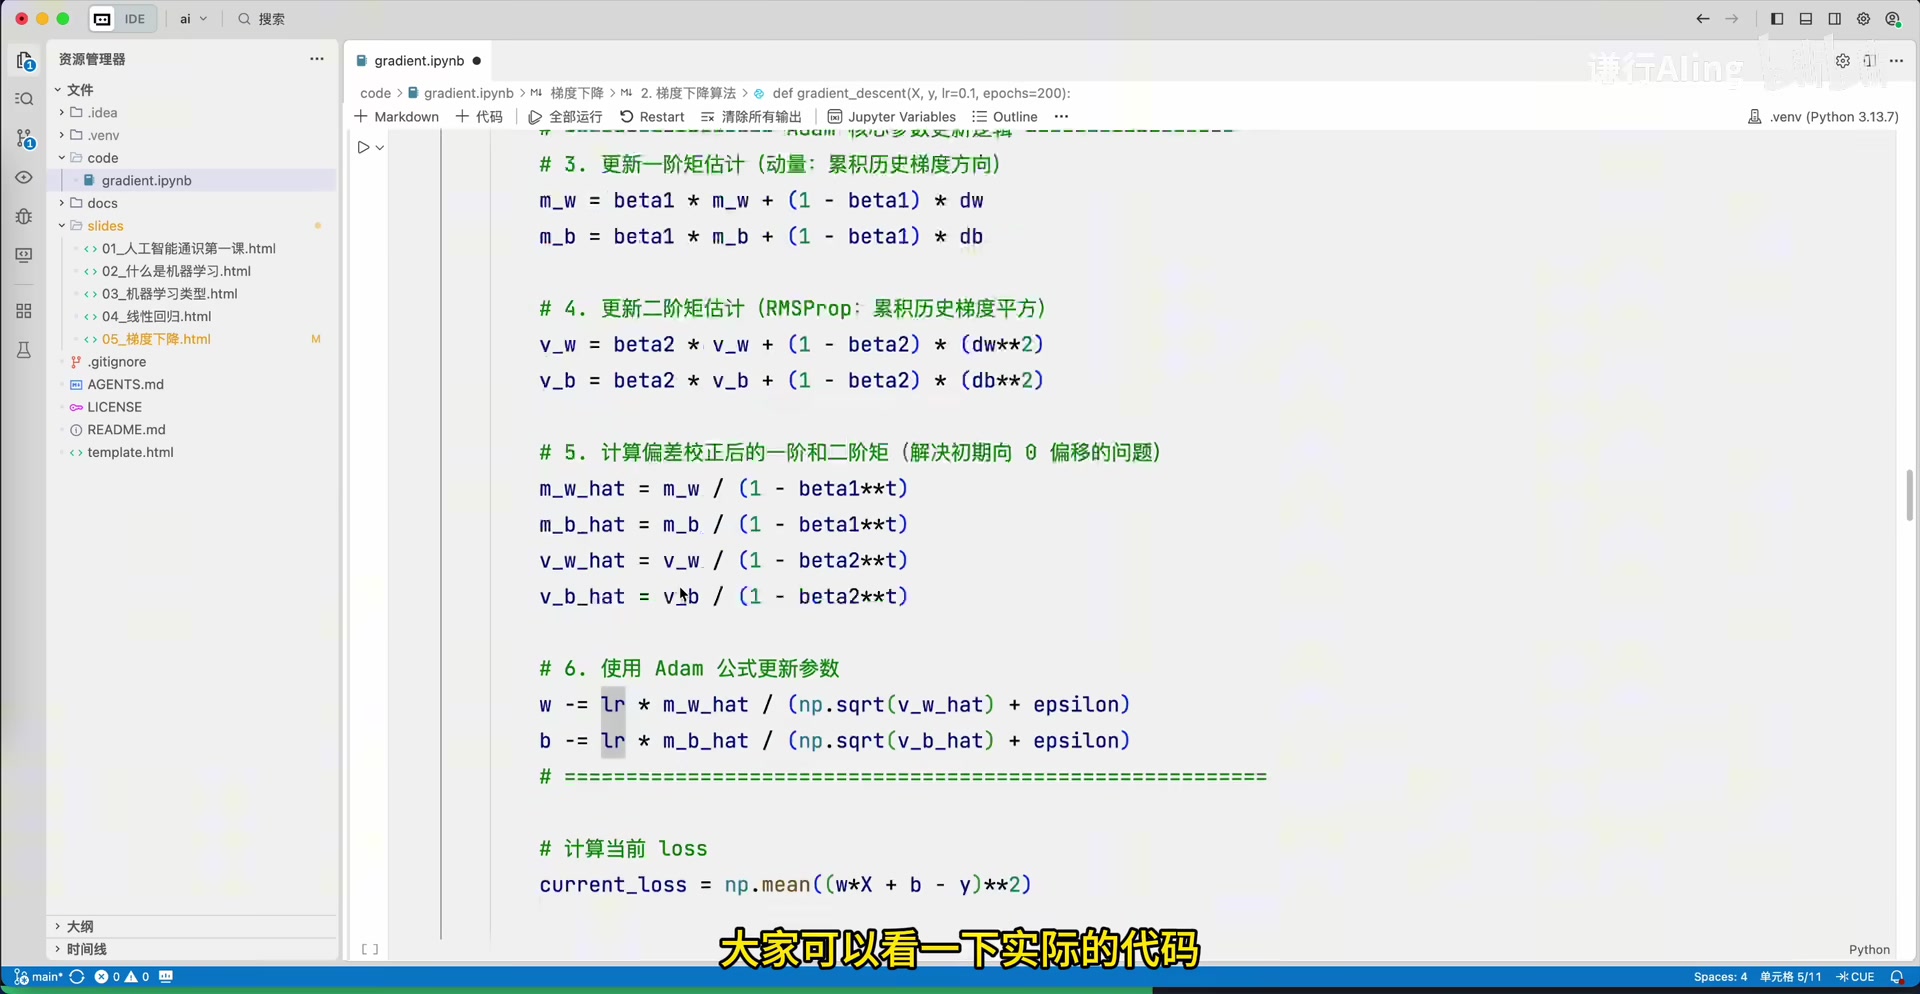
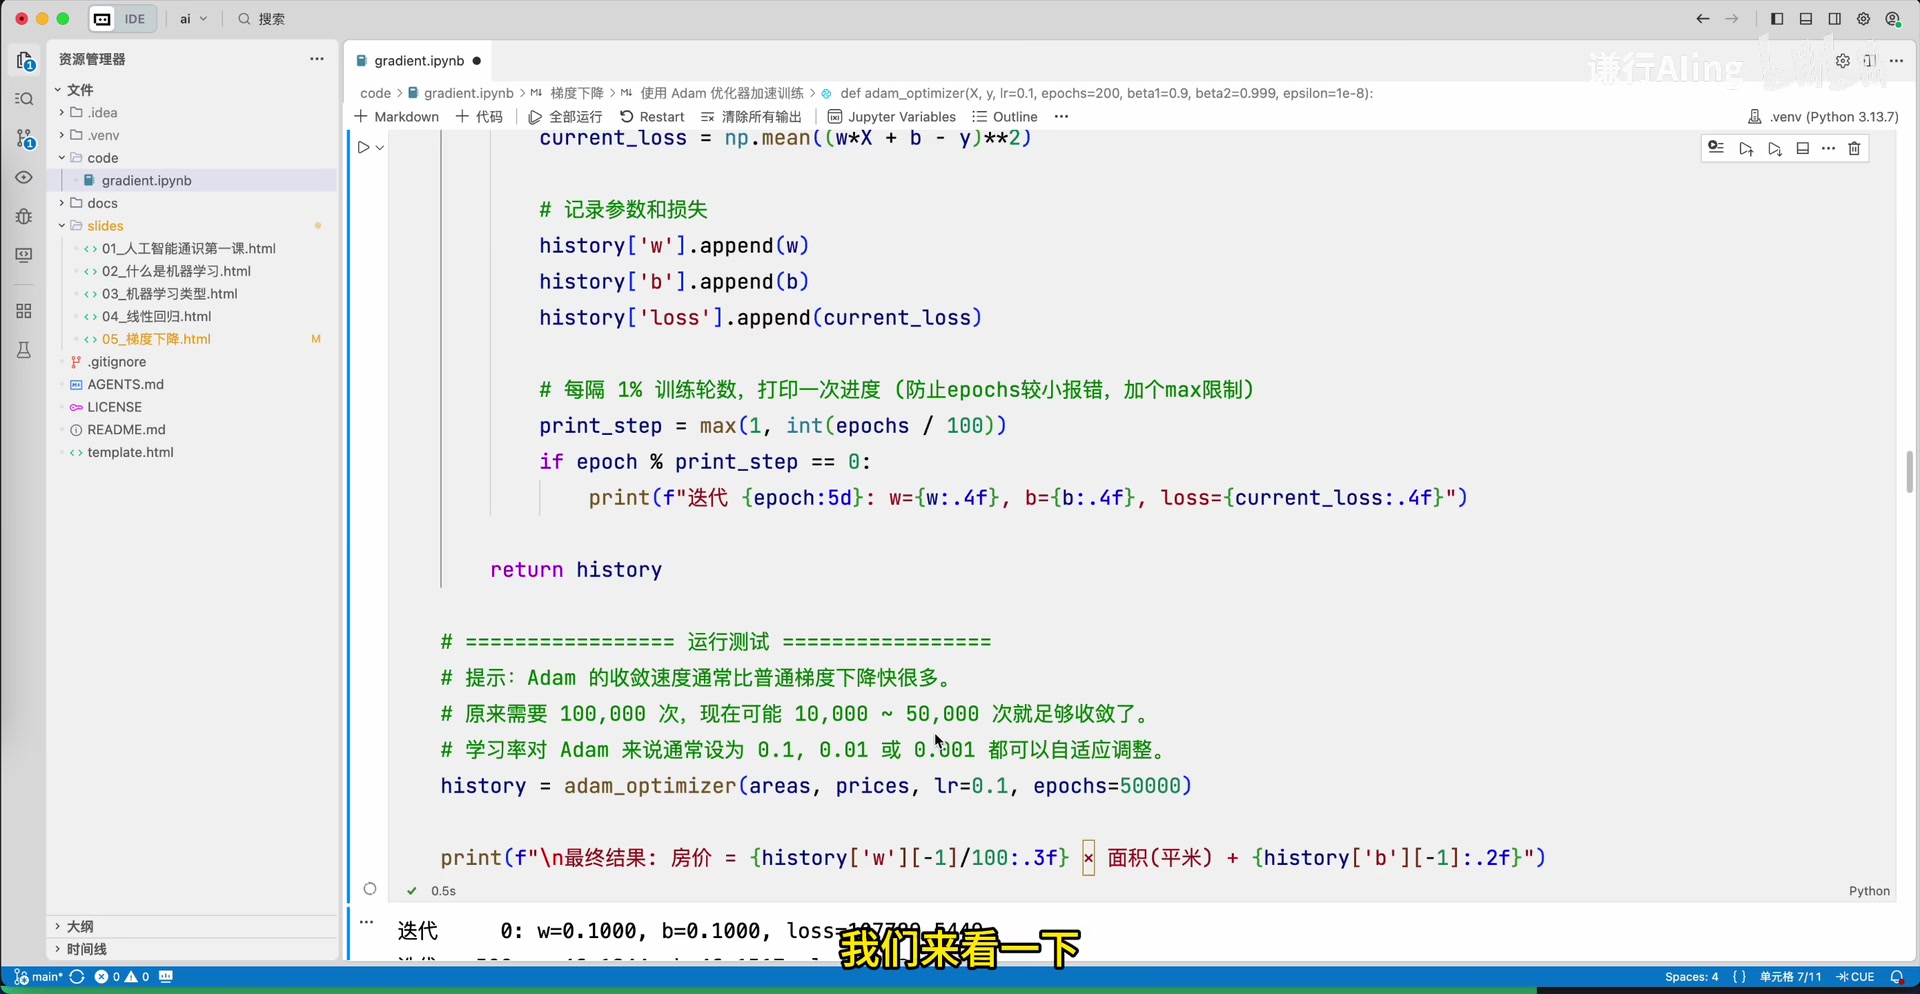
使用 Adam 优化器重新训练房价预测模型,仅需约 5,000–15,000 轮即可达到与标准梯度下降 10 万轮相近的精度,效率提升显著。
 *
7. 随机梯度下降与小批量训练
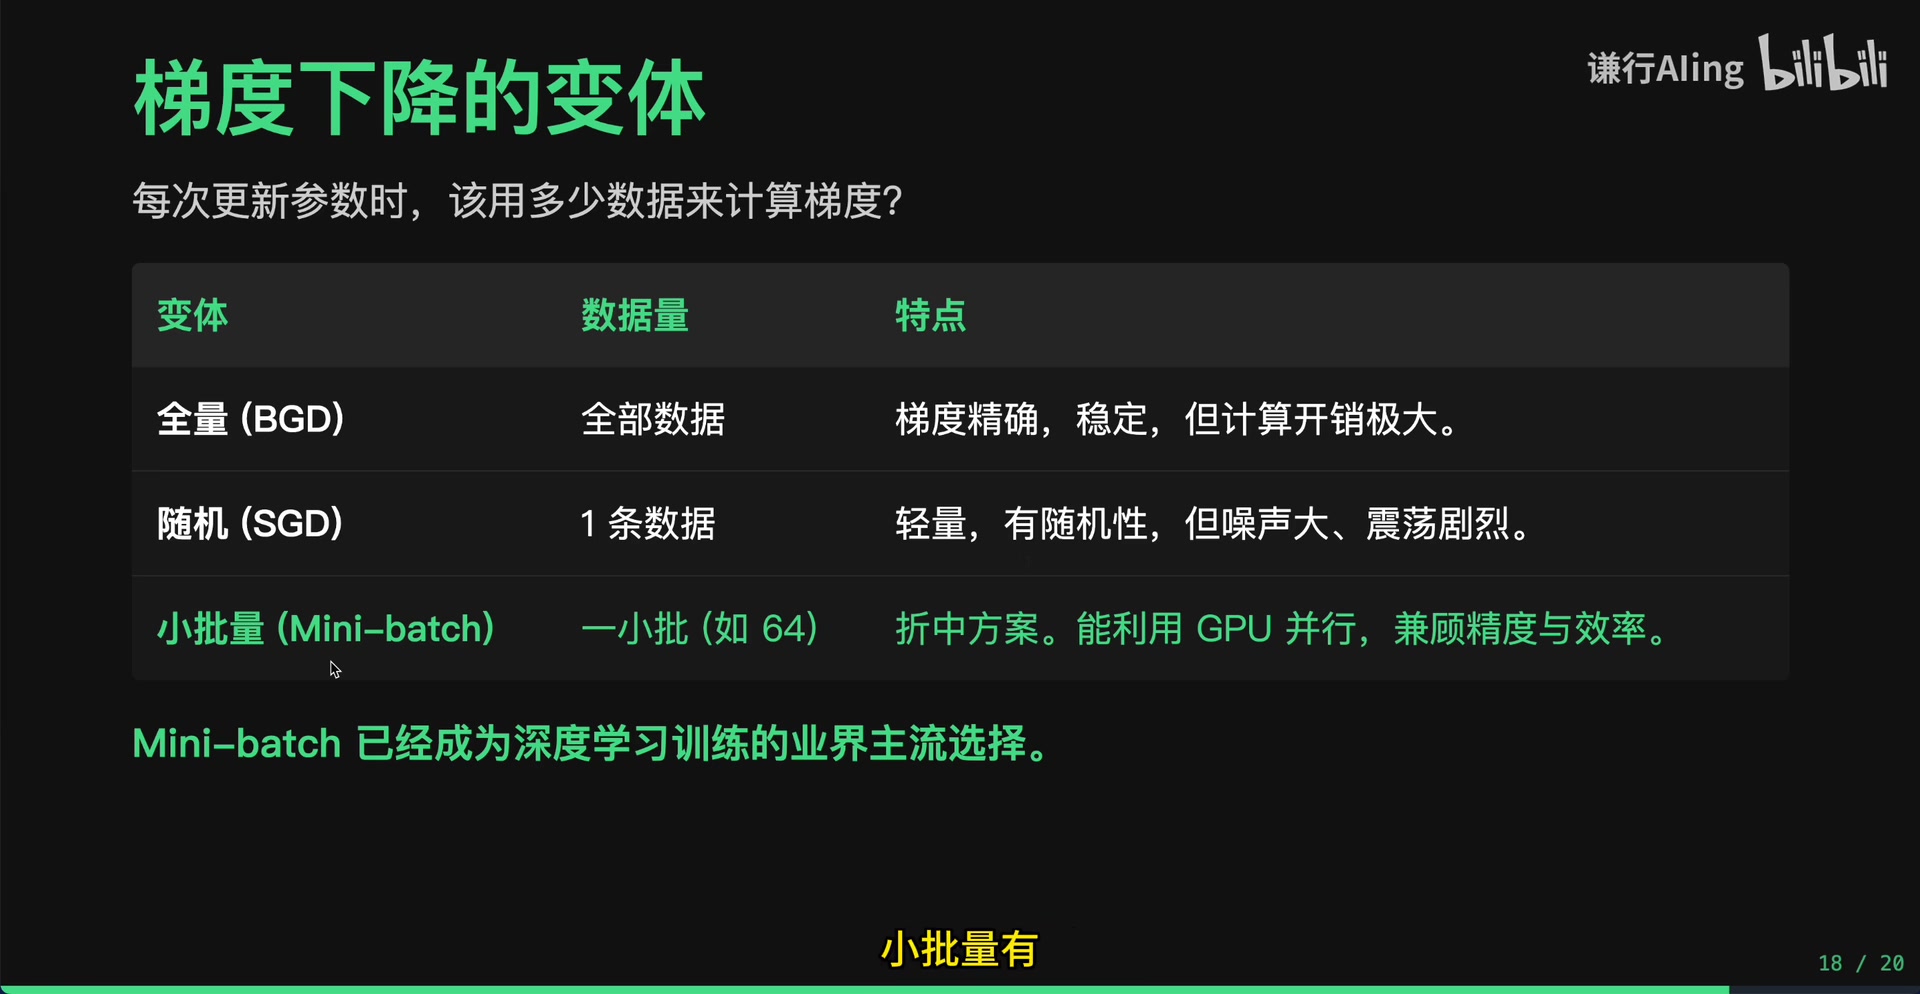
梯度下降在工业应用中还需考虑计算成本。根据每次计算梯度所用样本量的不同,分为三种形式:
7.1 批量梯度下降(Batch Gradient Descent)
使用全部训练样本计算梯度。梯度估计精确稳定,但数据量大时计算开销极高,训练速度缓慢。
7.2 随机梯度下降(Stochastic Gradient Descent, SGD)
每次随机选取单个样本计算梯度。计算极快,但单个样本的噪声会导致训练过程剧烈震荡,收敛不稳定。
7.3 小批量梯度下降(Mini-batch Gradient Descent)
每次随机选取一小批样本(如 64、128 个)计算梯度。这是精度与效率的折中方案:
- 梯度估计比单样本更稳定
- 能充分利用 GPU 的并行计算能力
- 是深度学习训练的主流选择
在实际语境中,提到的 SGD 往往默认指 Mini-batch SGD。
 *
8. 总结
 *
- 损失函数:度量预测值与真实值之间的差距,是优化的目标。训练的核心即最小化损失函数。
- 梯度:由损失函数对各参数的偏导数组成的向量,指向函数值增长最快的方向。
- 梯度下降:参数沿梯度的反方向更新,并乘以学习率 $\eta$ 控制步幅。
- 学习率:过大导致震荡或梯度爆炸,过小导致收敛缓慢。可通过优化器(尤其是 Adam)实现自适应调整。
- Mini-batch:在每次迭代中使用小批量样本(如 64、128 条)计算梯度,平衡计算精度与训练效率。
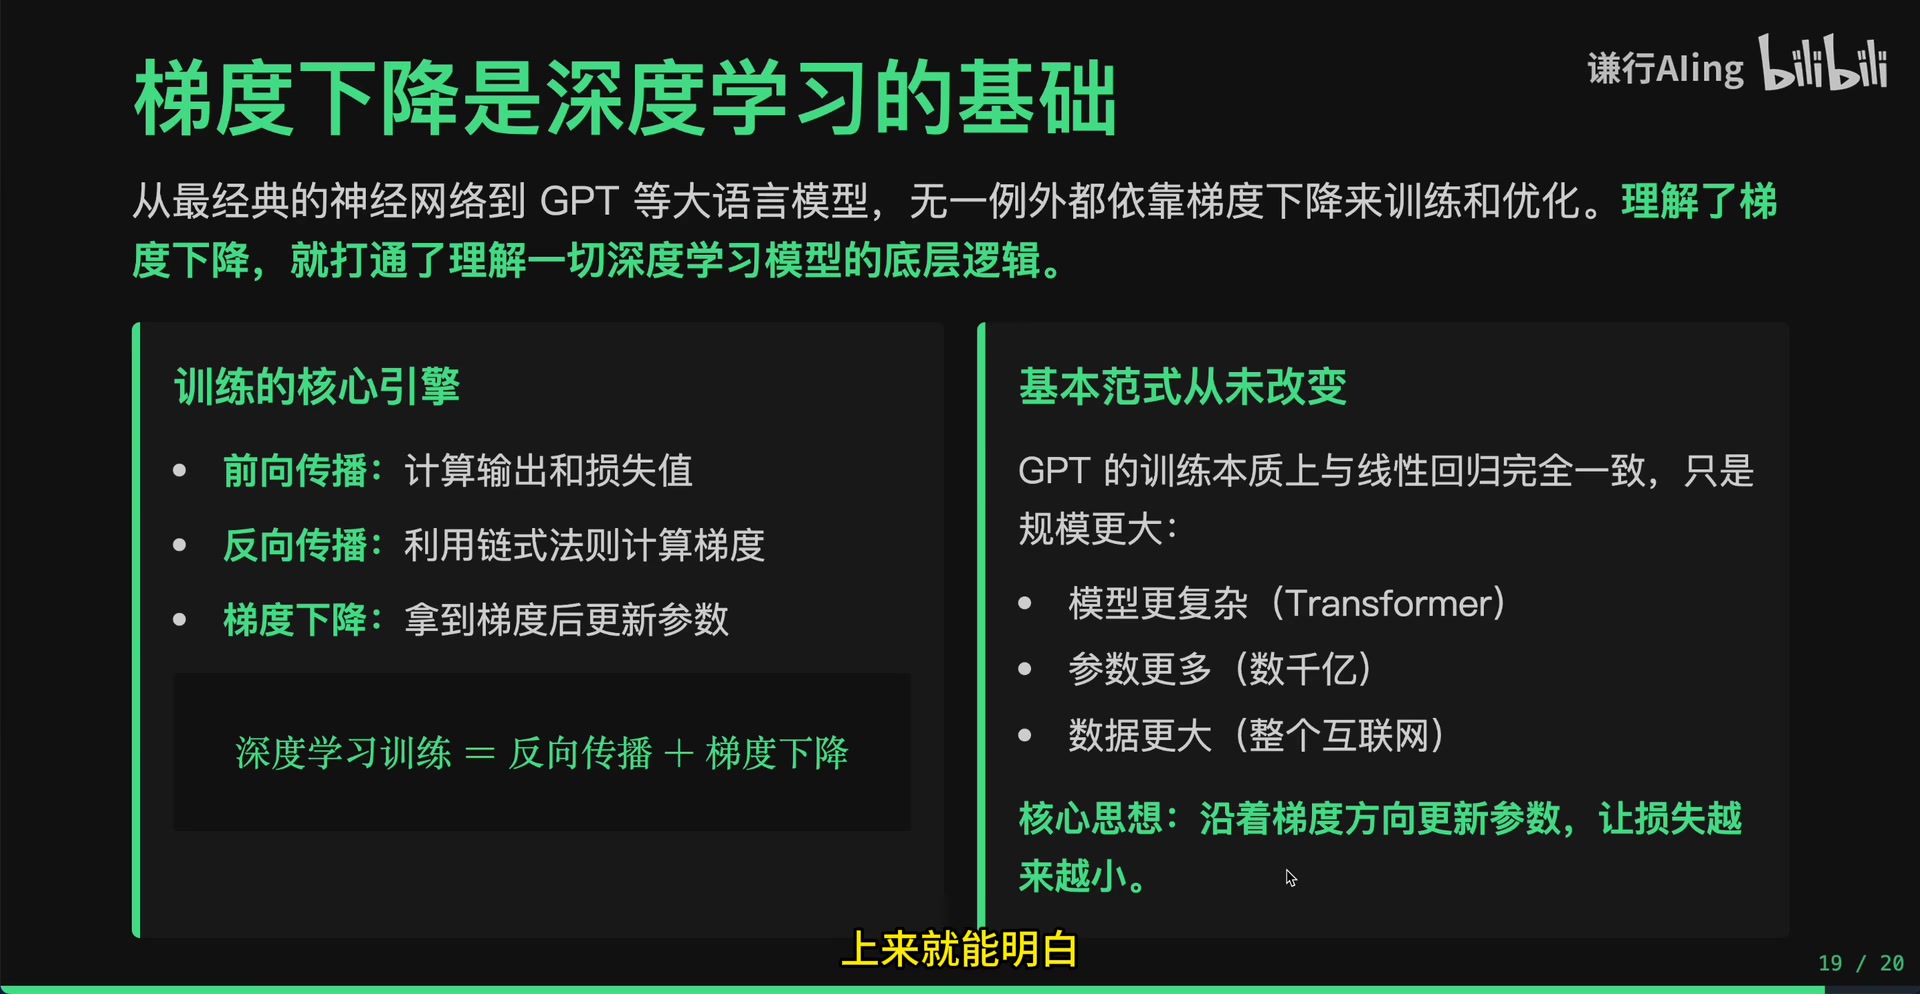
- 核心价值:梯度下降不仅是传统机器学习的基石,也是深度学习反向传播(Backpropagation)及大模型(如 GPT)训练的核心原理。掌握其机制,有助于理解更复杂的神经网络训练过程。
refer
-
声明:
若文章存在错误,望诸君不吝指正^
blog仅供个人记录学习所用部分笔记由于年代久远,做的笔记找不到最初是引用谁的,若是不允许引用转载,请联系我