
3-机器学习类型:监督学习、非监督学习、强化学习
1. 垃圾邮件分类模型迭代过程
本部分通过判断朋友发送的邮件是否为垃圾邮件的生活化案例,逐步迭代模型,演示机器学习的底层逻辑。
1. 模型V1.0:纯概率盲猜 *
- 逻辑:统计历史10封邮件中有6封是垃圾邮件,直接判定新邮件有60%概率为垃圾邮件
- 缺陷:完全没有利用邮件本身的特征,精度极低,仅做基准参考
1. 模型V2.0:单特征规则判断 *
- 引入第一个特征:邮件发送时间
- 规则:工作日发送=正常邮件,周末发送=垃圾邮件
- 逻辑:观察历史数据发现,对方周末发送的几乎都是垃圾邮件
- 缺陷:规则过于绝对,会误杀周末发送的正常邮件(例如活动通知、徒步邀约)
1. 模型V3.0:多特征组合规则 *
- 新增第二个特征:邮件附件大小
- 规则:如果是周末发送 且 附件大小>10KB → 判定为垃圾邮件,否则为正常邮件
- 效果:成功拦截带大附件的广告邮件,同时保留了周末发送的小体积正常通知邮件
- 优势:引入多维度特征,判断精度得到显著提升
2. 机器学习核心逻辑
 *
2.1 核心概念定义
- 特征(Feature):用于做出判断的相关维度,例如本案例中的发送时间、邮件大小、标题是否包含”免费”等,都是判断是否为垃圾邮件的依据。
- 权重(Weight):不同特征对最终结果的影响程度,例如标题包含”免费中奖”对垃圾邮件的指示性远强于发送时间,因此会分配更高的权重。
人和机器的核心差异:人类一次最多只能处理3~5个特征,而计算机可以同时分析上百万封邮件、上万种特征,这也是机器学习判断精度可以远超人工的核心原因。
2.2 机器判断逻辑
机器学习通过加权求和计算垃圾邮件得分,公式如下:
$$ 得分 = w_1 \times 周末特征 + w_2 \times 附件大小特征 + w_3 \times 包含免费特征 + …$$
- 权重示例:
- 标题包含”免费”:权重+50分(强特征)
- 附件大于10KB:权重+30分(中强特征)
- 判定规则:总得分>60 → 判定为垃圾邮件
- 核心逻辑:不再使用非黑即白的硬规则判断,而是通过打分量化概率;特征命中越多、特征指示性越强,得分越高,对应结果的概率就越高。
2.3 机器学习的核心目标
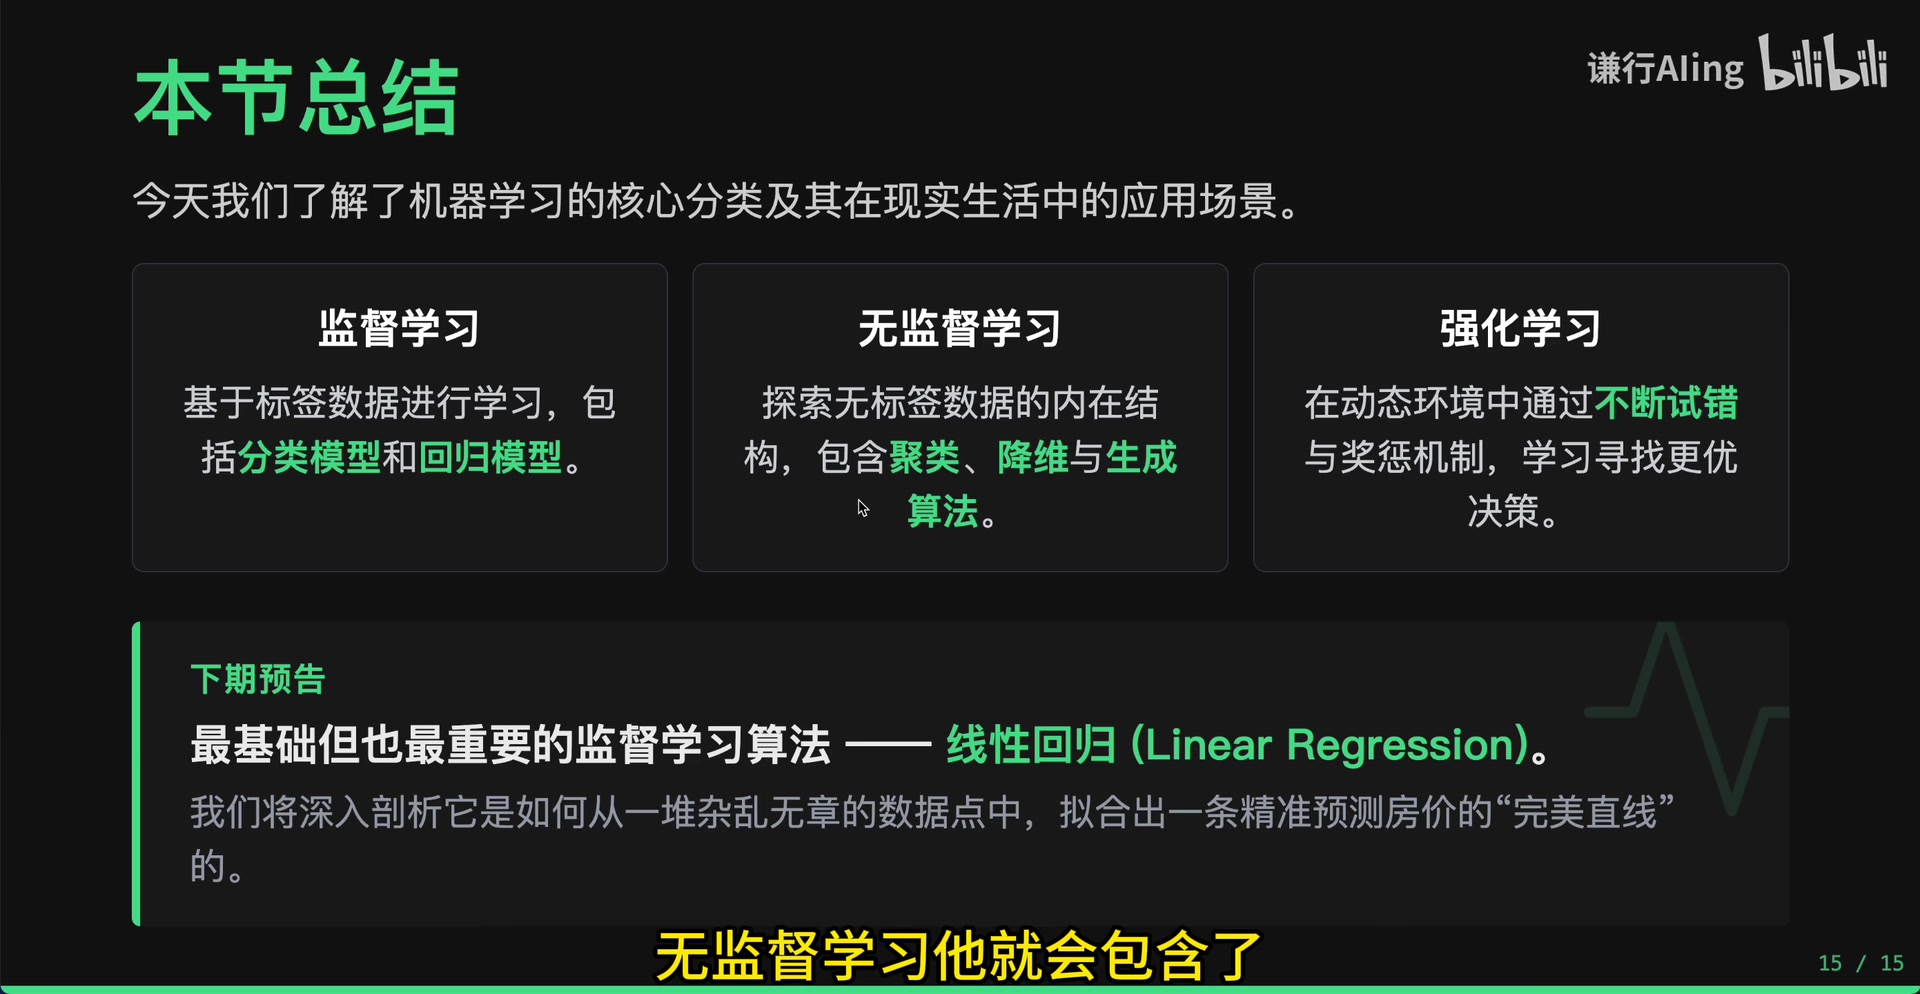 *
机器学习的核心问题:如何精准确定每一个特征的最优权重?
机器学习的完整过程:
将大量已经标注好类别的历史数据输入计算机,让程序自动不断调整每个特征的权重数值,最终找到一组可以让判断准确率最高的权重组合。这个自动寻找最优权重的过程,就是机器学习。
3. 机器学习前置知识要求
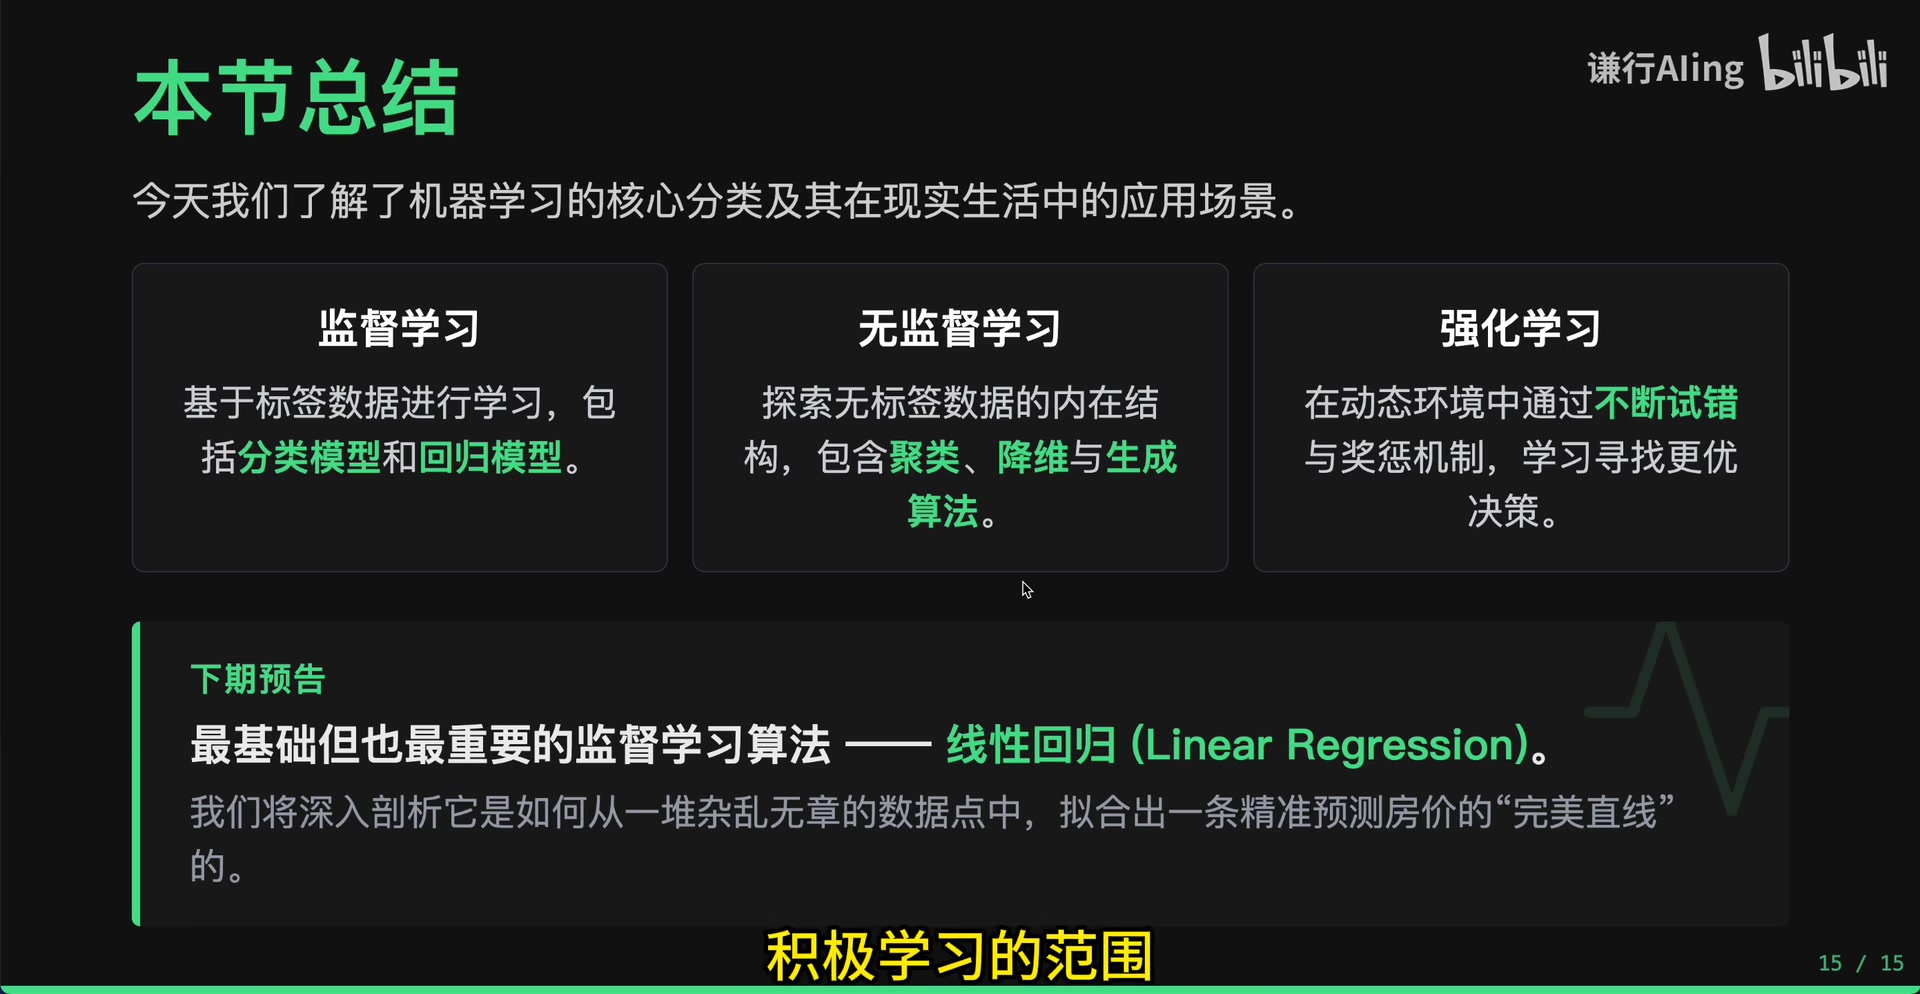 *
说明:仅需要掌握基础即可,无需成为数学或编程专家,课程会对用到的理论做即时通俗讲解。
3.1 数学基础要求
- 线性代数:掌握向量、矩阵的基础概念,以及加减、点积、乘法运算即可。
- 概率与统计:掌握均值、方差、常见概率分布、贝叶斯定理的基础含义即可。
- 微积分:理解导数、偏导数的含义,以及链式法则即可。
3.2 编程技能要求
- Python:机器学习领域的事实标准语言,掌握基础语法即可。
- Jupyter Notebook:适合边写代码边做实验、数据可视化的开发环境。
- 常用工具库:
- NumPy/Pandas:用于数据处理
- Matplotlib/Seaborn:用于数据可视化
- Scikit-learn:经典机器学习算法库,开箱即用
AI总结
本视频通过垃圾邮件分类的生活化案例,由浅入深拆解了机器学习的核心本质,消除了机器学习的神秘感:
- 机器学习的判断逻辑本质是对多个特征做加权打分,得分超过阈值就做出对应判断,和人类做决策的逻辑完全一致;
- 机器学习的核心工作,就是让计算机从大量标注好的历史数据中自动调整参数,找到每个特征的最优权重组合,无需人工手写所有判断规则;
- 入门机器学习不需要精通高等数学和编程,只需要掌握基础的Python能力和数理知识就可以开始学习,复杂的理论可以在用到的时候再逐一理解。
这个讲解非常适合新手建立对机器学习的整体认知,理解”机器学习到底在做什么”这个最核心的问题。
refer
-
声明:
若文章存在错误,望诸君不吝指正^
blog仅供个人记录学习所用部分笔记由于年代久远,做的笔记找不到最初是引用谁的,若是不允许引用转载,请联系我
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 晚上十一点睡觉のBlog!
相关推荐
2026-06-18
2-机器学习是什么:通过数据学习规律,对未来预测
机器学习入门笔记:AI、机器学习与深度学习的概念辨析,传统编程写死规则的局限与机器学习从数据学规律做预测的解决思路,澄清 AI 时代仍需编程的常见误区。
2026-06-18
5-梯度下降——模型如何自己学会找最优参数
梯度下降详解:模型训练的本质是参数搜索,从导数、偏导与梯度的几何意义到参数更新公式与学习率影响,覆盖 Momentum/AdaGrad/RMSprop/Adam 优化器演进与 SGD 小批量实践。
2026-06-18
1-人工智能通识-什么是智能?智能从何而来?
人工智能通识第一课:智能的本质是学习能力与迁移泛化能力的结合,AI/机器学习/深度学习的层级包含关系与传统编程的局限,为入门者建立体系化的概念认知框架。
2026-06-18
6-数据预处理全攻略
数据预处理全攻略:Garbage In Garbage Out 原则下的完整流程——EDA 探索分析、重复/缺失/异常值清洗、特征编码与工程、标准化归一化缩放,到 scikit-learn Pipeline 自动化落地。
2026-06-18
4-线性回归——机器学习的第一个模型
线性回归入门:机器学习的第一个模型,从房价案例到 wx+b 模型表达、MSE 损失函数、梯度下降训练流程,再到多元扩展、多项式回归与逻辑回归等延伸方向。
2026-08-11
AI Agent Skill 平台调研与查找策略
AI Agent Skill 平台调研与查找策略(2026-08-11):主流 skill 平台使用方式/安装命令/评估标准汇总,形成找 skill → 评估 → 安装统一流程。
评论




