2-机器学习是什么:通过数据学习规律,对未来预测
机器学习入门第一课笔记
1. 核心概念:AI、机器学习、深度学习
1.1 人工智能(Artificial Intelligence, AI)
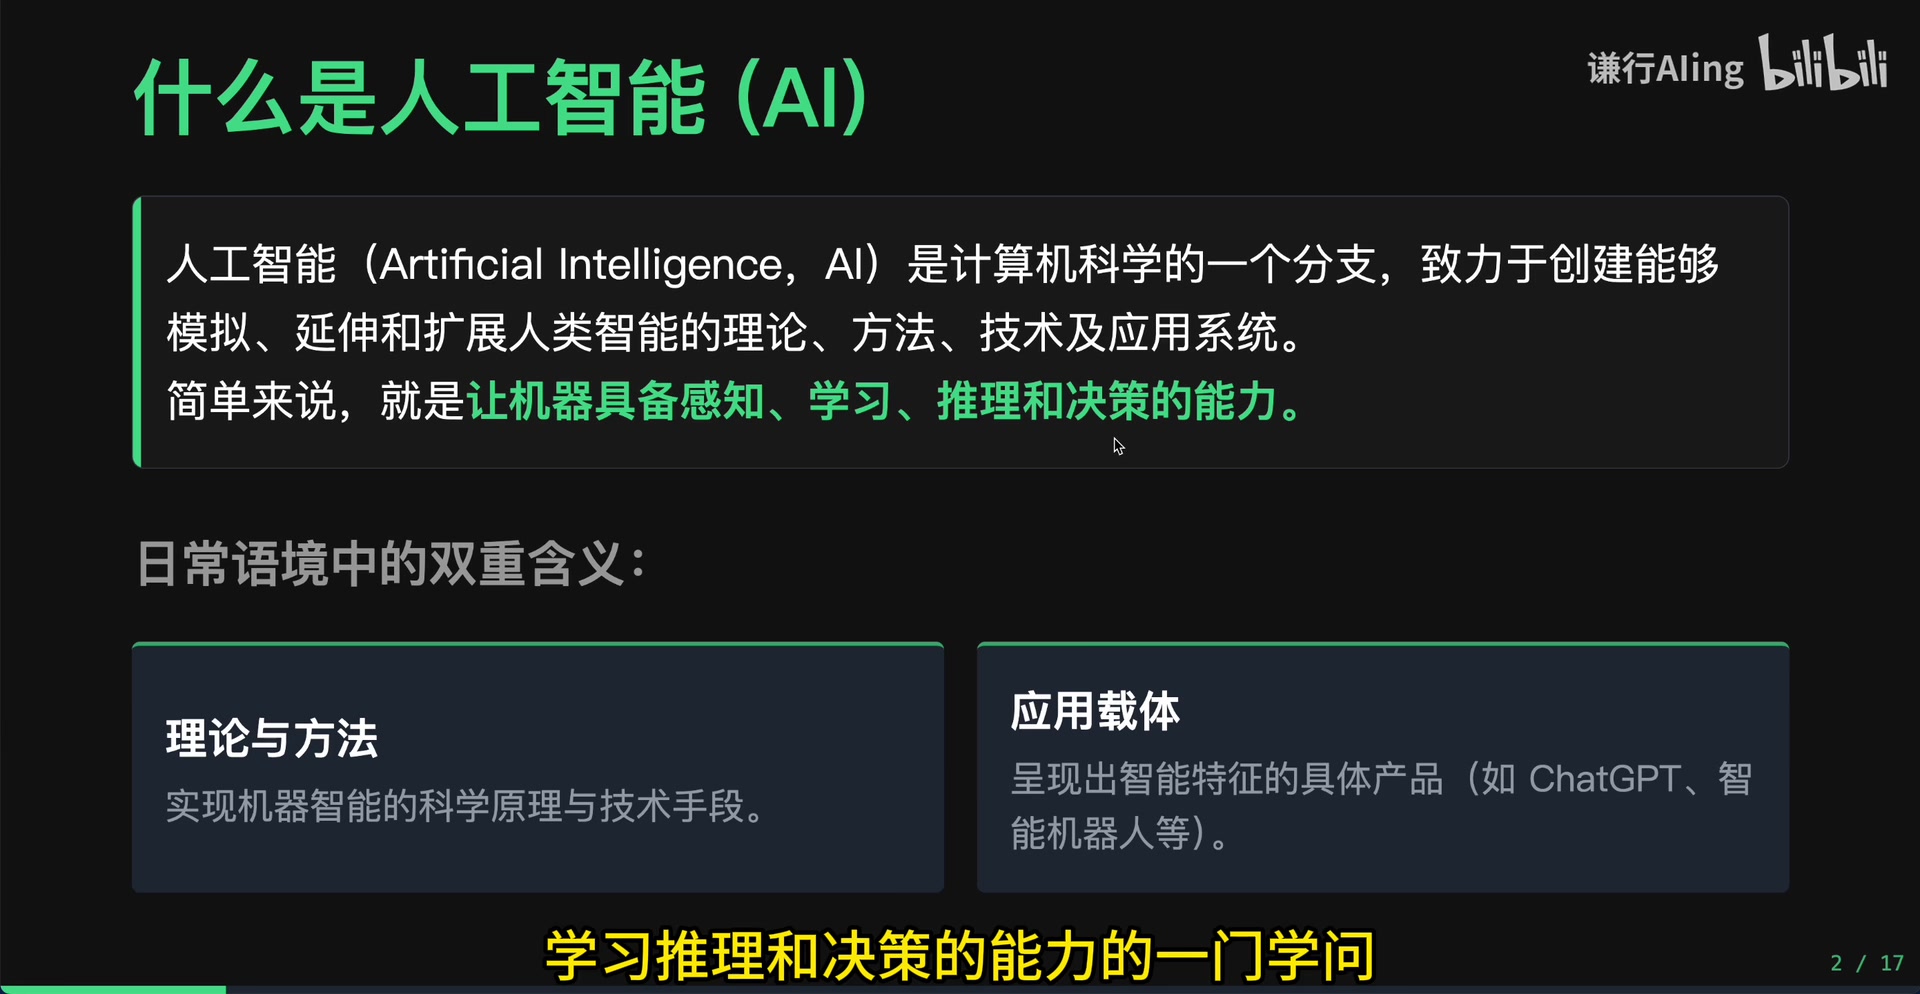 *
- 定义:计算机科学的分支,致力于创建能够模拟、延伸、拓展人类智能的理论、方法、技术及应用系统;核心是让机器具备感知、学习、推理、决策的能力。
- 日常语境的双重含义:
- 理论与方法:实现机器智能的科学原理和技术手段
- 应用载体:具备智能特征的具体产品,例如ChatGPT、智能机器人等
1.2 机器学习(Machine Learning, ML):AI的核心实现路径
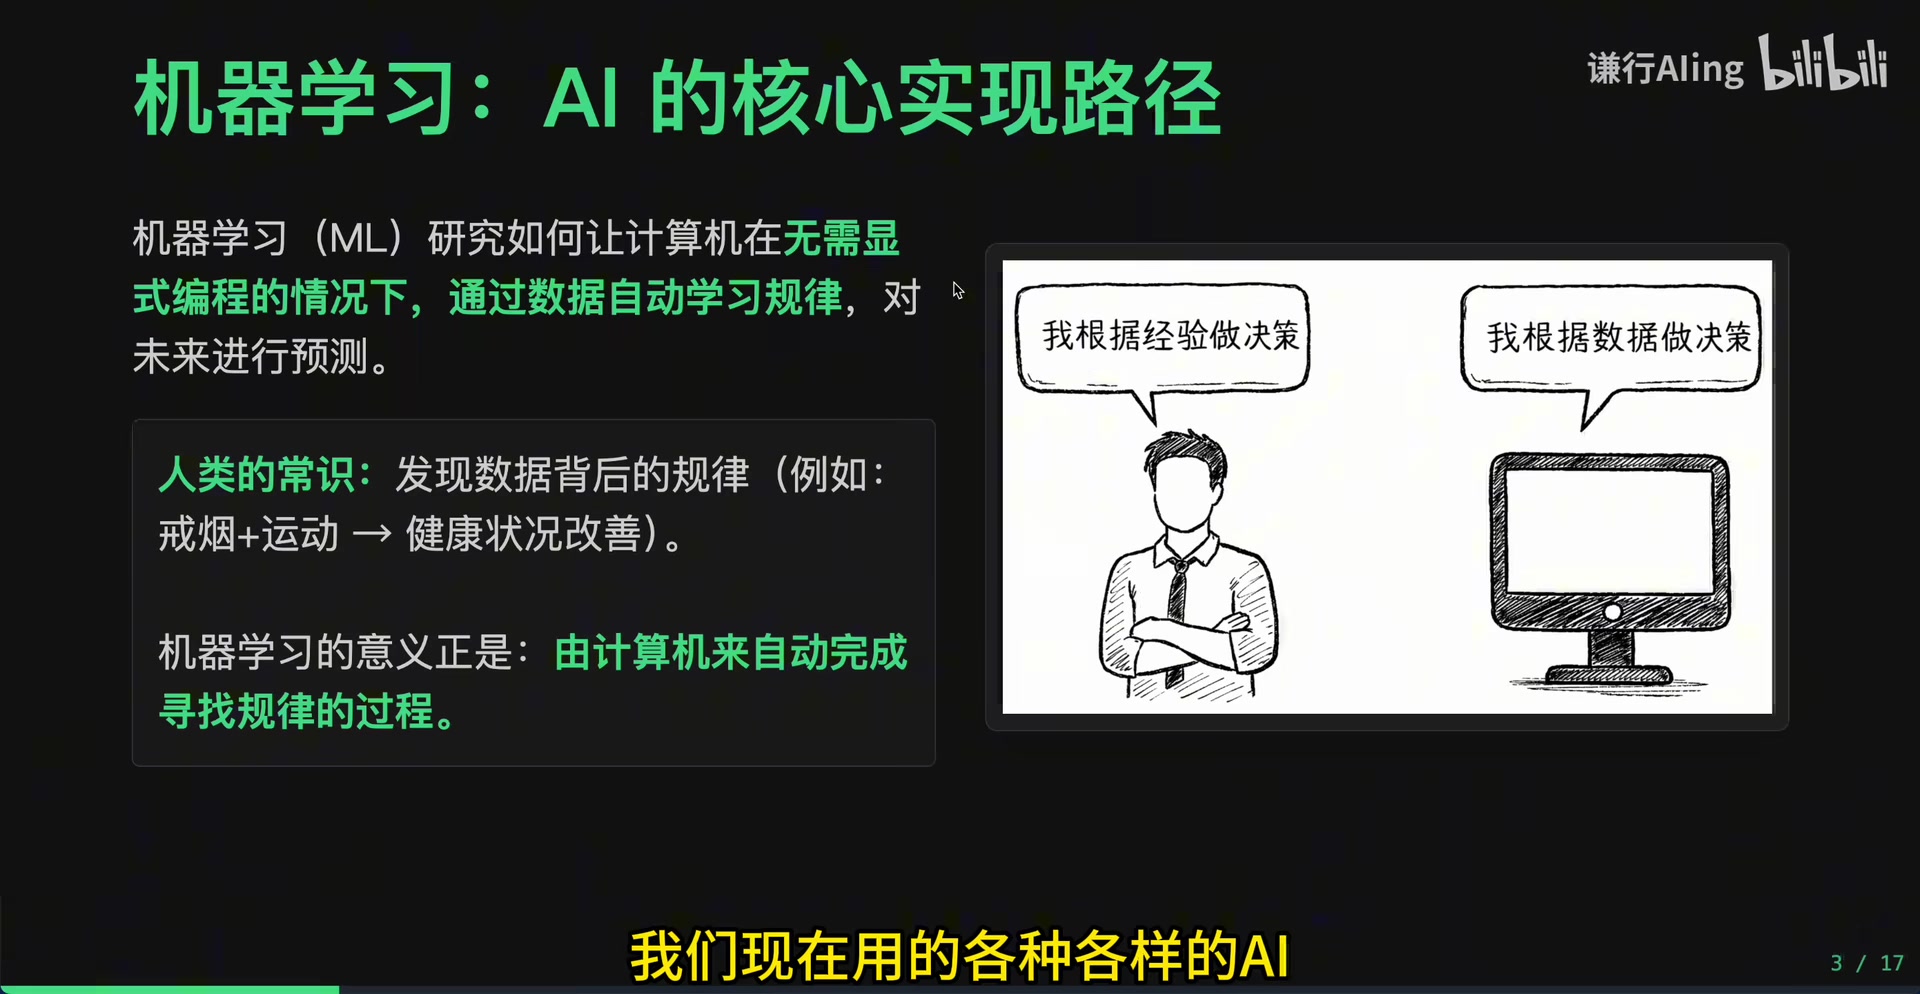 *
- 定义:研究如何让计算机无需显式编程,自动从数据中学习背后的规律,并用规律对未来做预测的技术。当前主流AI应用都基于机器学习实现。
- 与人类决策的区别:人类基于经验总结规律做决策,机器学习基于数据总结规律做决策。
传统编程的局限
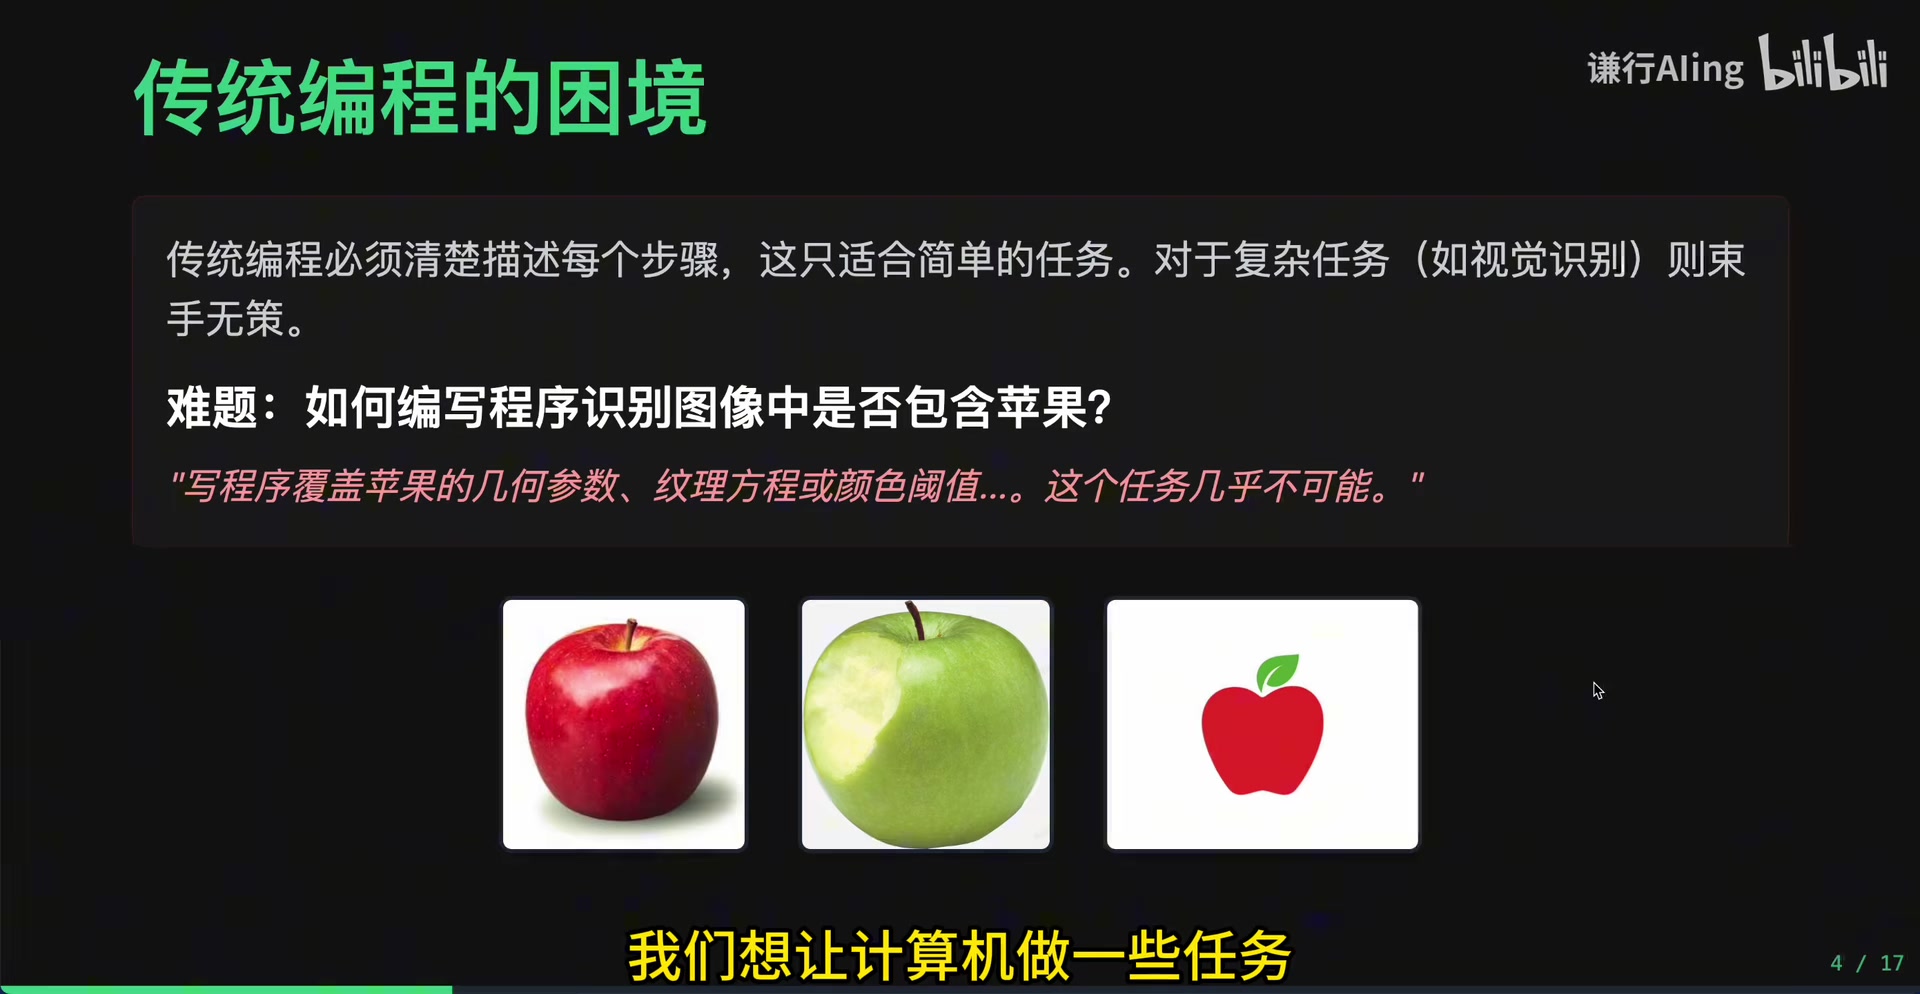 *
传统编程需要开发者明确写出每一步的执行逻辑,仅适合规则清晰的简单任务;对于复杂、难以穷举规则的任务(例如识别图像中的苹果,苹果存在颜色、形态、风格等无数种变化)完全无法实现。
机器学习的解决思路
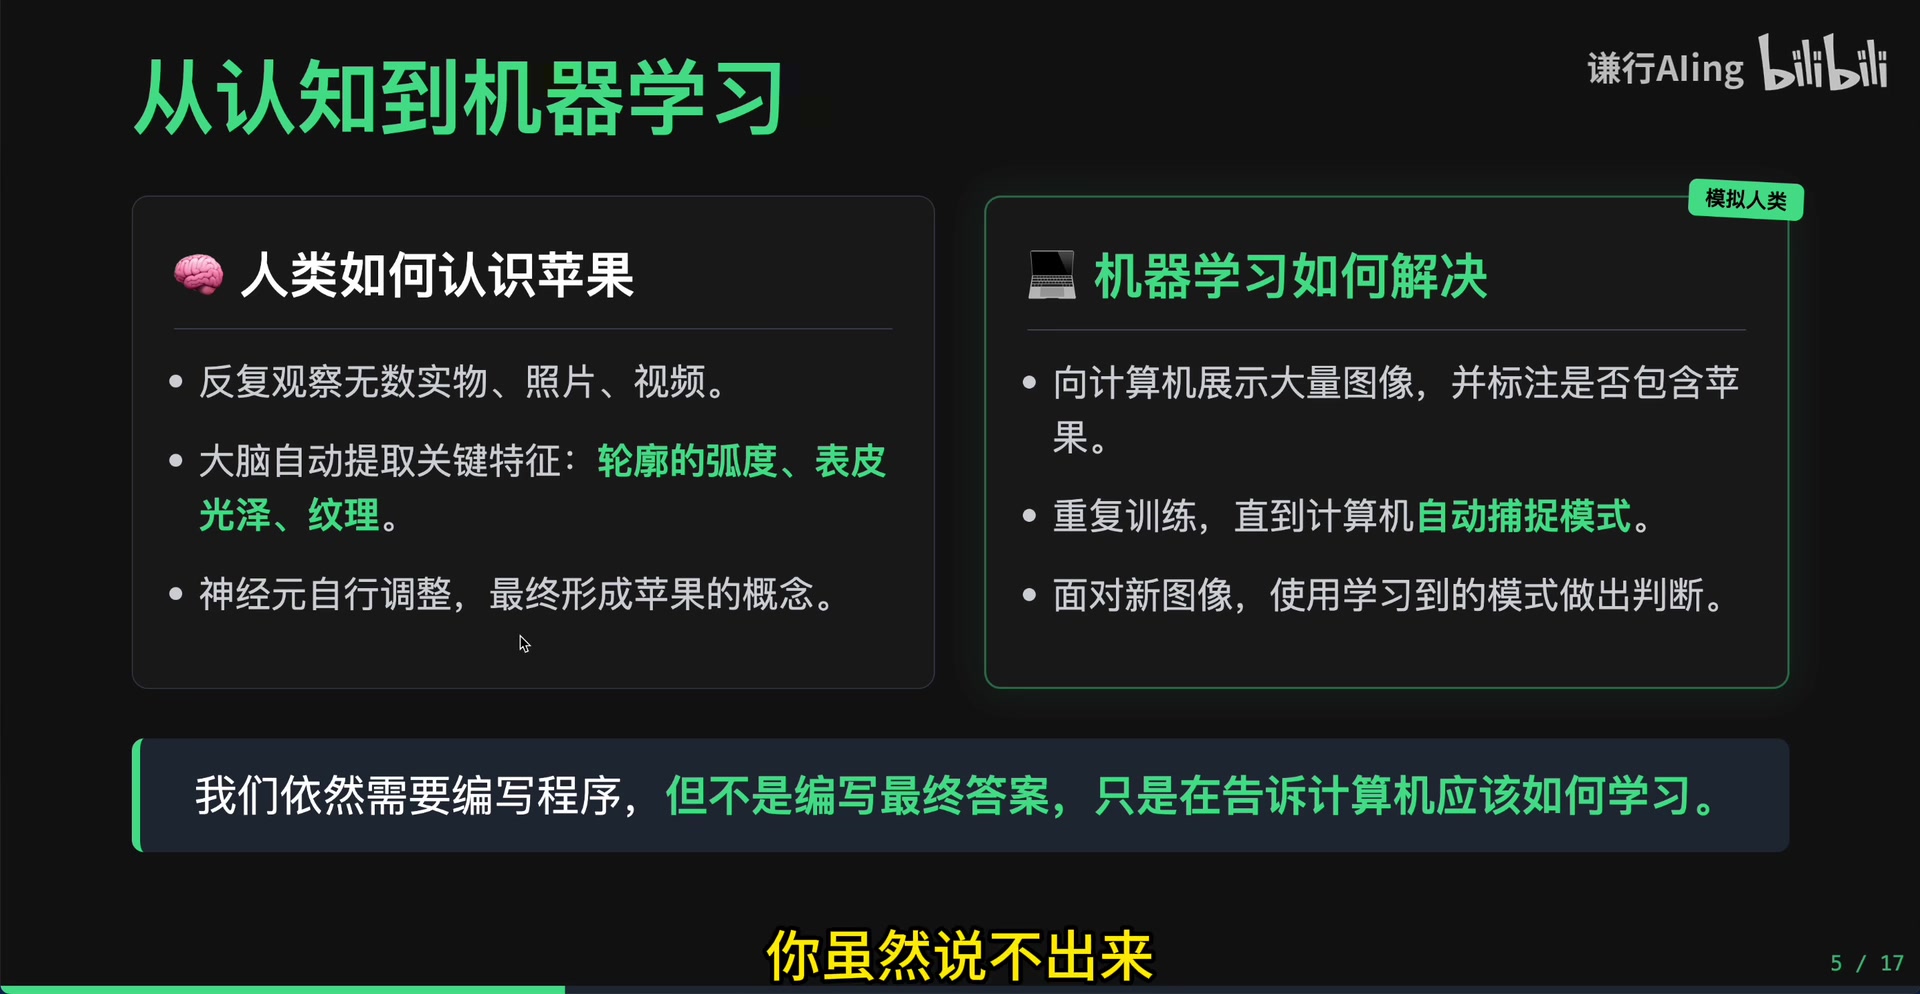 *
模仿人类认知事物的过程:
- 人类认知:观察大量样本,自动提取轮廓、光泽等关键特征,神经元调整后形成对事物的概念。
- 机器学习:给计算机输入大量标注好的样本(例如标注“是否包含苹果”的图像),让计算机自动捕获数据中的模式,总结规律,最终能够识别从未见过的新样本。
- 常见误区澄清:机器学习不是不需要编程,而是编程的目标不是写死业务逻辑,而是编写让计算机“如何学习”的规则,因此AI时代仍然需要掌握编程能力。
1.3 深度学习(Deep Learning, DL):特殊的机器学习
 *
- 定义:本质属于机器学习,采用多层神经网络架构,能够自动提取数据中更深层次的抽象特征,是当前主流的复杂AI应用的实现基础。
- 与传统机器学习的对比:
| 维度 | 传统机器学习 | 深度学习 |
|---|---|---|
| 特征处理 | 需要人工指定模型需要关注的特征 | 输入原始数据,自动逐层提取特征(从边缘→纹理→整体语义) |
| 擅长数据类型 | 结构化数据(如表格、Excel数据) | 非结构化数据(如图像、文本、音频、视频) |
| 算力要求 | 低 | 高,需要海量数据支撑 |
| 典型应用场景 | 金融风控、商品推荐 | 大语言模型、自动驾驶、智能机器人 |
1.4 三者的包含关系
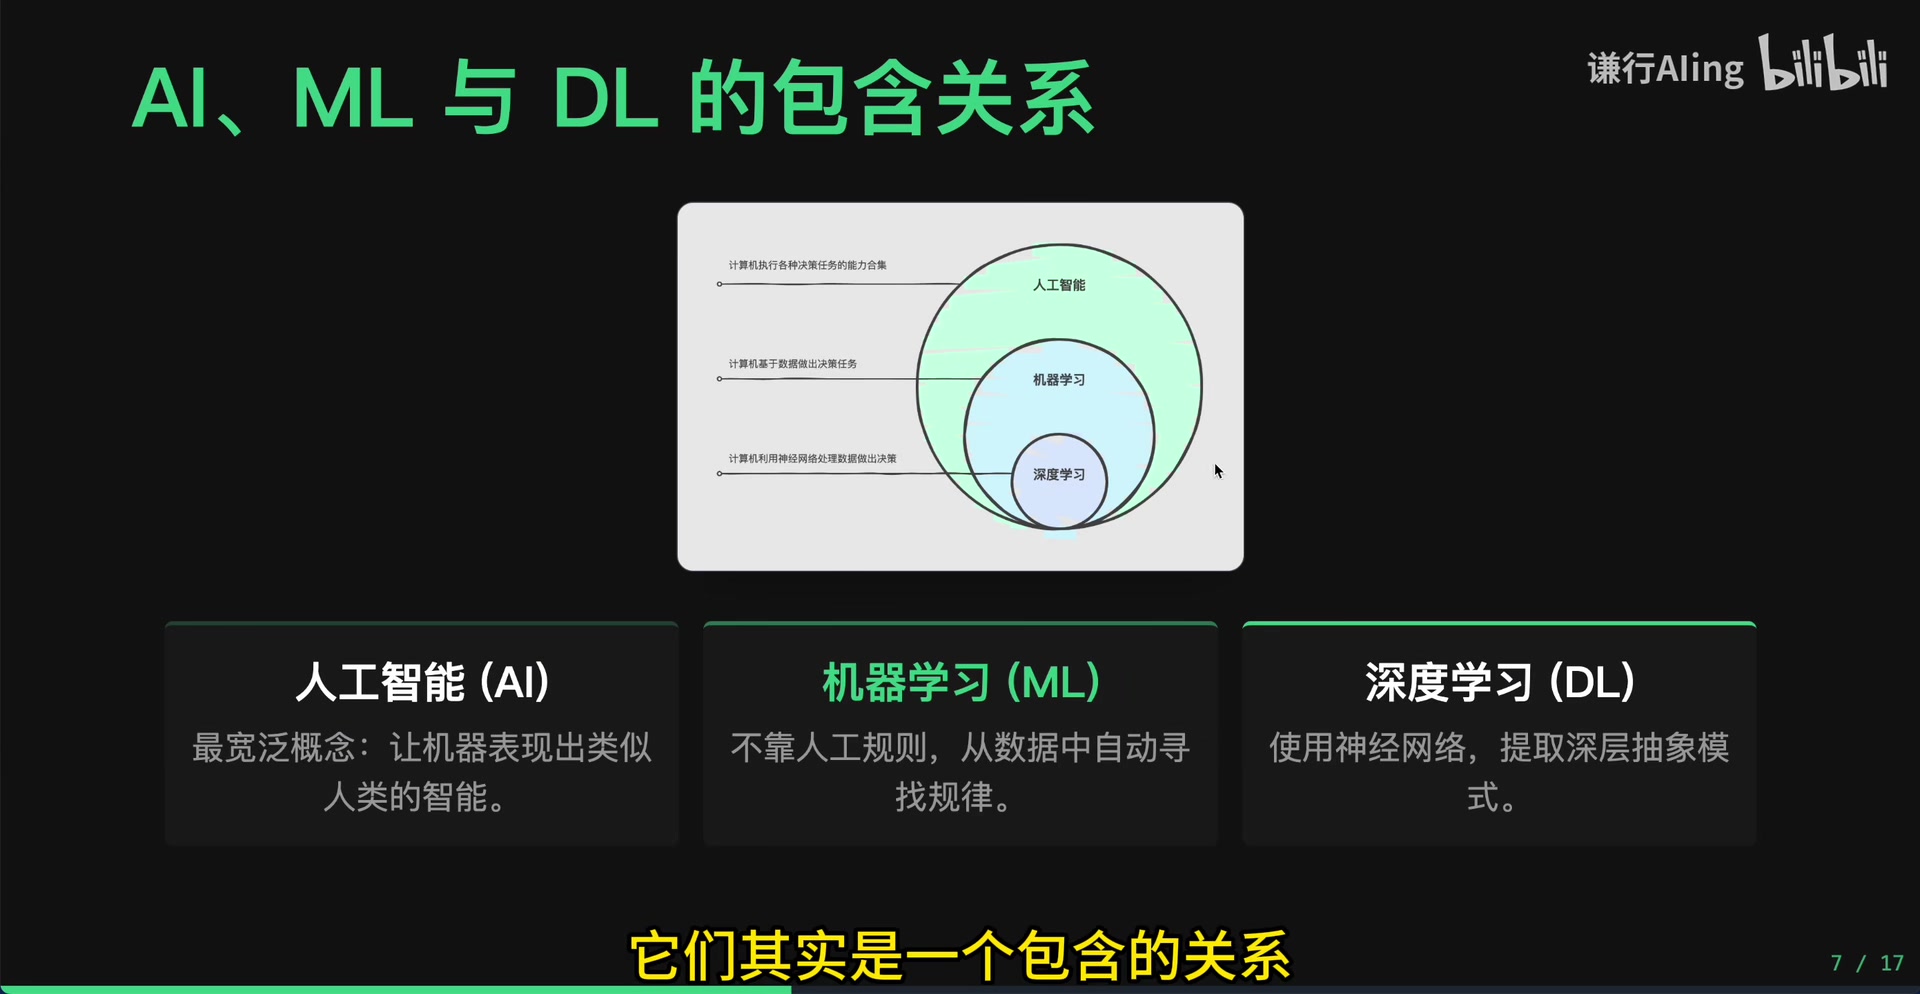 *
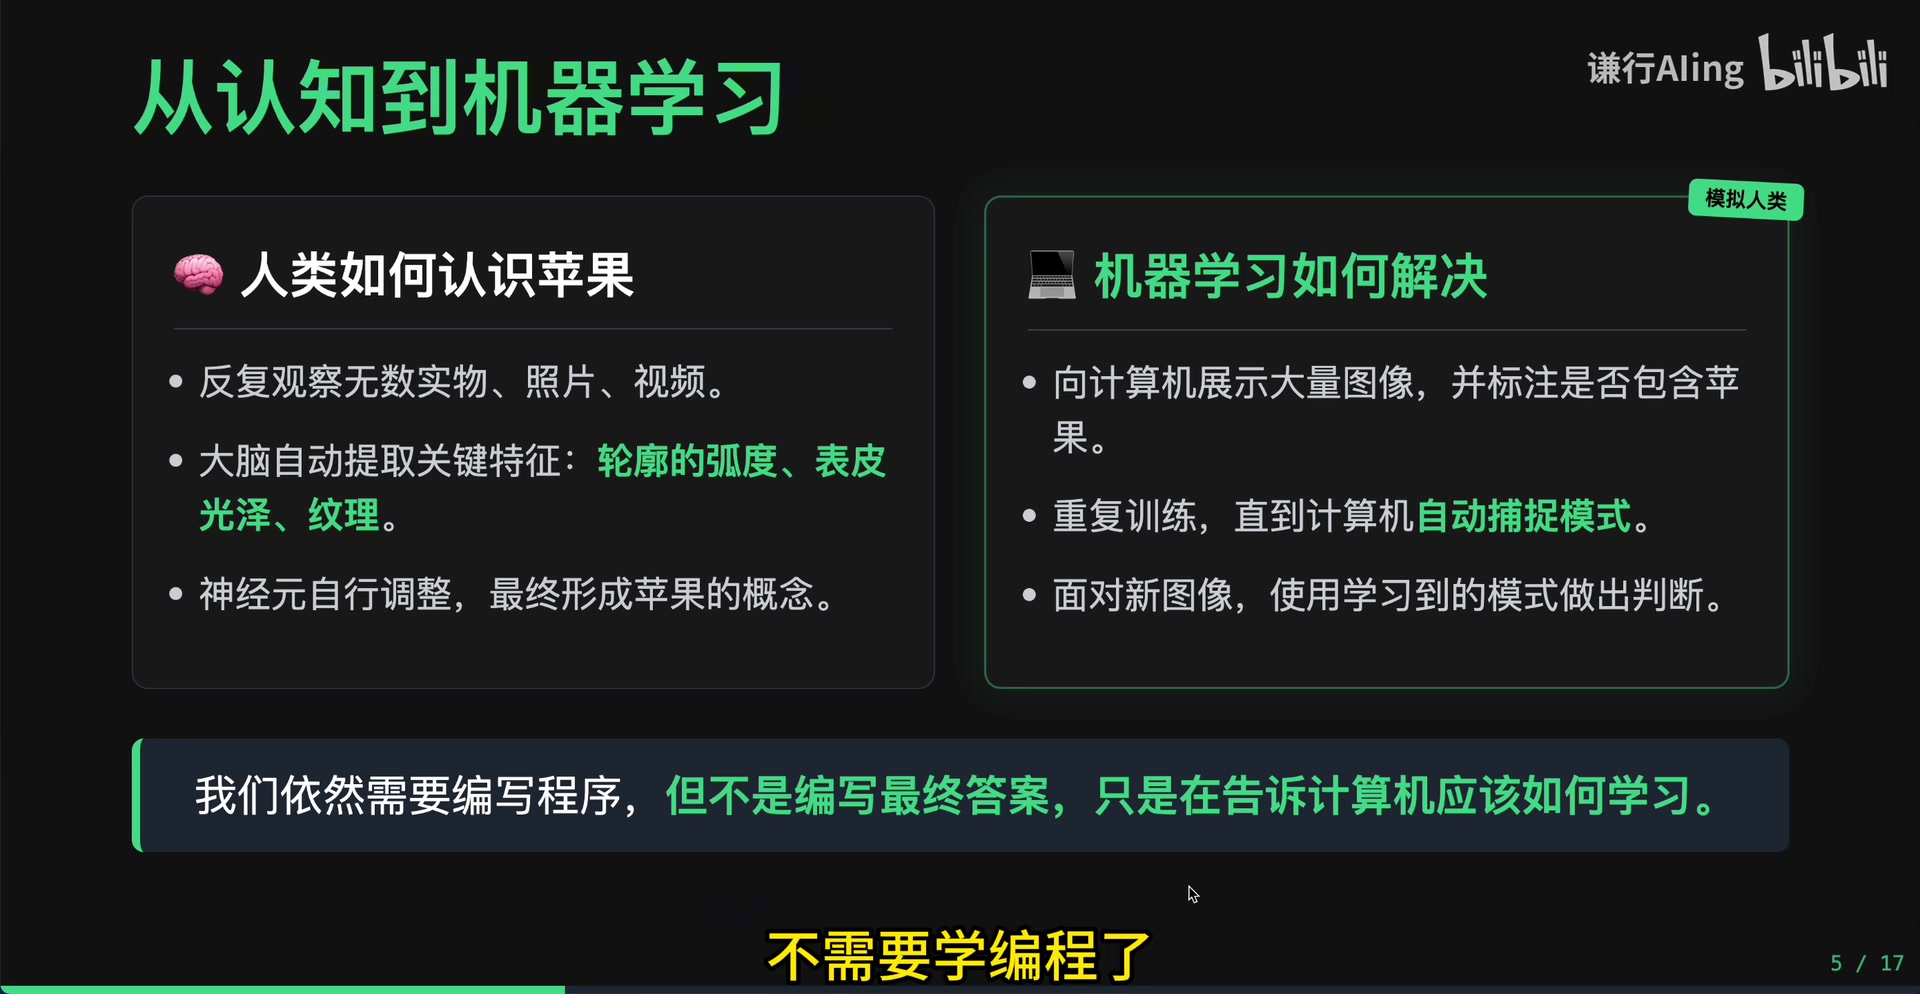
- 人工智能(AI):最宽泛的概念,所有让机器表现出类似人类智能的技术与产品都属于AI范畴。
- 机器学习(ML):实现AI的核心手段,核心是不靠人工写死规则,让机器自动从数据中找规律。
- 深度学习(DL):机器学习的子领域,基于神经网络实现,是当前绝大多数复杂AI应用的技术基础。
2. 机器学习的工作原理
2.1 机器决策的核心逻辑
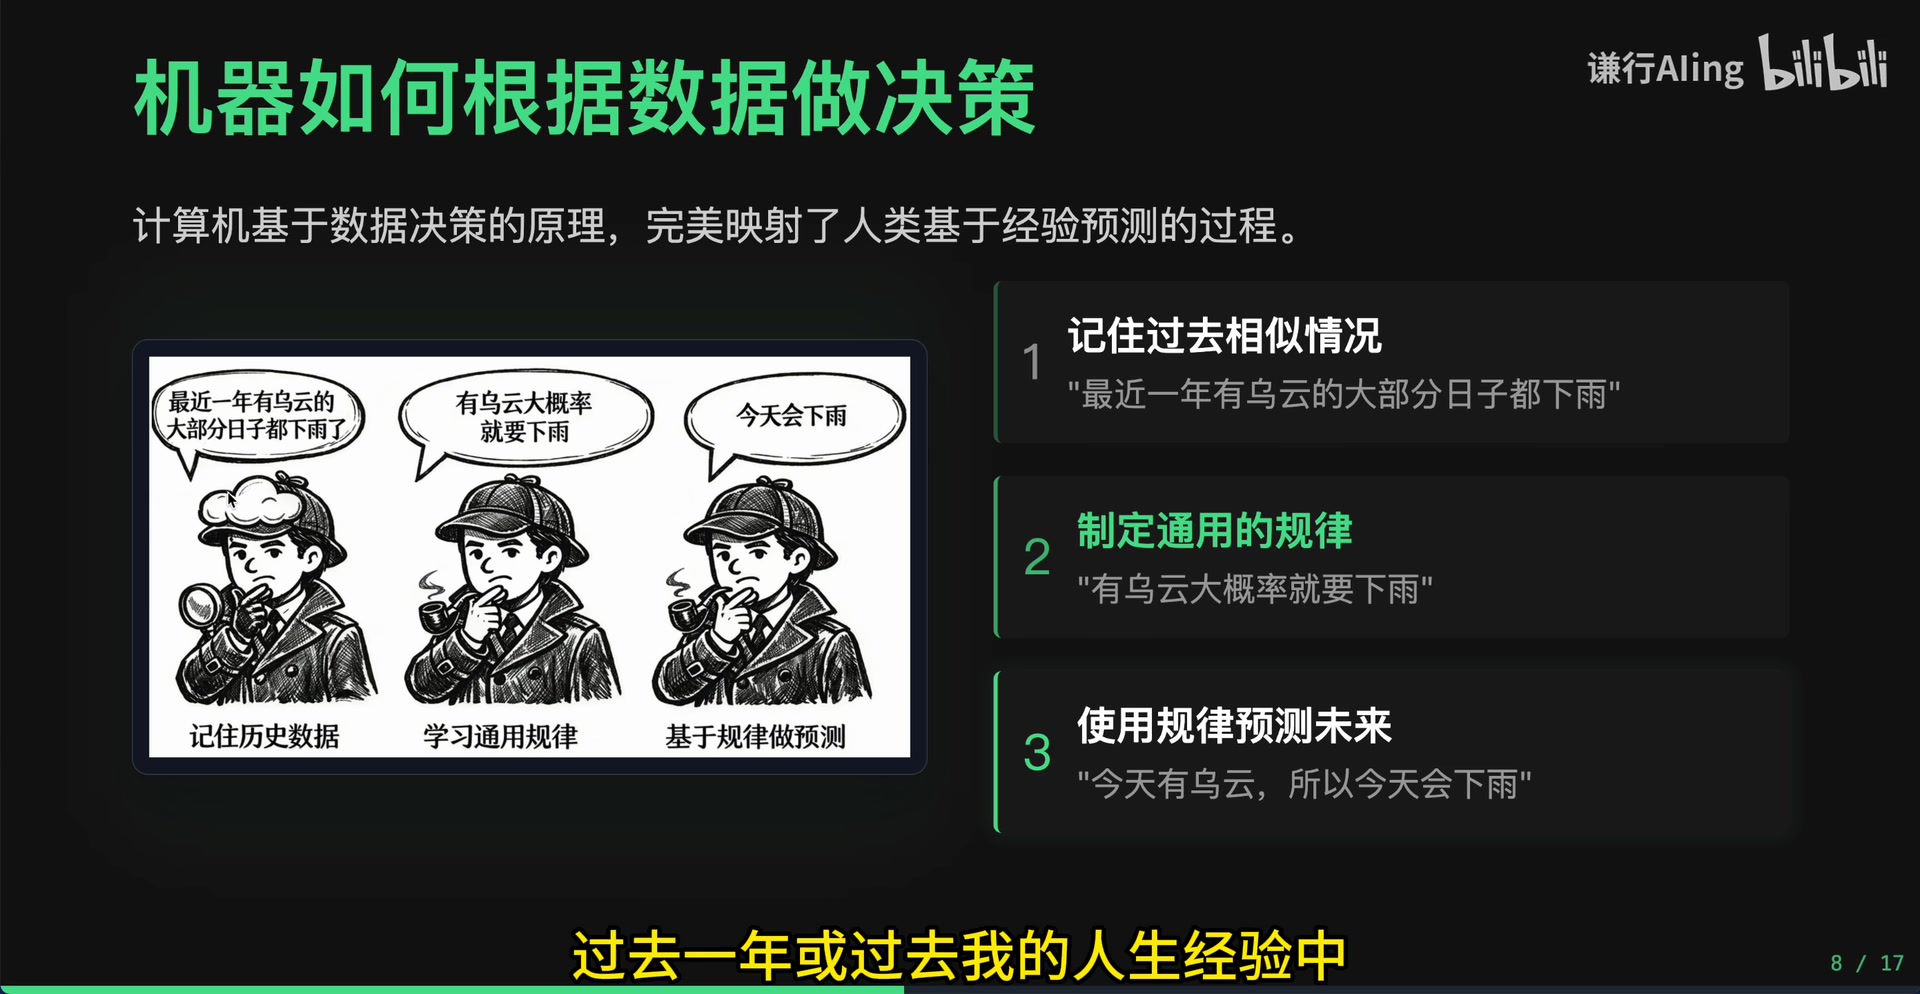 *
计算机基于数据决策的过程和人类基于经验预测完全一致:
- 记住历史相似情况:例如人类记住“过去有乌云的日子大多会下雨”
- 总结通用规律:例如“有乌云大概率会下雨”
- 用规律预测未来:例如“今天有乌云,所以今天会下雨”
机器的核心是把“经验”替换成“数据”,从数据中提炼规律用来预测。
2.2 什么是模型(Model)
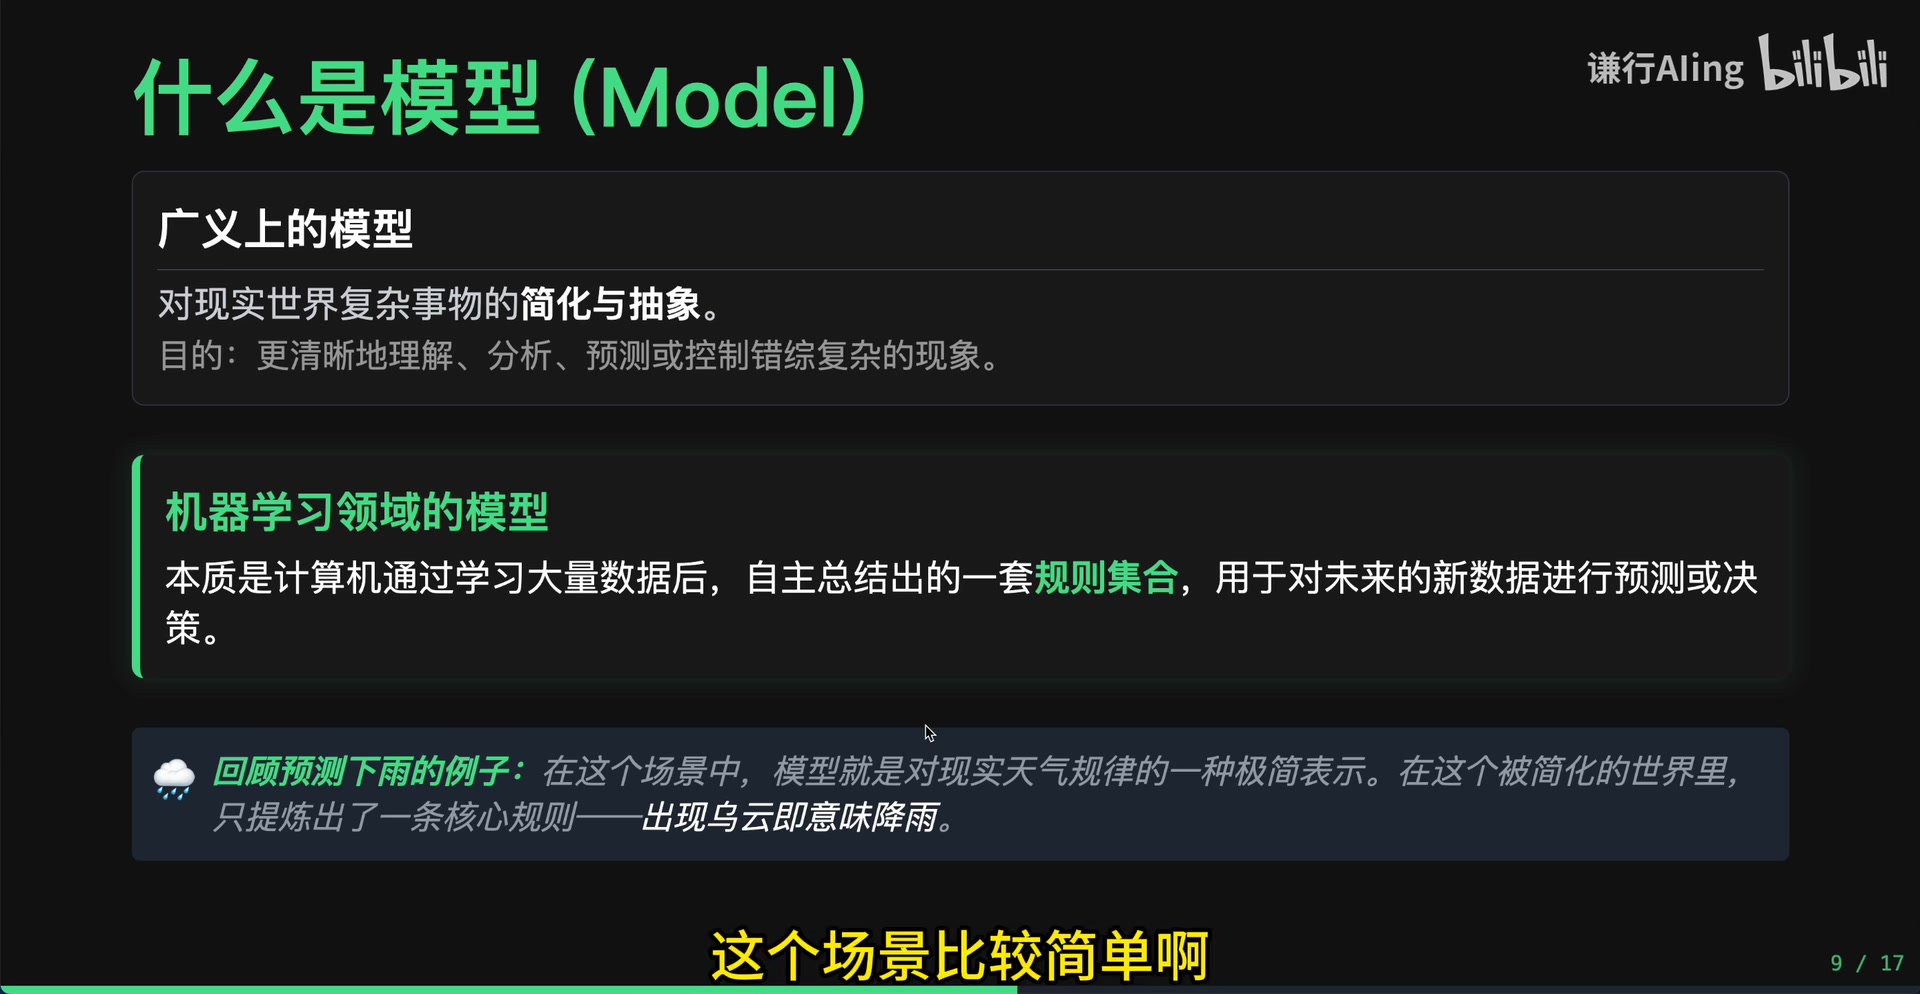 *
- 广义定义:对现实世界复杂事物的简化与抽象,目的是更清晰地理解、分析、预测、控制复杂现象。
- 机器学习领域定义:计算机通过学习大量数据后,自主总结出的一套规则集合,用来对新数据做预测或决策。
例如下雨预测场景中,“出现乌云就会下雨”就是一个简化的模型;垃圾邮件分类场景中,“周末发送且大于10KB就是垃圾邮件”也是一个模型。
算法与模型的区分
- 算法(Algorithm):是“学习的方法”,是指导计算机从数据中找规律的明确逻辑步骤,作用是构建模型。
- 模型(Model):是“学习的结果”,是算法学习数据后得到的规则集合,作用是预测新数据。
- 核心关系:算法负责构建模型,模型负责预测未来。
2.3 建模示例:垃圾邮件分类
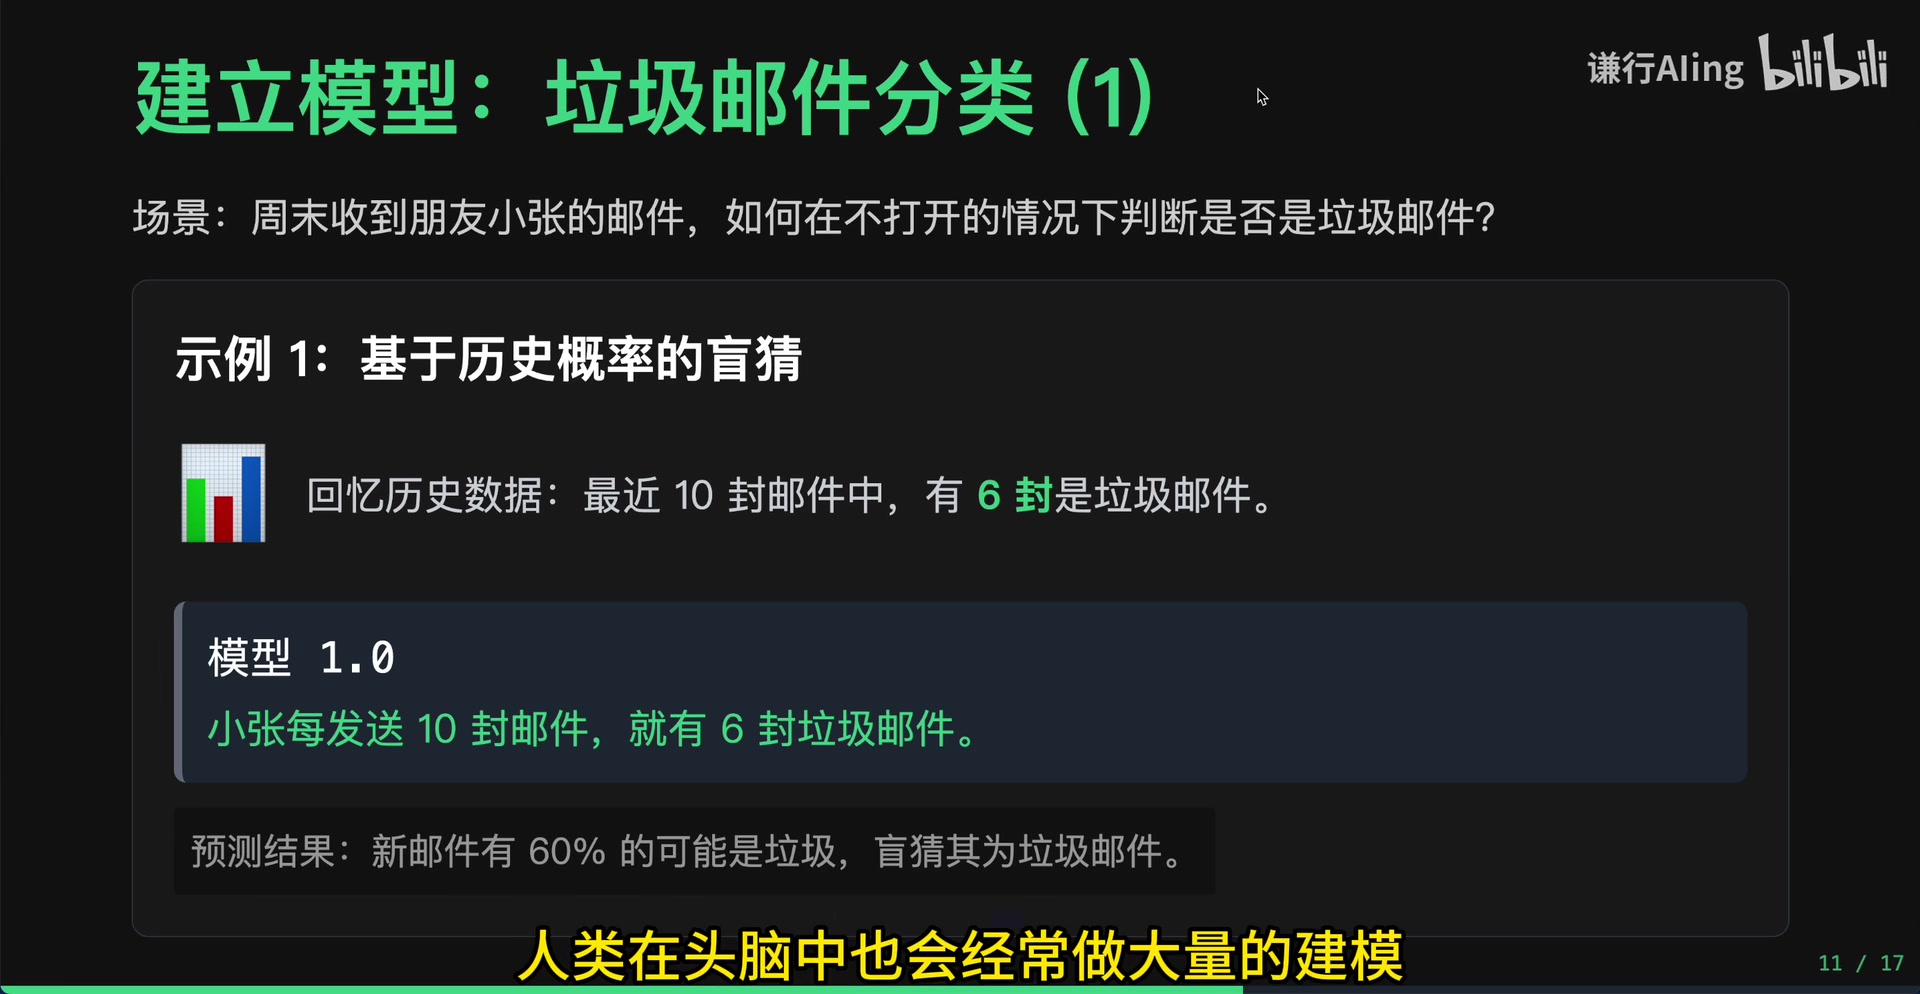 *
通过迭代优化垃圾邮件识别模型的过程,直观理解建模的逻辑:
模型1.0:仅基于历史概率
- 逻辑:统计到历史10封邮件中有6封是垃圾邮件,因此认为新邮件有60%概率是垃圾邮件。
- 缺点:过于粗糙,准确率极低。
模型2.0:加入发送时间特征
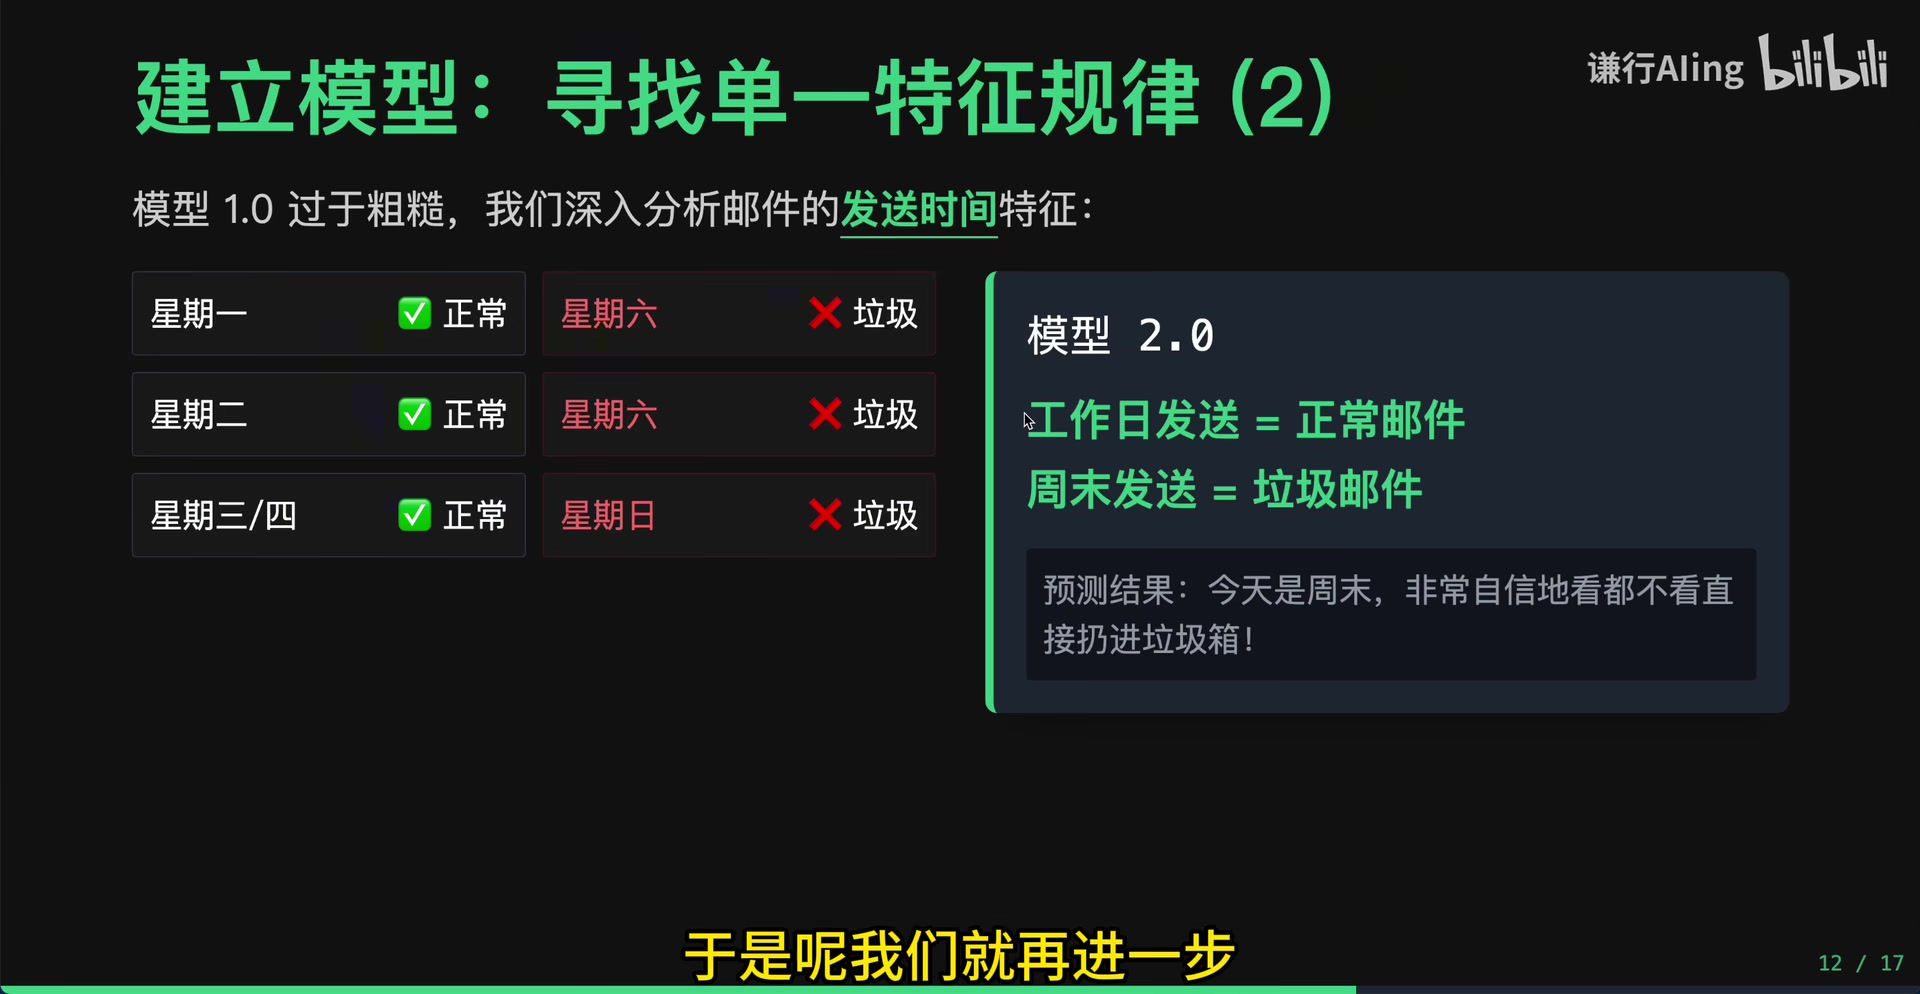 *
- 逻辑:观察到历史数据中工作日发送的基本是正常邮件,周末发送的基本是垃圾邮件,因此总结规则“工作日发=正常,周末发=垃圾”。
- 缺点:规则太绝对,会误杀周末发送的正常邮件(例如徒步活动通知)。
模型3.0:加入文件大小特征,多维组合
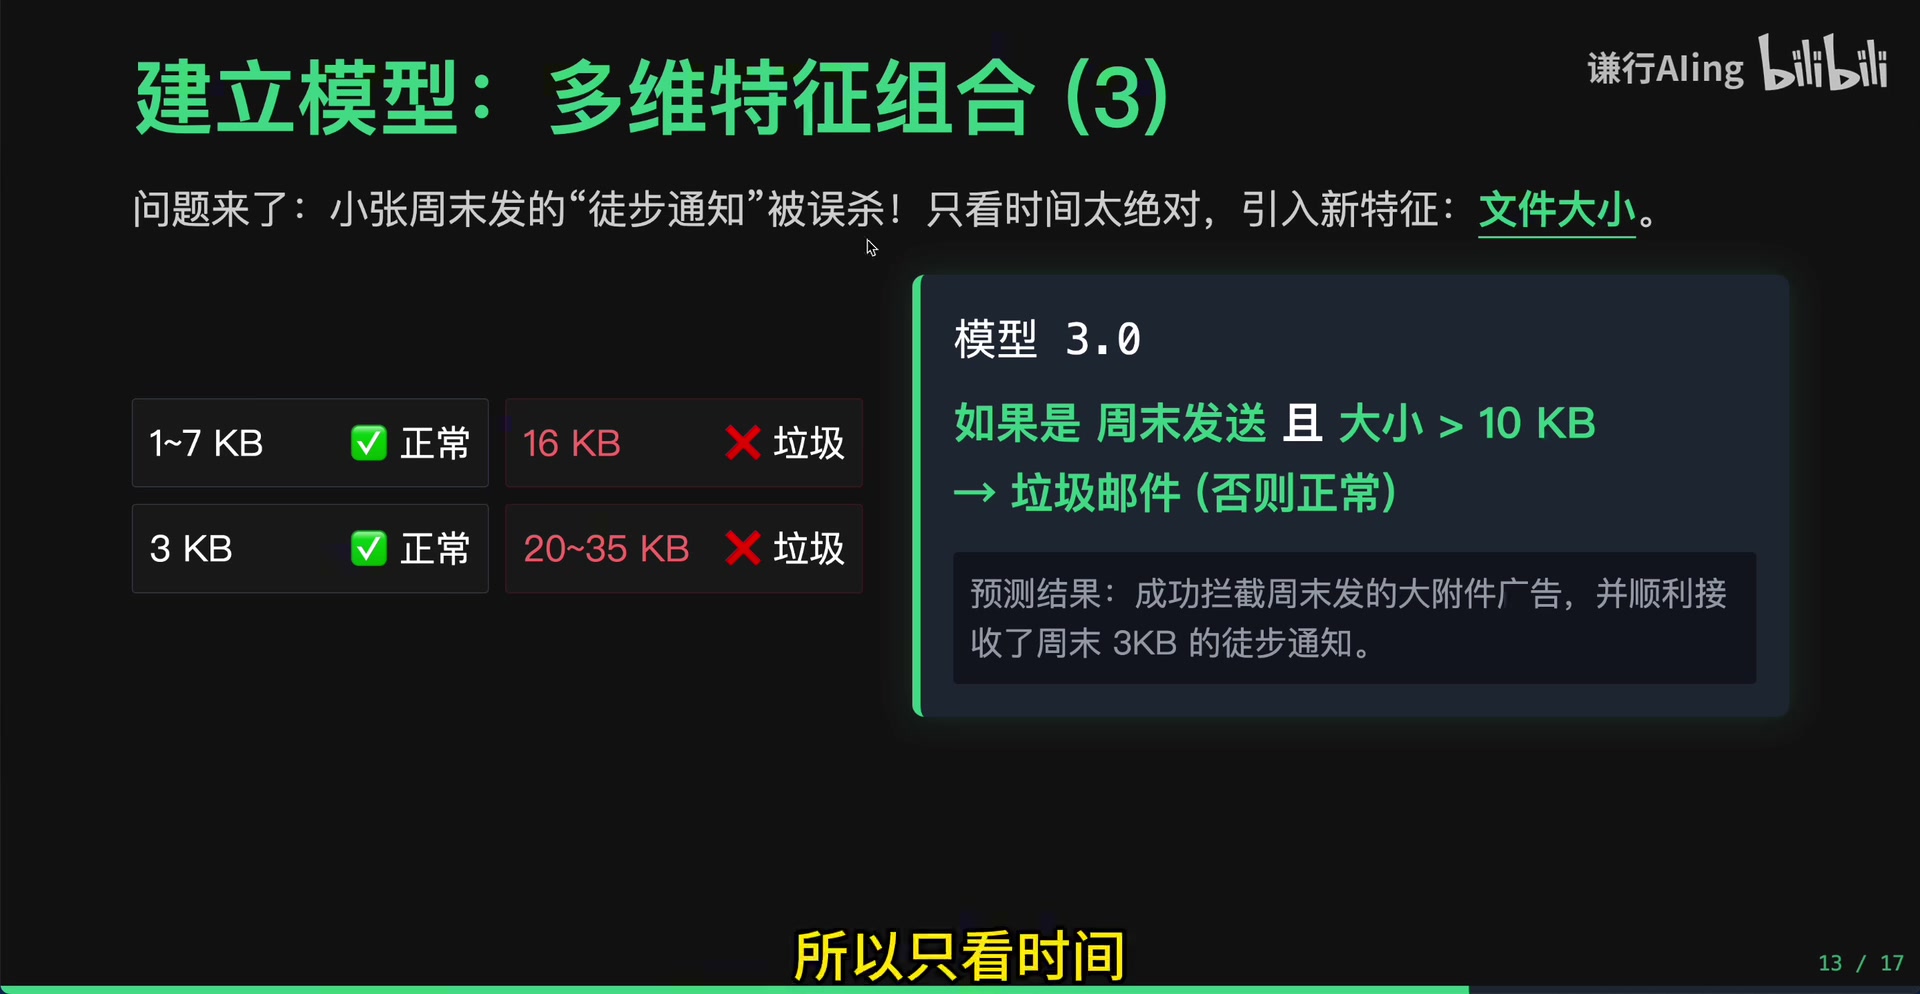 *
- 逻辑:观察到垃圾邮件大多带附件、体积更大,因此更新规则“周末发送 且 文件大小>10KB → 垃圾邮件,否则为正常邮件”。
- 效果:既能正确拦截周末的大体积广告垃圾邮件,也不会误杀小体积的正常通知邮件,准确率大幅提升。
2.4 机器学习的本质:寻找最优权重
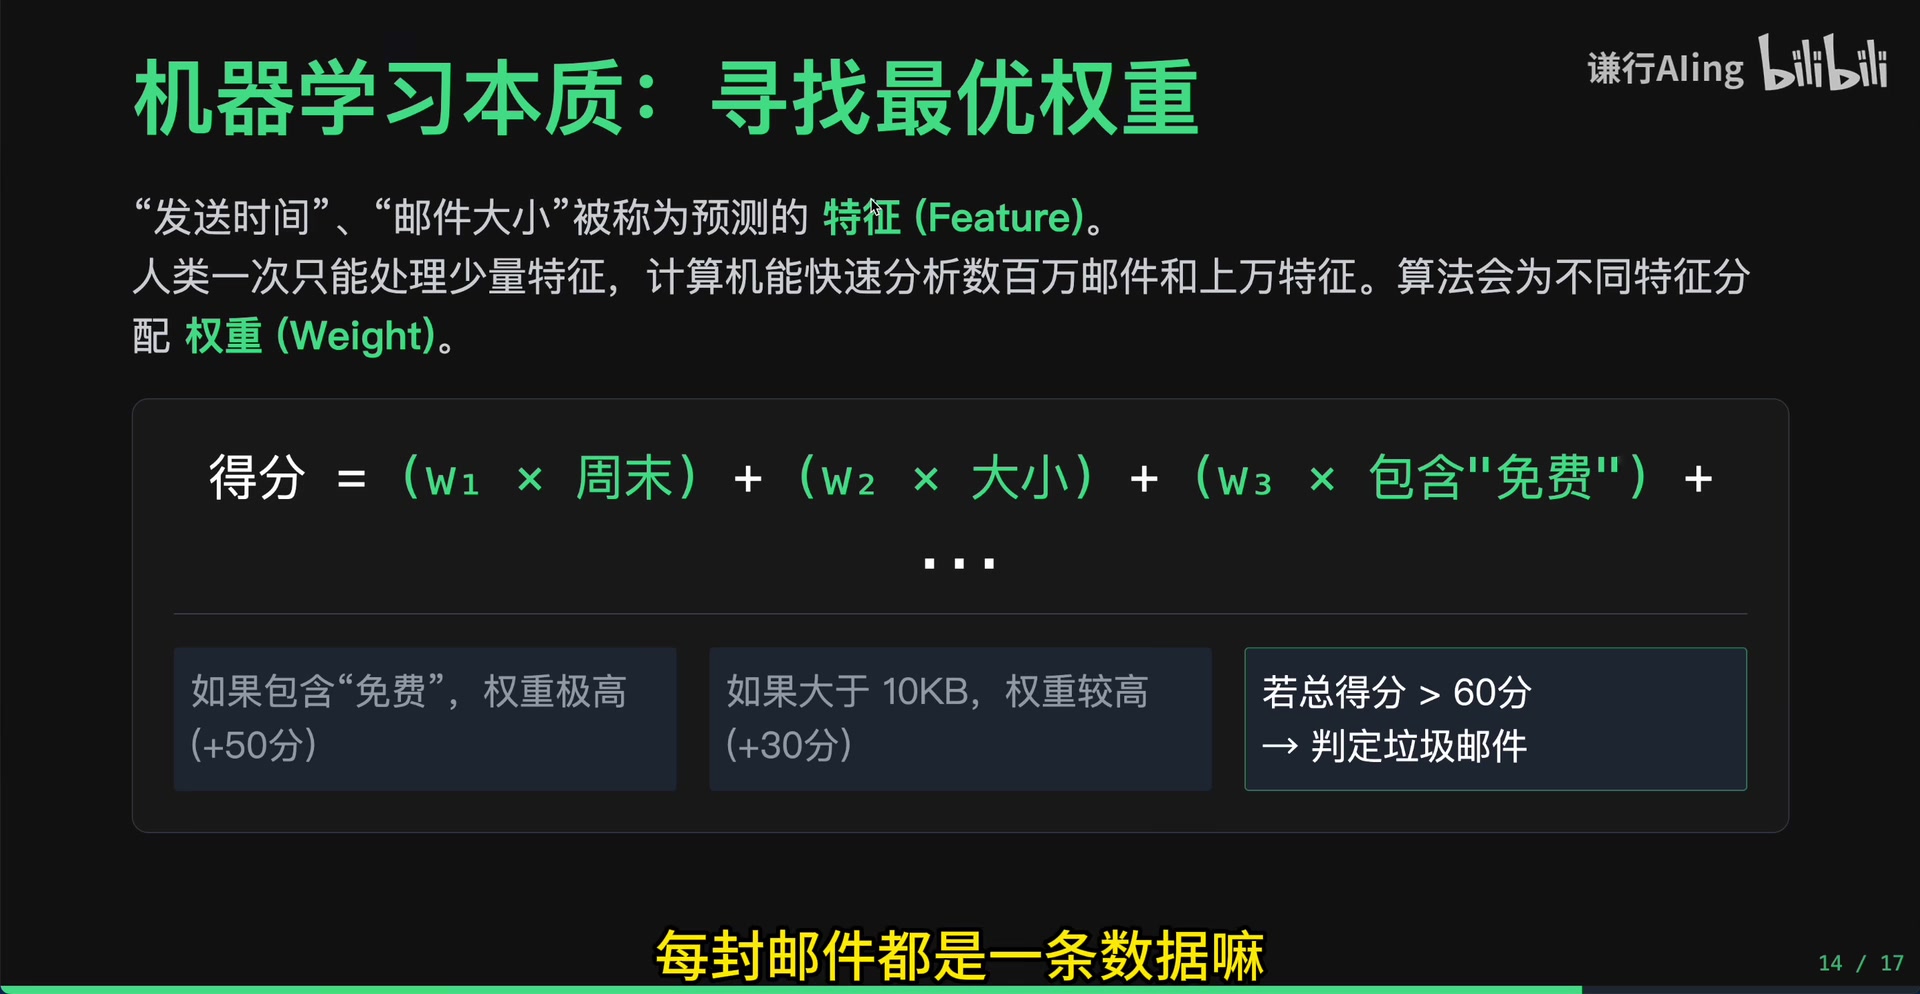 *
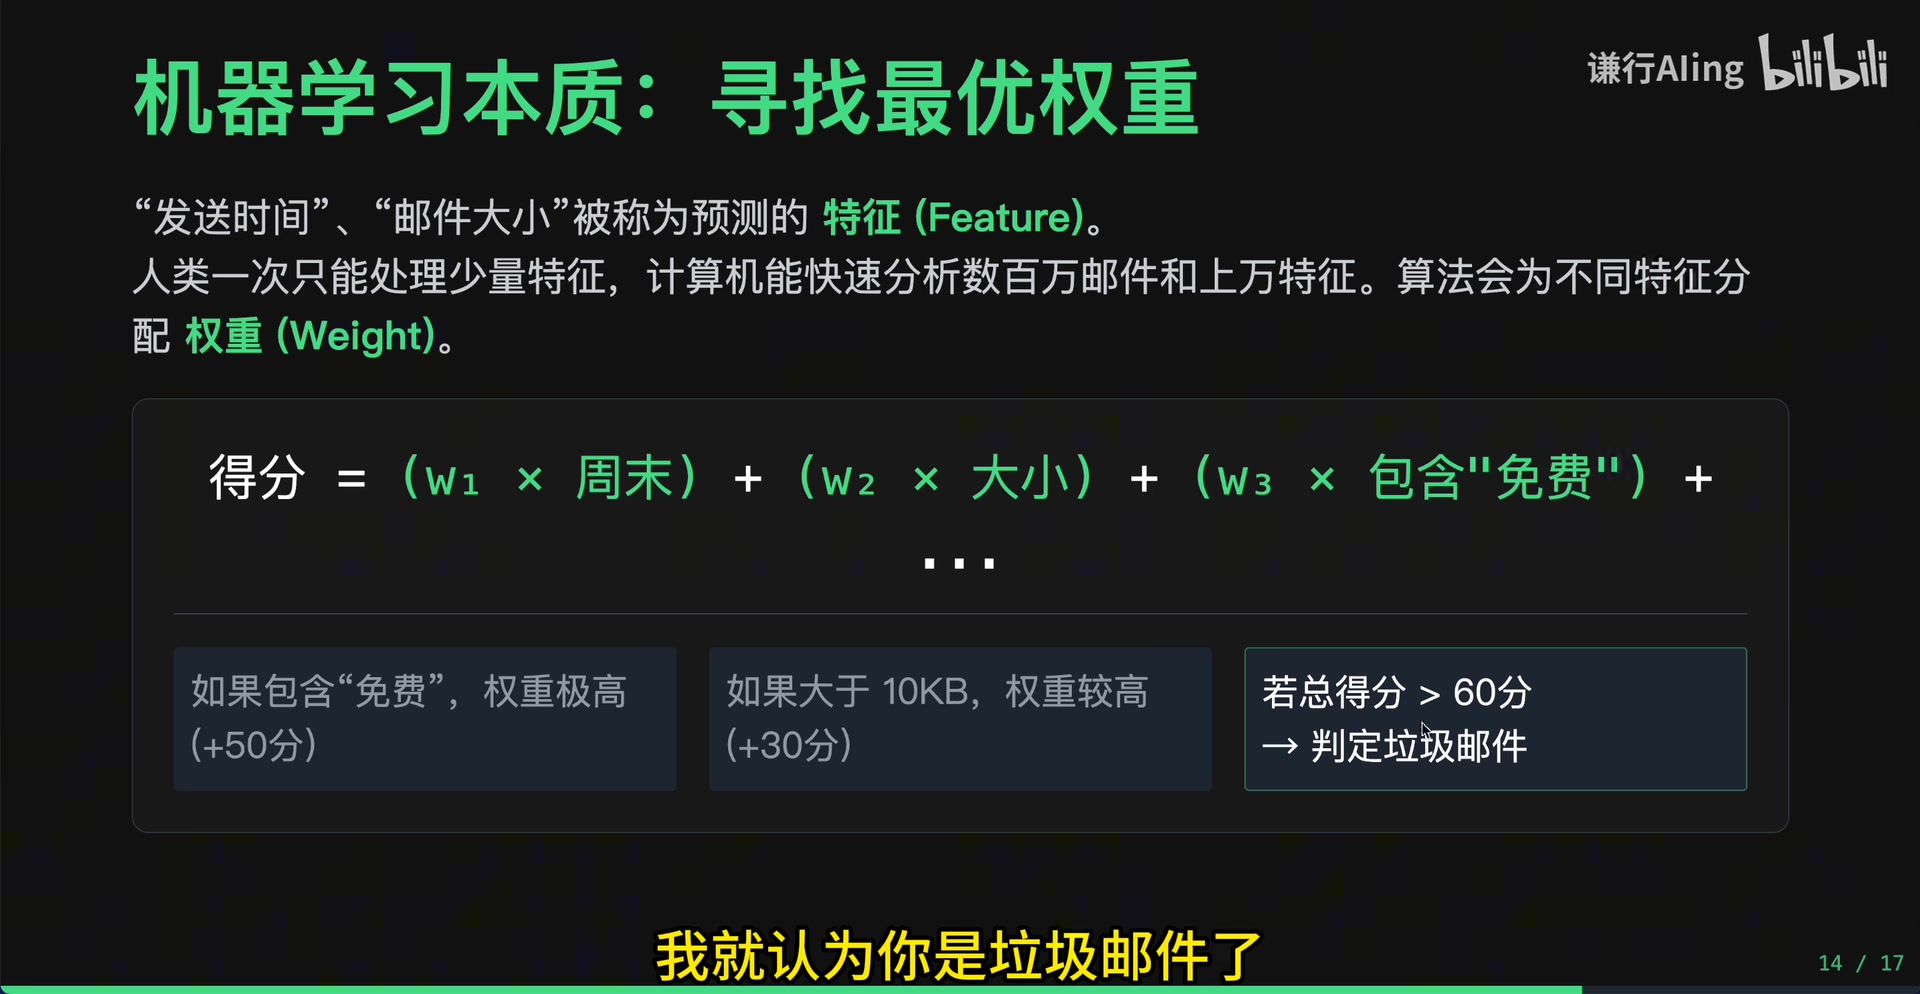
人类只能同时处理少量特征,而机器学习可以同时处理上百万个特征,从海量高维数据中找到人类无法发现的复杂规律。建模的过程本质是给不同的特征分配合适的权重(Weight),最终通过加权得分判断结果:
- 特征:影响最终结果的相关因素,例如垃圾邮件分类中的“是否周末发送”“文件大小”“是否包含‘免费中奖’关键词”等。
- 权重:每个特征对结果的影响程度,例如“包含‘免费中奖’”对垃圾邮件的影响远大于“周末发送”,因此权重更高。
- 得分公式:
$$
\text{得分} = (w_1 \times \text{是否周末}) + (w_2 \times \text{文件是否>10KB}) + (w_3 \times \text{是否包含”免费”}) + \dots
$$
- 判定规则:如果总得分超过设定阈值(例如60分),就判定为垃圾邮件。
机器学习的核心问题
 *
如何精准确定每一个特征的最优权重?
机器学习的核心过程就是:让计算机输入大量历史标注数据,不断自动调整参数,找到一组能让预测准确率最高的最优权重。
3. 学习路线与前置知识
 *
核心理念
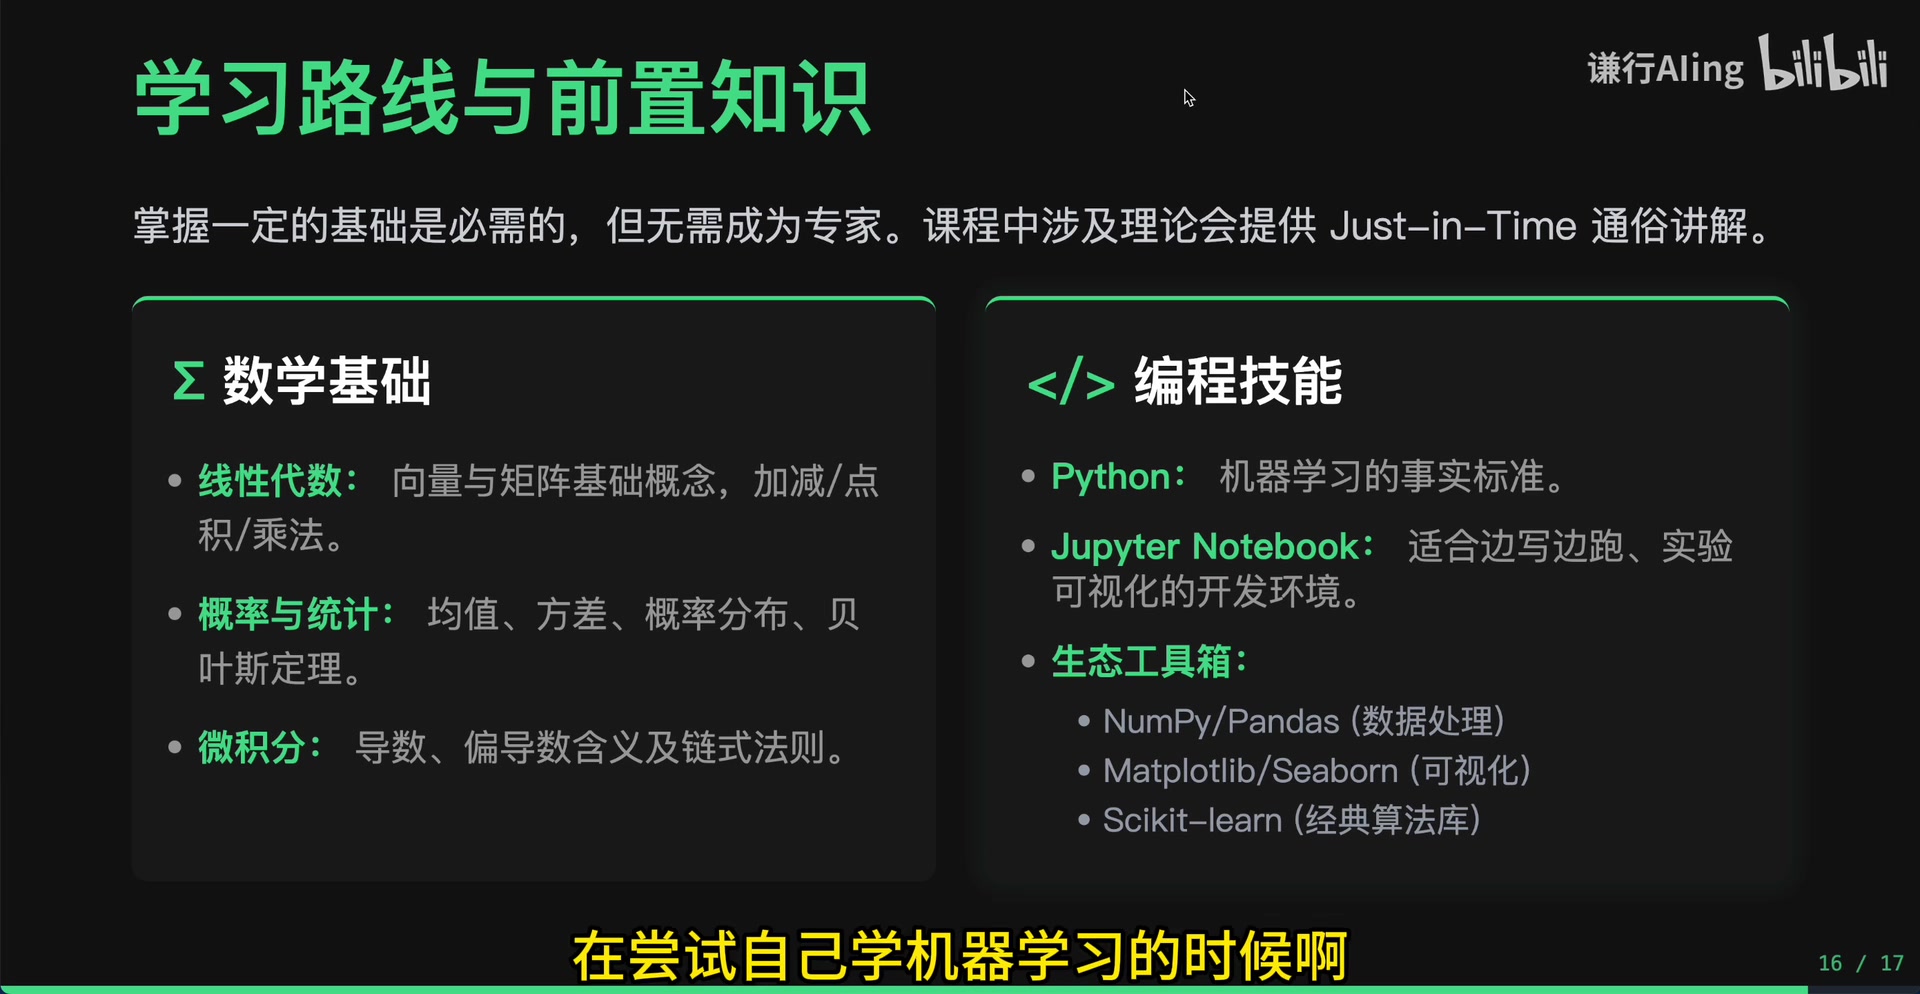
学习机器学习需要一定基础,但完全不需要成为数学或编程专家;课程会在用到对应知识时做适时(Just-in-Time)的通俗讲解,零基础也可以入门。
3.1 数学基础要求
仅需要掌握核心概念即可,不需要深入推导:
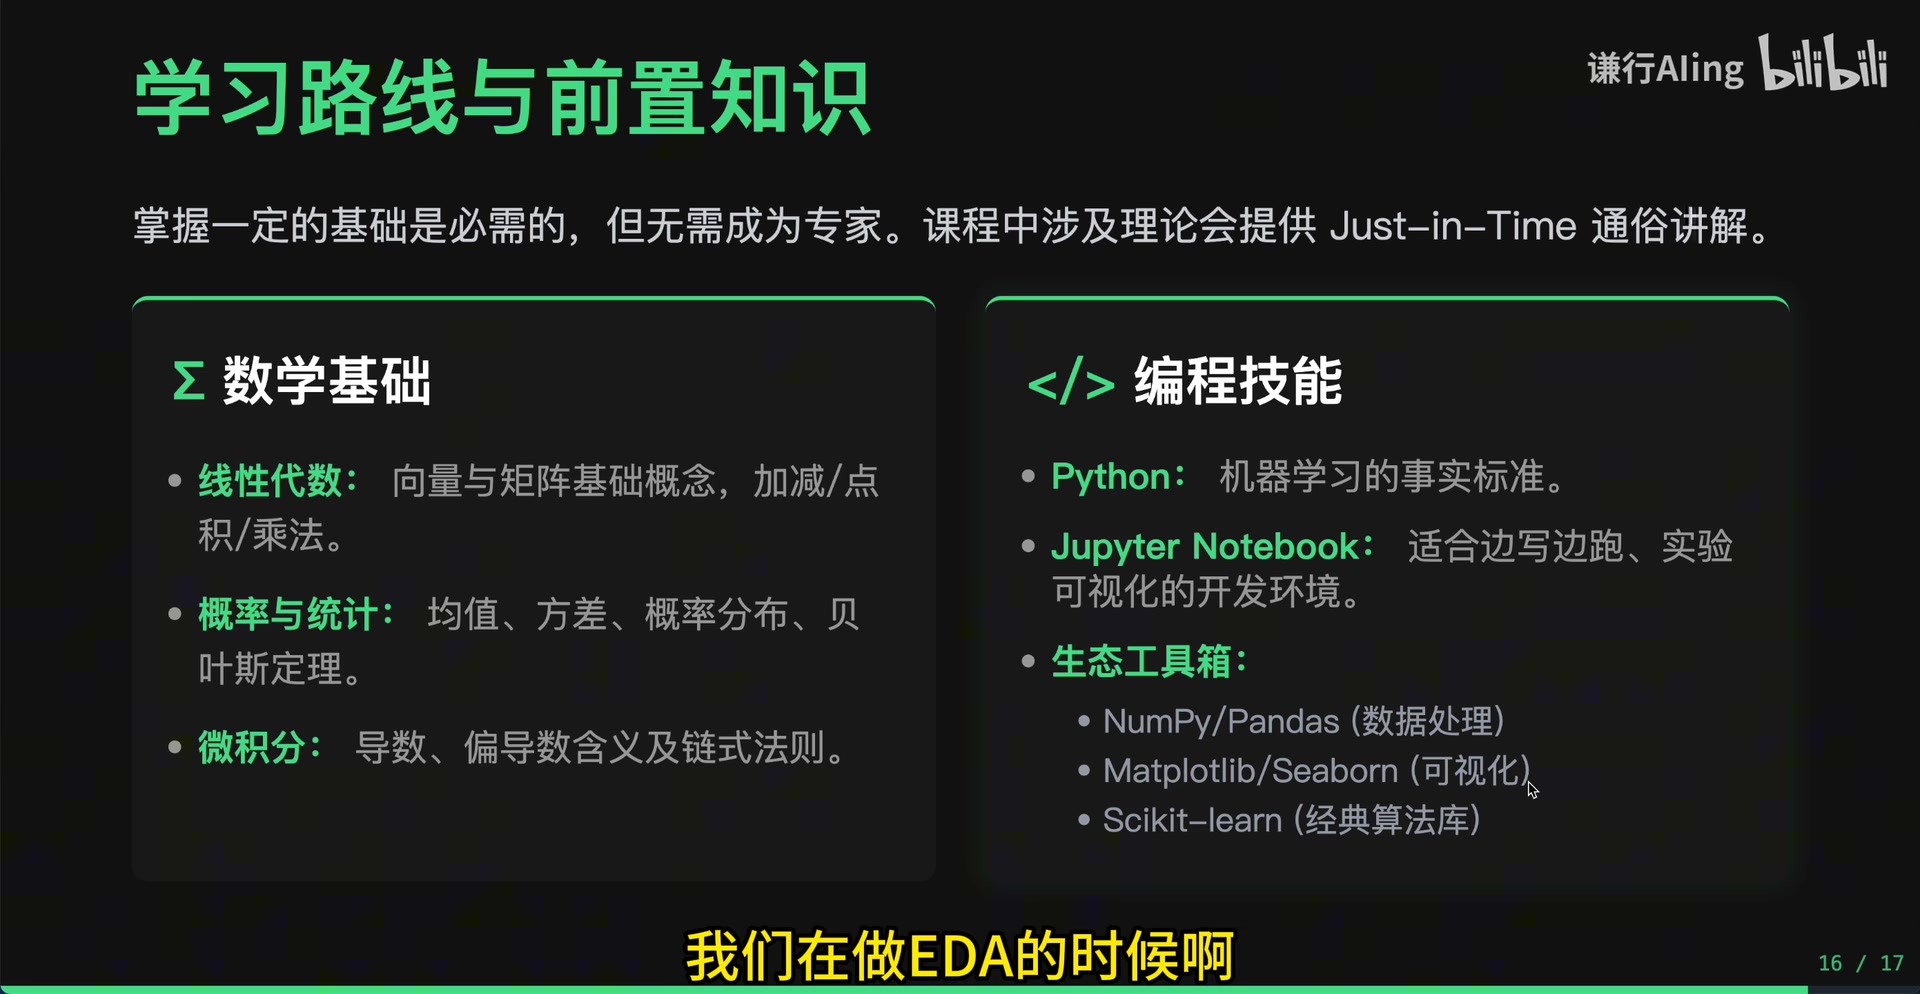
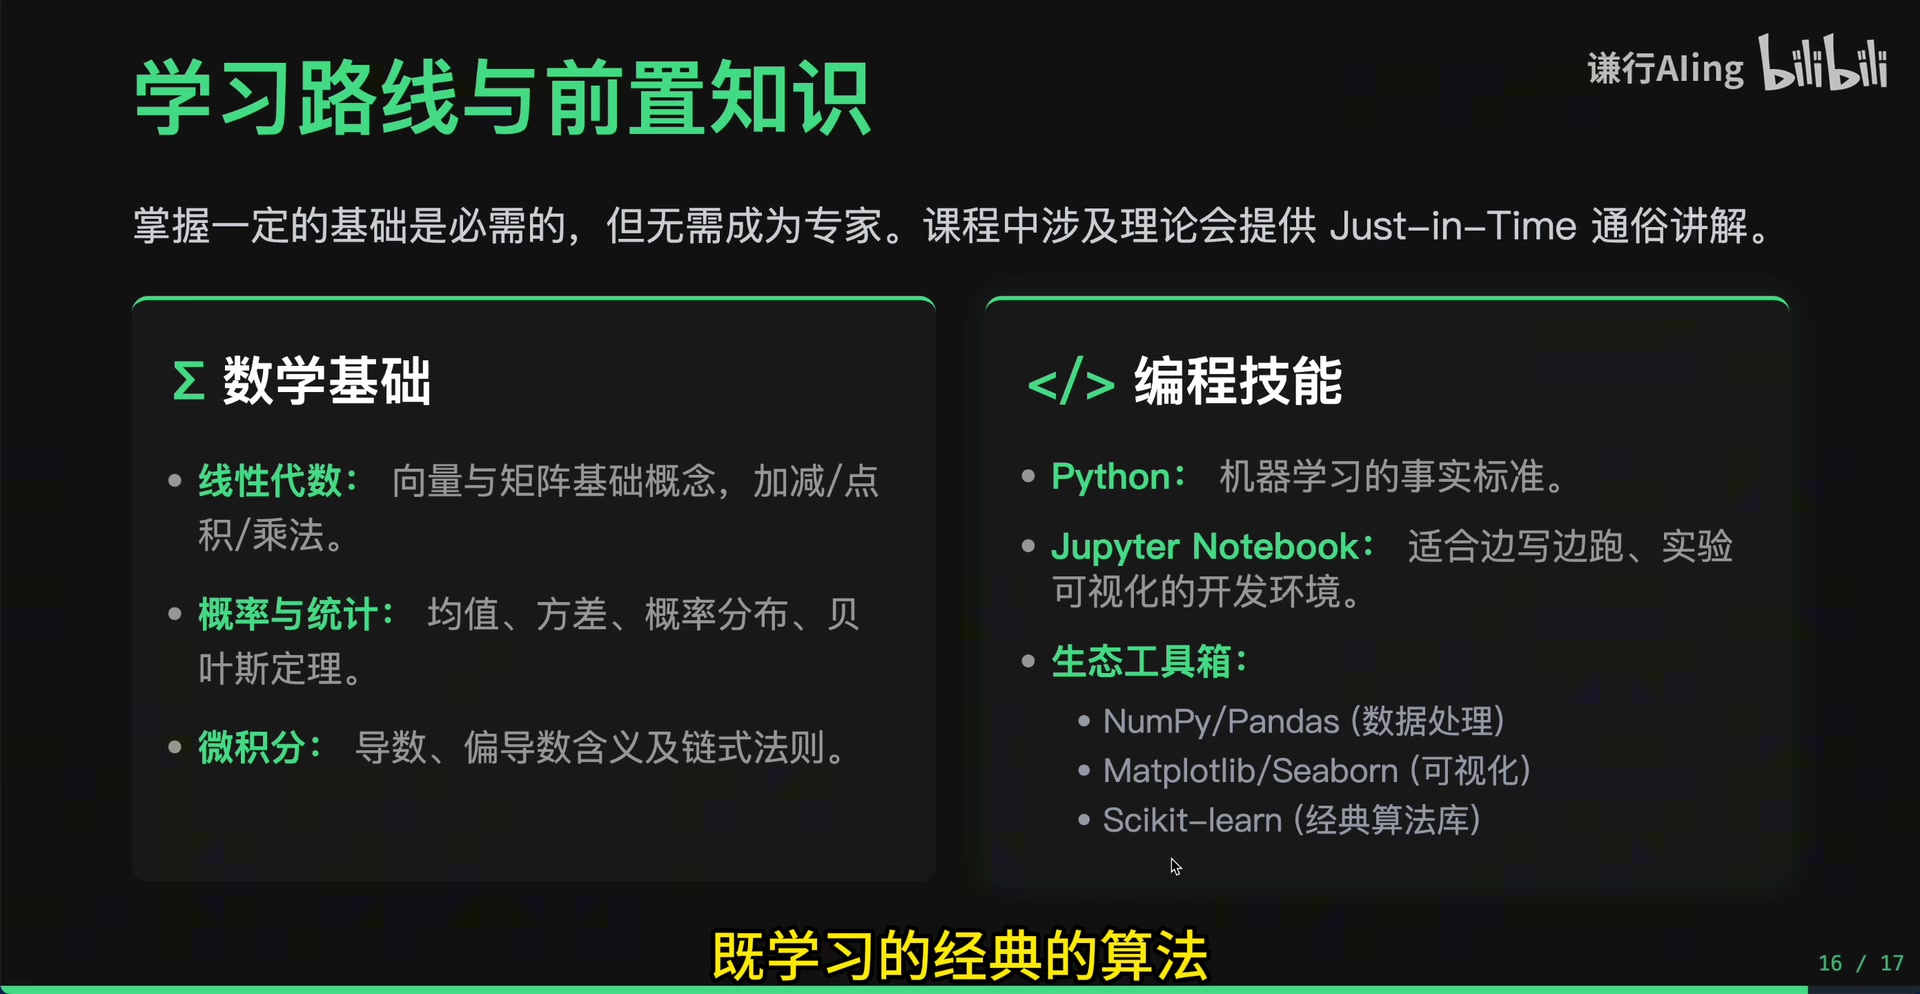
- 线性代数:理解向量、矩阵的基本概念,掌握加减、点积、矩阵乘法运算。
- 概率与统计:理解均值、方差、常见简单概率分布,了解贝叶斯定理。
- 微积分:理解导数、偏导数的含义,了解链式法则(用于理解反向传播,即使不懂原理知道怎么用也可以)。
3.2 入门前置要求总述
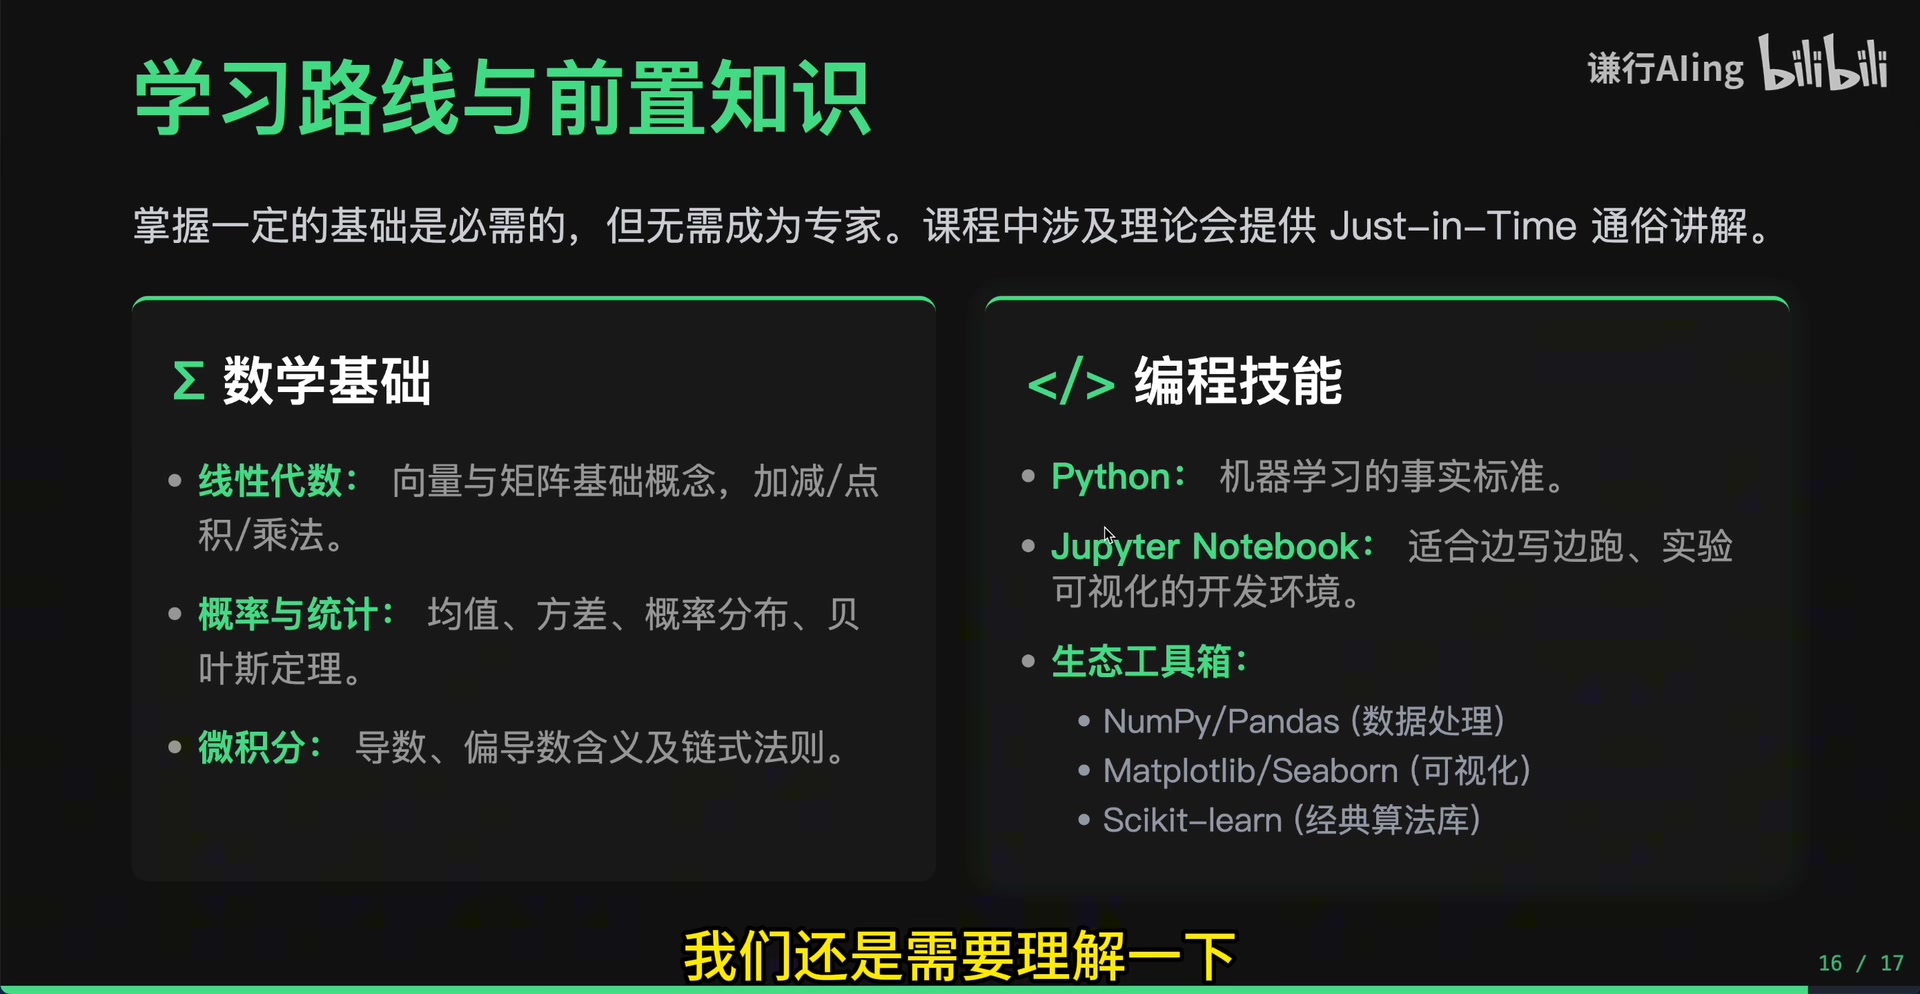 *
学习机器学习仅需要掌握必要的基础能力,无需成为相关领域的专家;课程中涉及的相关理论会提供Just-in-Time通俗讲解,学习者无需提前深入学习进阶知识。
3.3 编程技能要求
3.3.1 Python基础
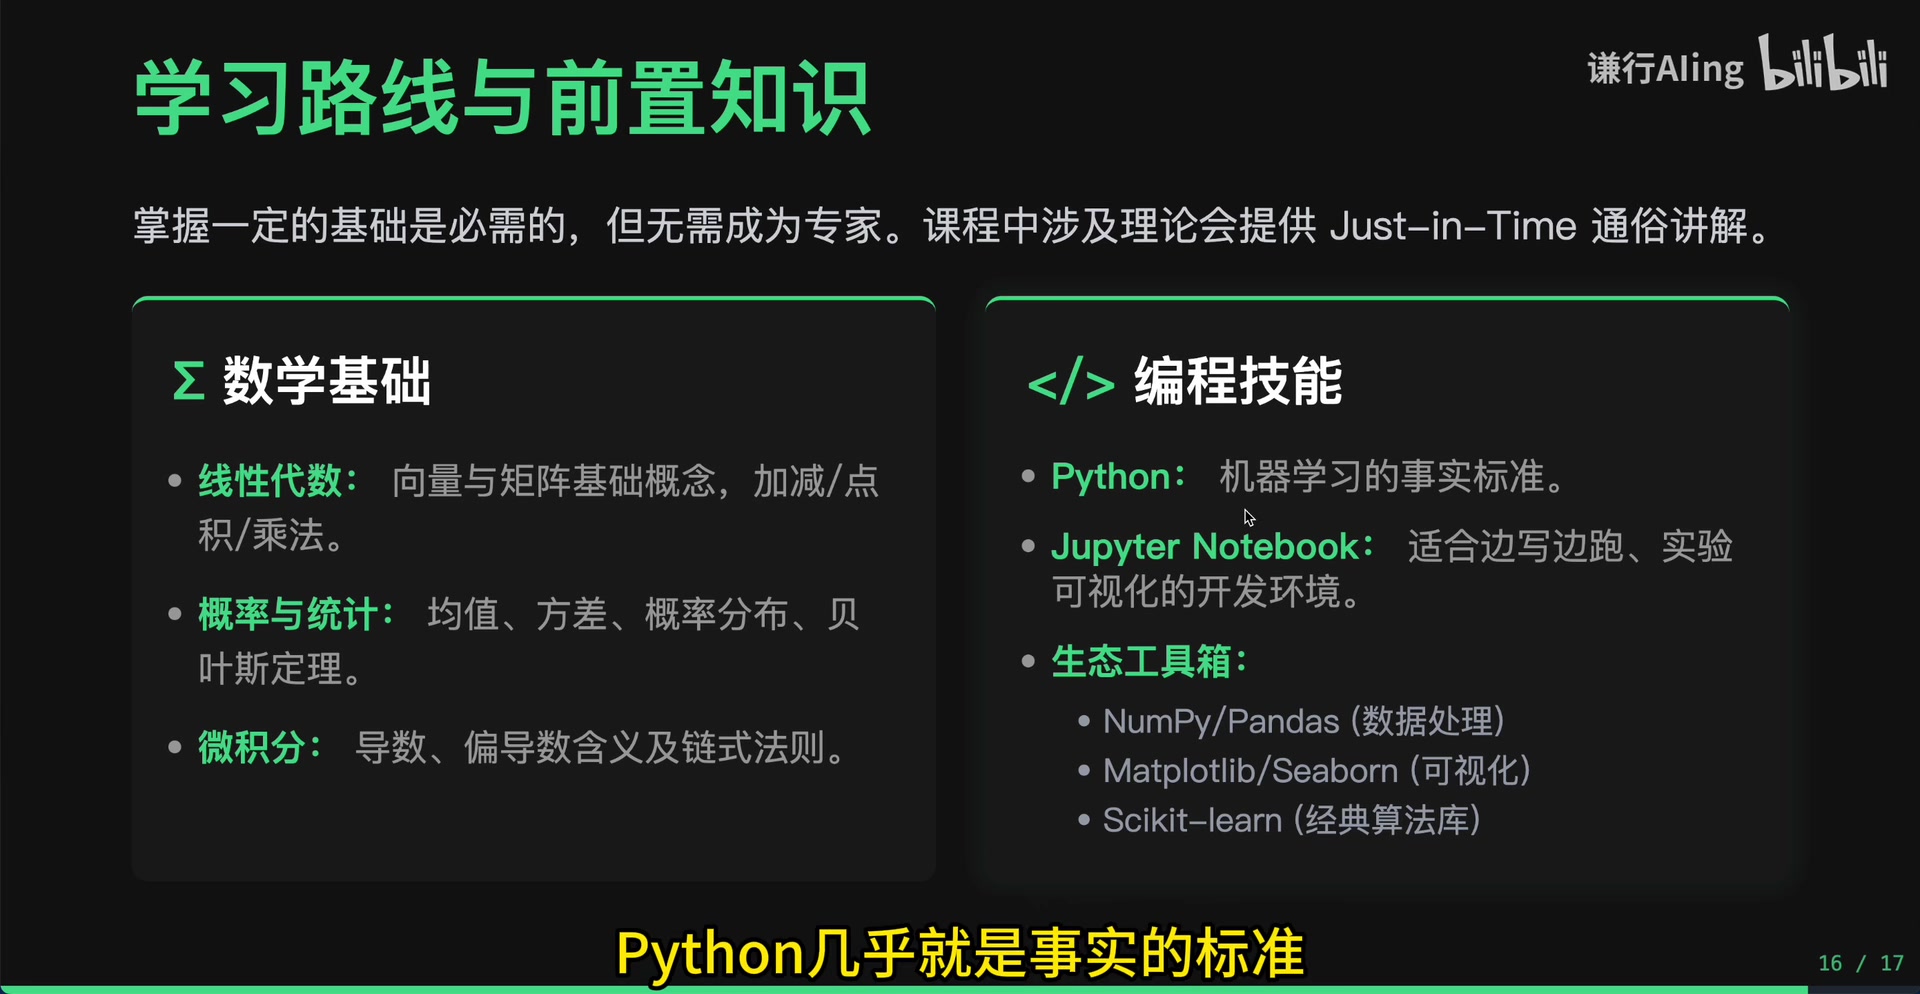 *
Python是机器学习领域的事实标准开发语言,仅需要掌握Python基础语法就可以继续学习机器学习。
3.3.2 开发环境:Jupyter Notebook
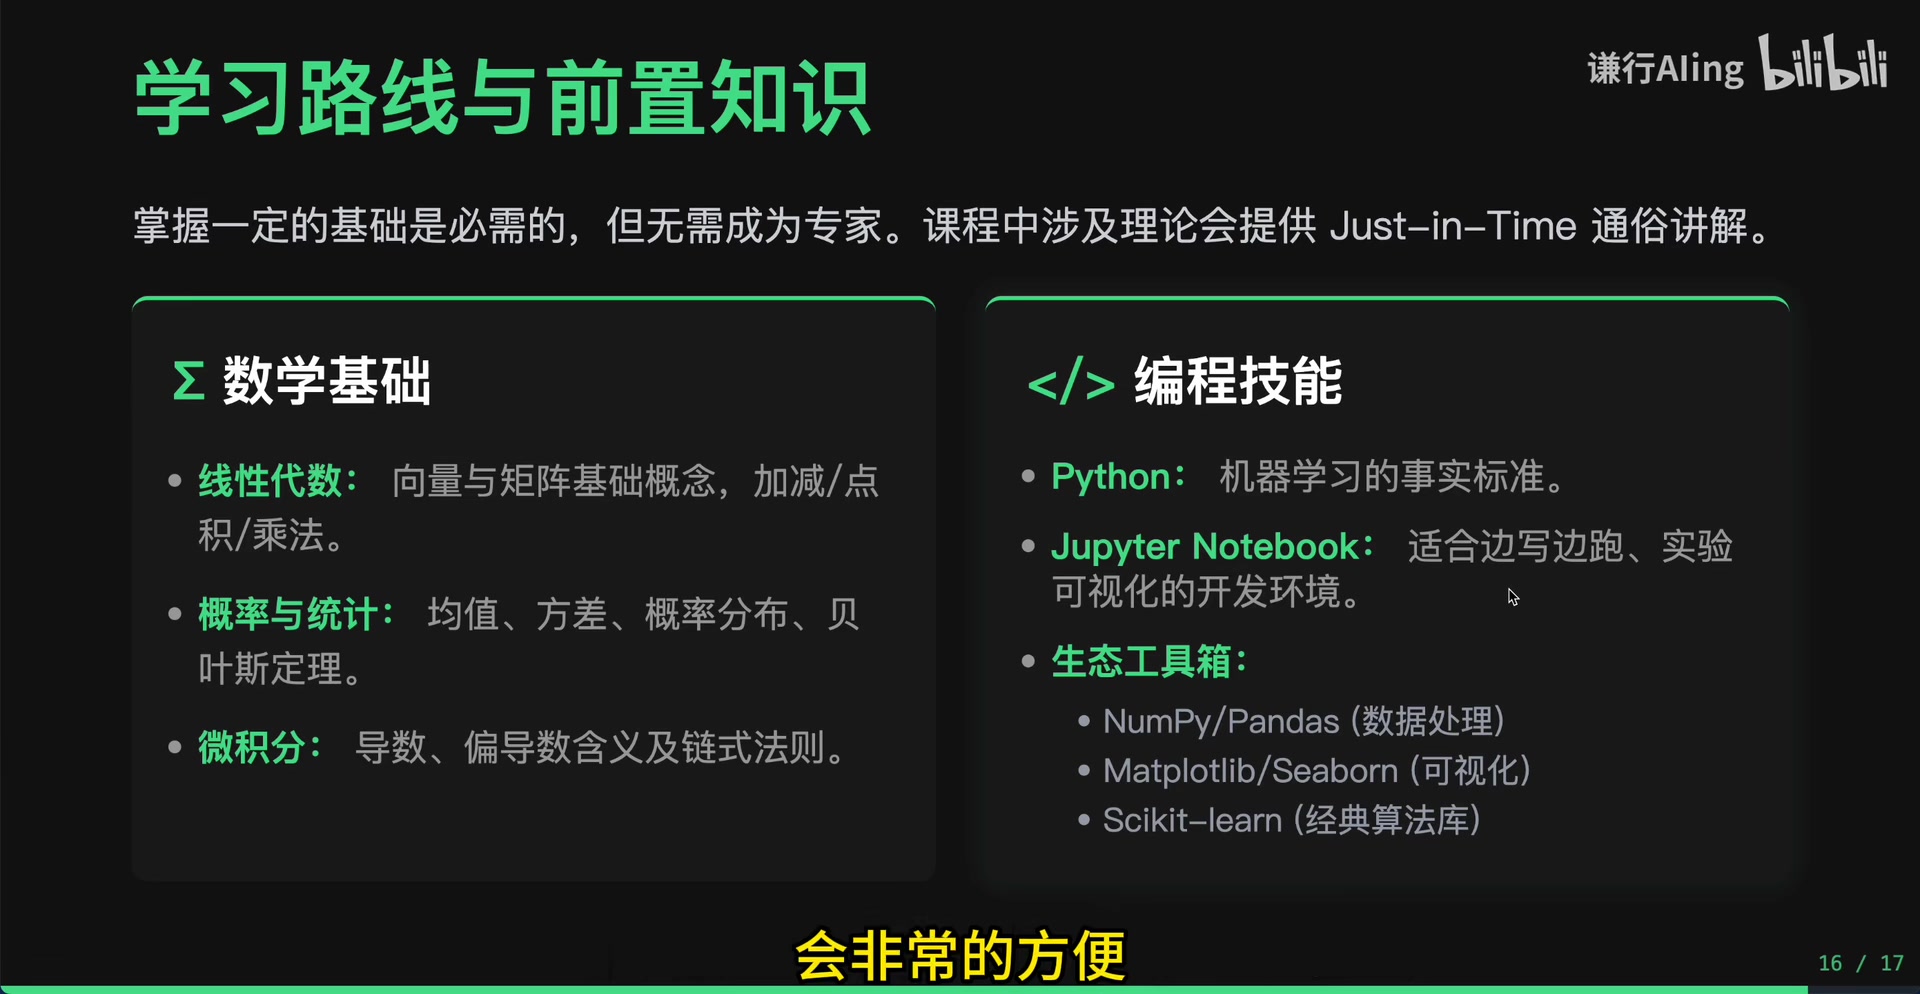 *
Jupyter Notebook是机器学习主流开发环境,支持边编写代码边查看执行结果,自带可视化能力,方便做实验和数据可视化,使用非常便捷,有Python基础的开发者大多都掌握该工具。
3.3.3 Python生态工具箱
机器学习入门会依赖成熟的第三方库,不需要从零实现相关能力,共分为三类:
数据处理类:NumPy、Pandas:用于完成数据处理、数据清洗工作
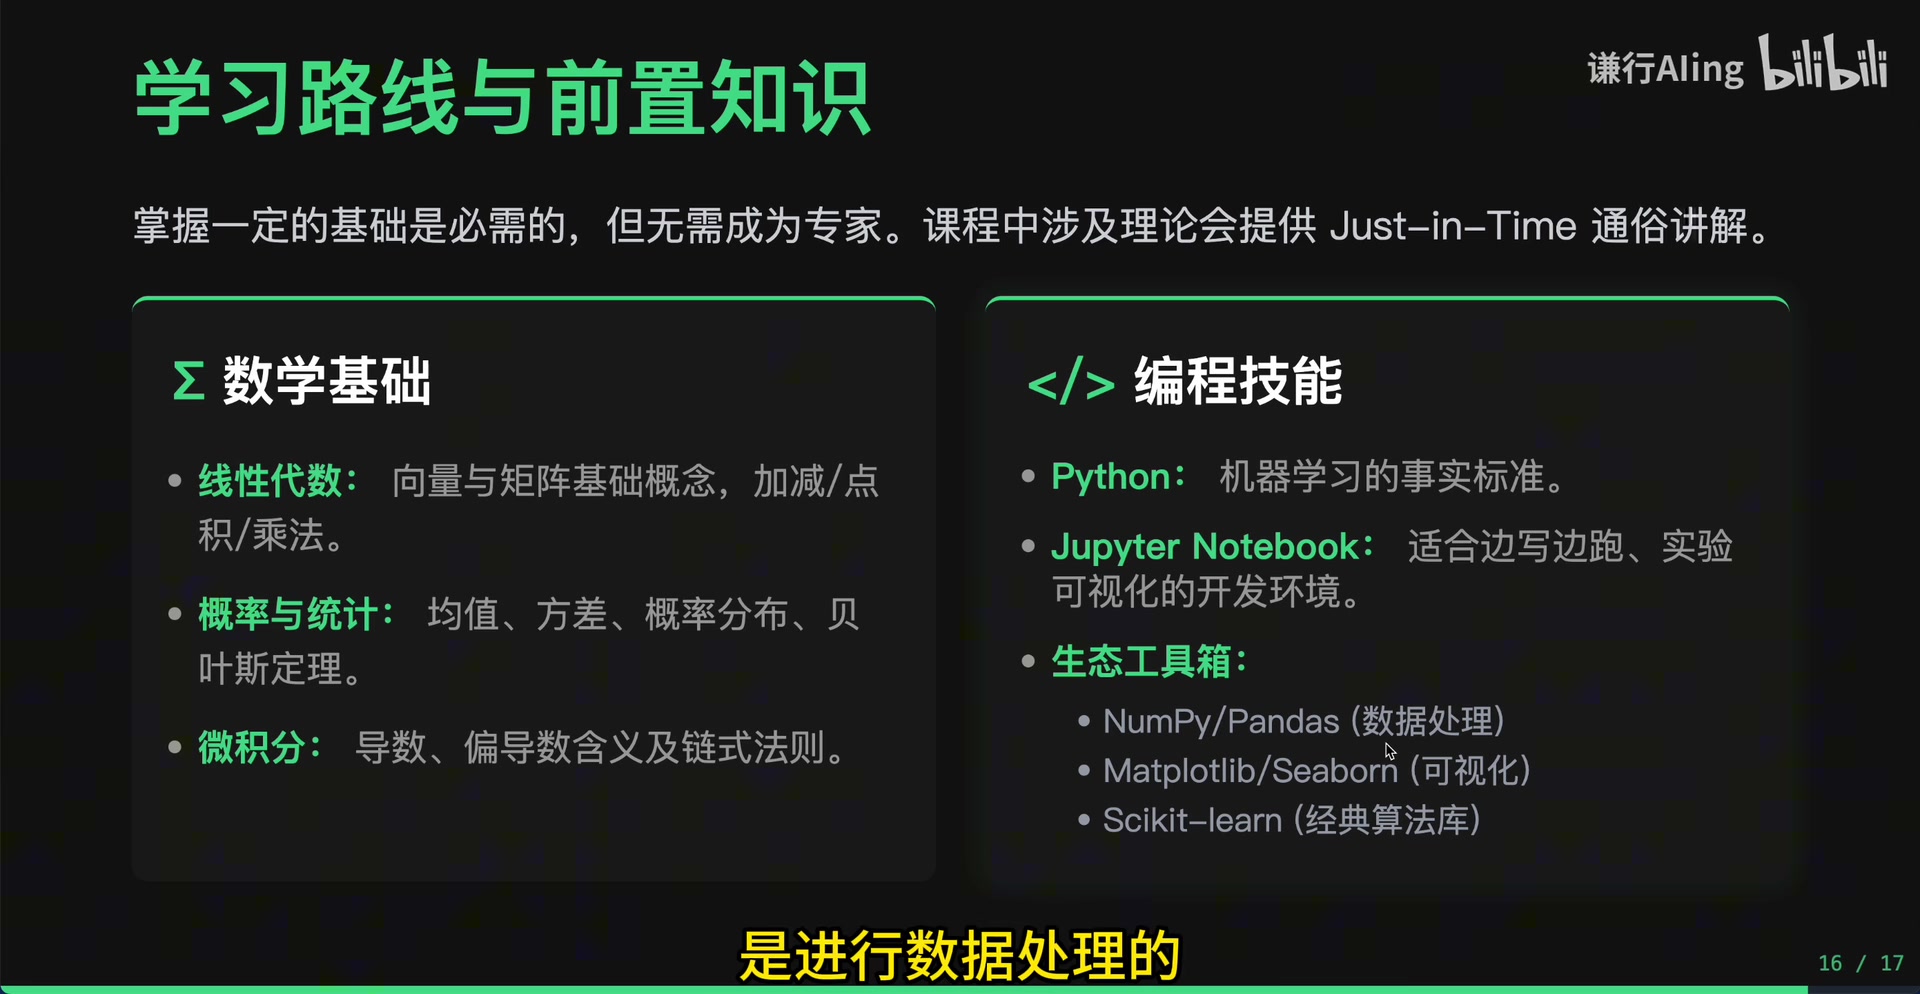 *
数据可视化类:Matplotlib、Seaborn:用于EDA(探索性数据分析)、数据探索场景,可用于查看数据分布、挖掘数据内在规律,特征处理阶段也会使用该类工具。
 *
经典算法库:Scikit-learn:已经封装了所有主流的经典机器学习算法,无需重复造轮子,可以直接调用使用。
 *
仅需要掌握Python基础语法,就可以开始机器学习的学习,无需提前精通所有工具库。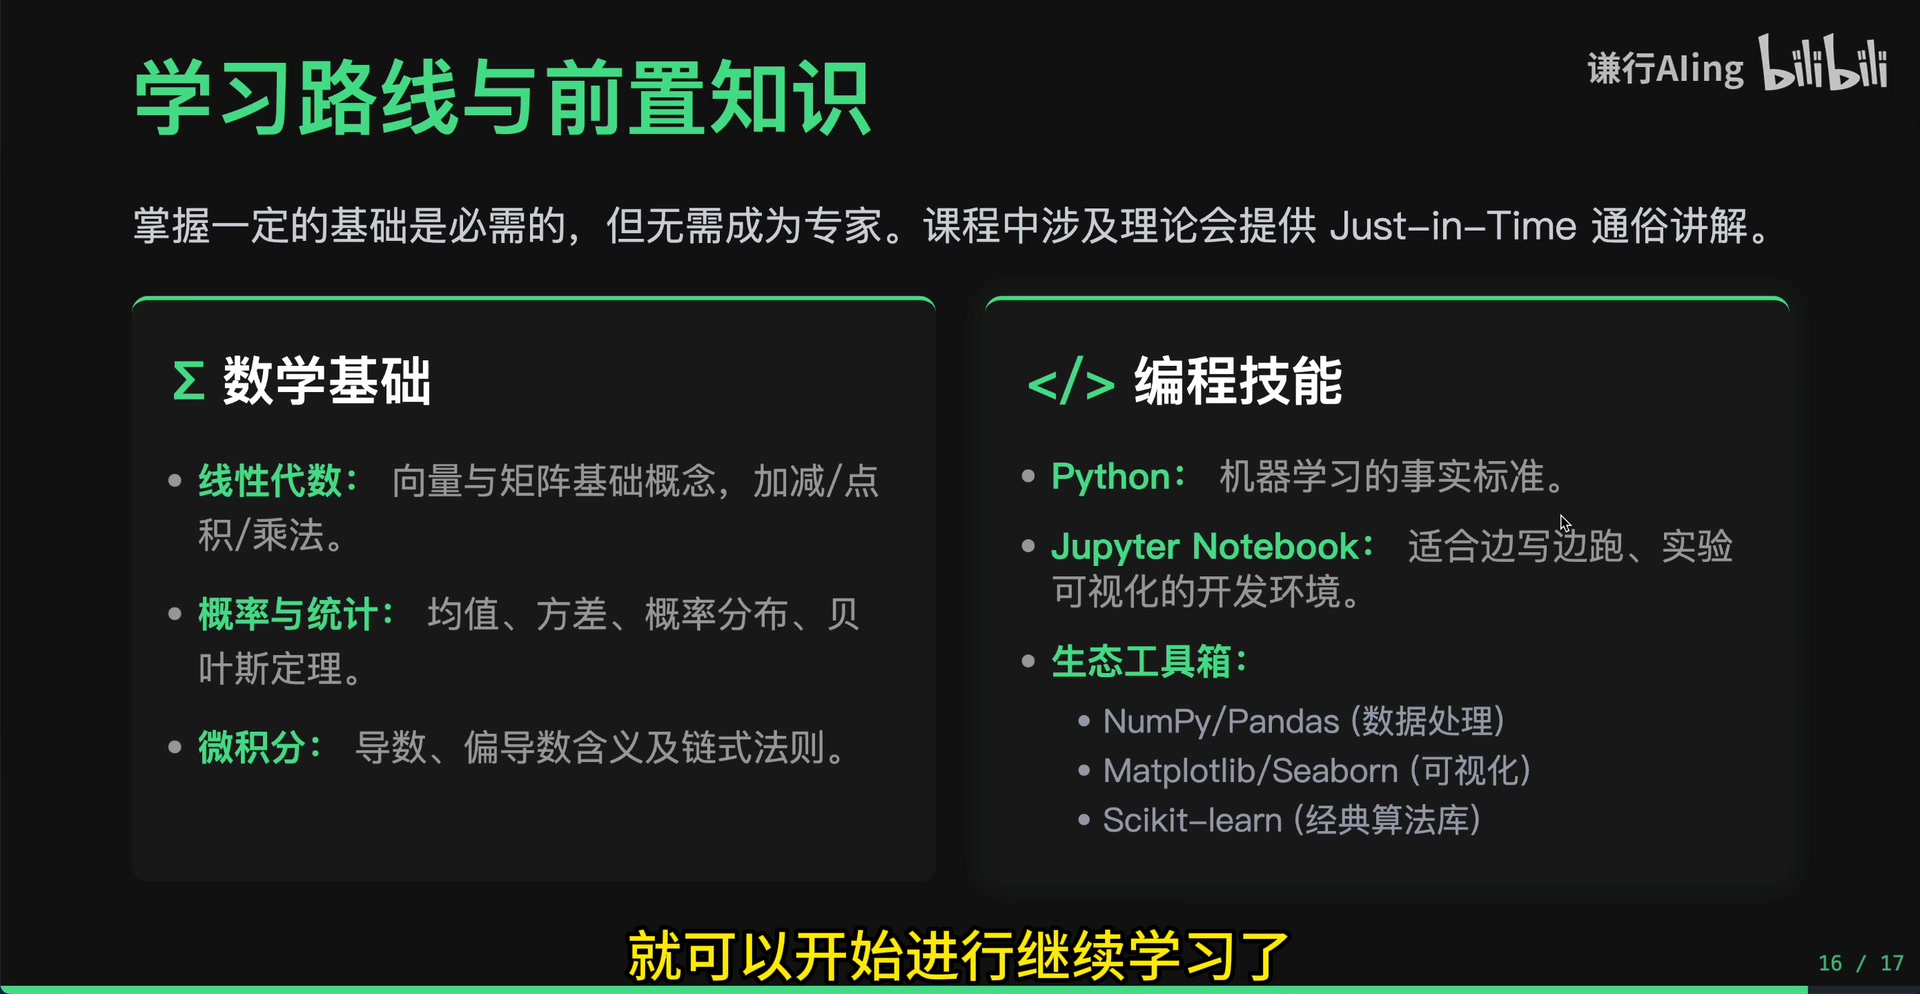 *
3.4 核心知识点汇总
- 机器学习入门无需成为数学或编程领域专家,课程会对涉及的理论提供即时通俗讲解
- 入门基础分为「数学基础」和「编程技能」两大模块
- Python是机器学习领域的事实标准开发语言
- Jupyter Notebook是机器学习主流开发环境,支持边写代码边验证结果
- 机器学习入门依赖三类成熟的Python工具库,无需从零实现相关能力
AI 总结
本内容是机器学习零基础入门的第一课,系统搭建了机器学习的知识框架:首先清晰界定了人工智能、机器学习、深度学习三者的定义、区别与包含关系,明确了机器学习“从数据自动学规律做预测”的核心本质,澄清了“AI时代不用学编程”等常见误区;其次通过垃圾邮件分类模型从粗糙到精准的迭代示例,直观展示了建模的完整逻辑,揭示了机器学习的核心是通过数据自动学习特征的最优权重,同时点明了机器学习相比人类能处理海量高维特征的核心优势;最后系统讲解了机器学习的入门前置知识要求,明确入门机器学习不需要成为数学或编程领域的专家,仅需掌握基础的线性代数、概率统计、微积分概念,以及Python基础语法即可起步,同时介绍了机器学习入门的标准工具栈:使用Jupyter Notebook作为开发环境,依托NumPy/Pandas完成数据处理、Matplotlib/Seaborn完成数据可视化、Scikit-learn调用封装好的经典算法,大大降低了机器学习的入门门槛,打消了初学者的畏难情绪,适合新手快速建立对机器学习的整体认知,为后续深入学习打下坚实基础。
refer
-
声明:
若文章存在错误,望诸君不吝指正^
blog仅供个人记录学习所用部分笔记由于年代久远,做的笔记找不到最初是引用谁的,若是不允许引用转载,请联系我