4-线性回归——机器学习的第一个模型
线性回归——机器学习的第一个模型 学习笔记
📖 笔记概览
本笔记系统整理了线性回归(Linear Regression) 的核心知识点,作为机器学习入门的第一个模型,线性回归是理解整个机器学习与深度学习理论体系的基石。
核心知识点清单
| 知识模块 | 主要内容 |
|---|---|
| 直观理解 | 房价-面积案例引入,通过画一条直线拟合数据规律 |
| 概念解析 | 线性、回归、拟合、连续值预测的数学含义 |
| 模型表达 | 单特征线性方程 $\hat{y} = wx + b$,参数 $w$(权重)、$b$(偏置) |
| 损失函数 | 均方误差 MSE 的定义、原理与优势 |
| 优化算法 | 梯度下降法的原理、下山比喻、学习率概念 |
| 训练流程 | 输入数据 → 预测 → 计算损失 → 求梯度 → 更新参数 → 迭代 |
| 多特征扩展 | 多元线性回归、向量化表达、矩阵运算 |
| 多项式回归 | 非线性拟合、本质仍是线性回归(对参数线性) |
| 延伸方向 | 逻辑回归(分类问题)、深度学习(多层堆叠) |
一、为什么要学习线性回归
- 线性回归是机器学习课程的理论基础,掌握它就能理解机器学习的工作原理:如何从数据中发现规律,并用规律预测未来数据。
- 它也是后续学习的基础:
- 逻辑回归(分类问题)
- 深度学习(神经网络)
二、直观理解:房价预测案例
2.1 问题引入
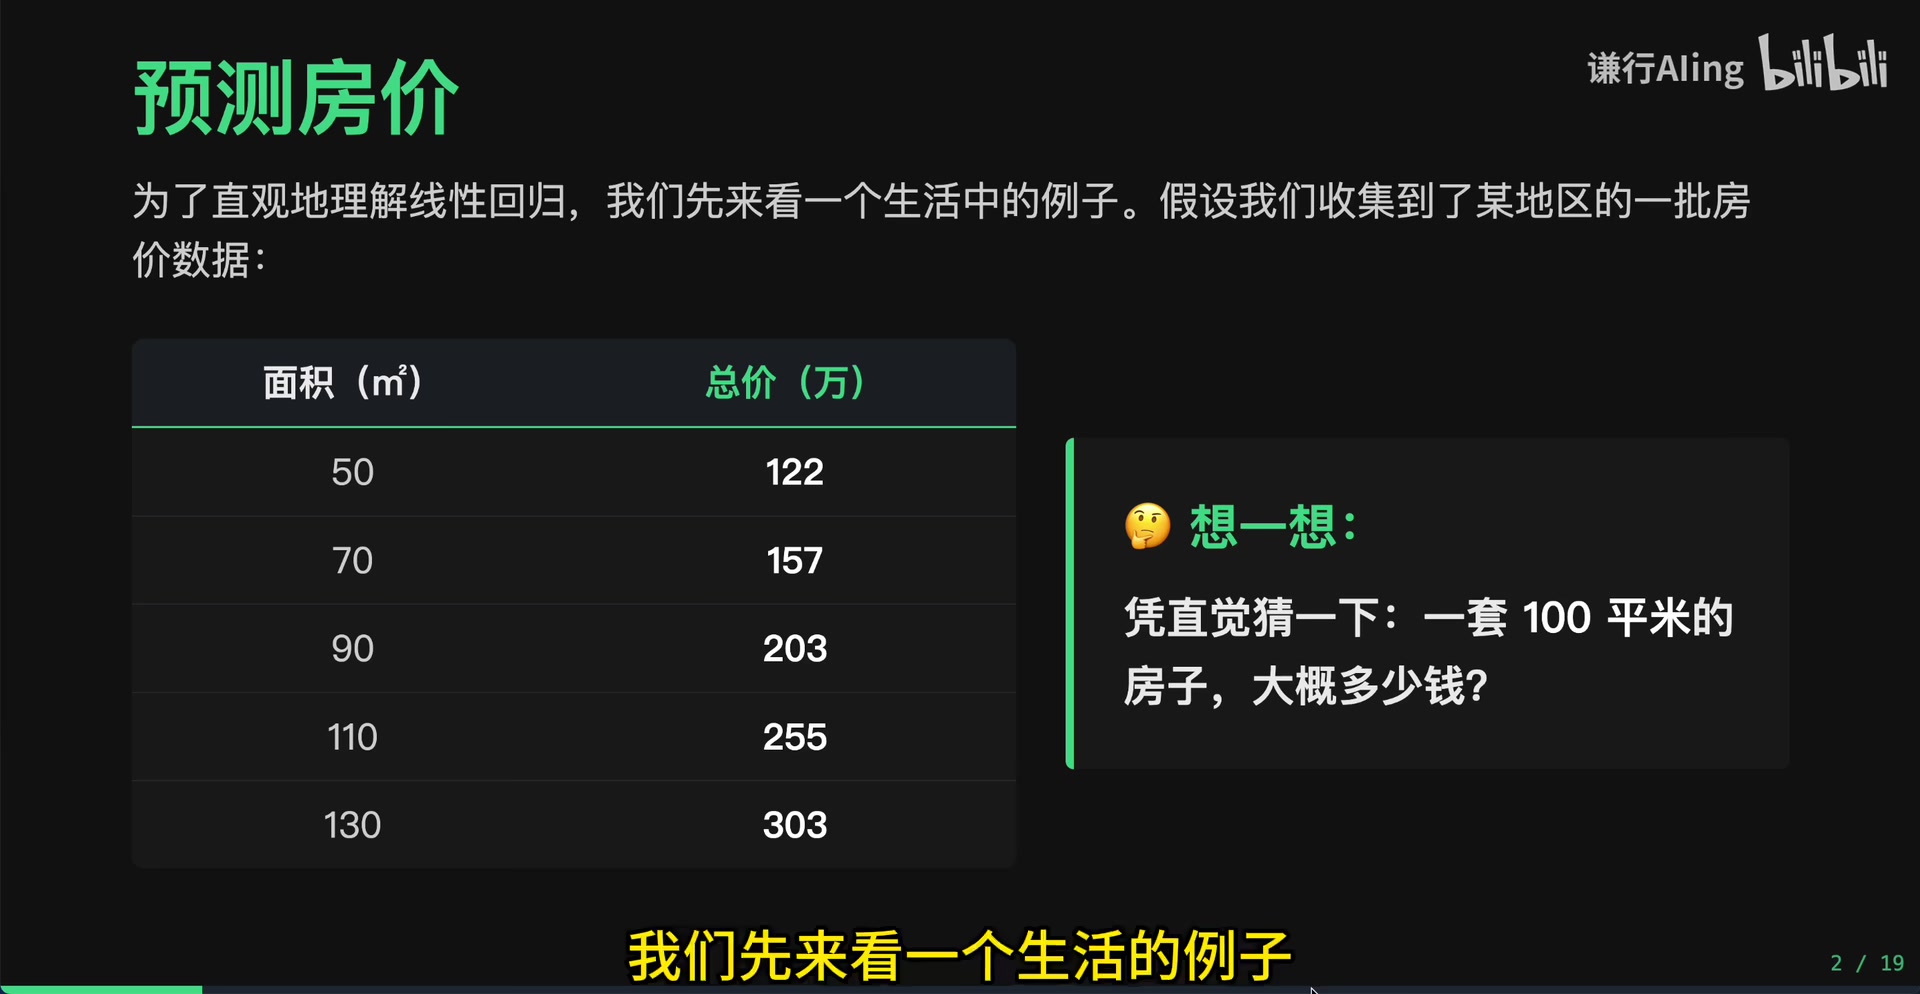
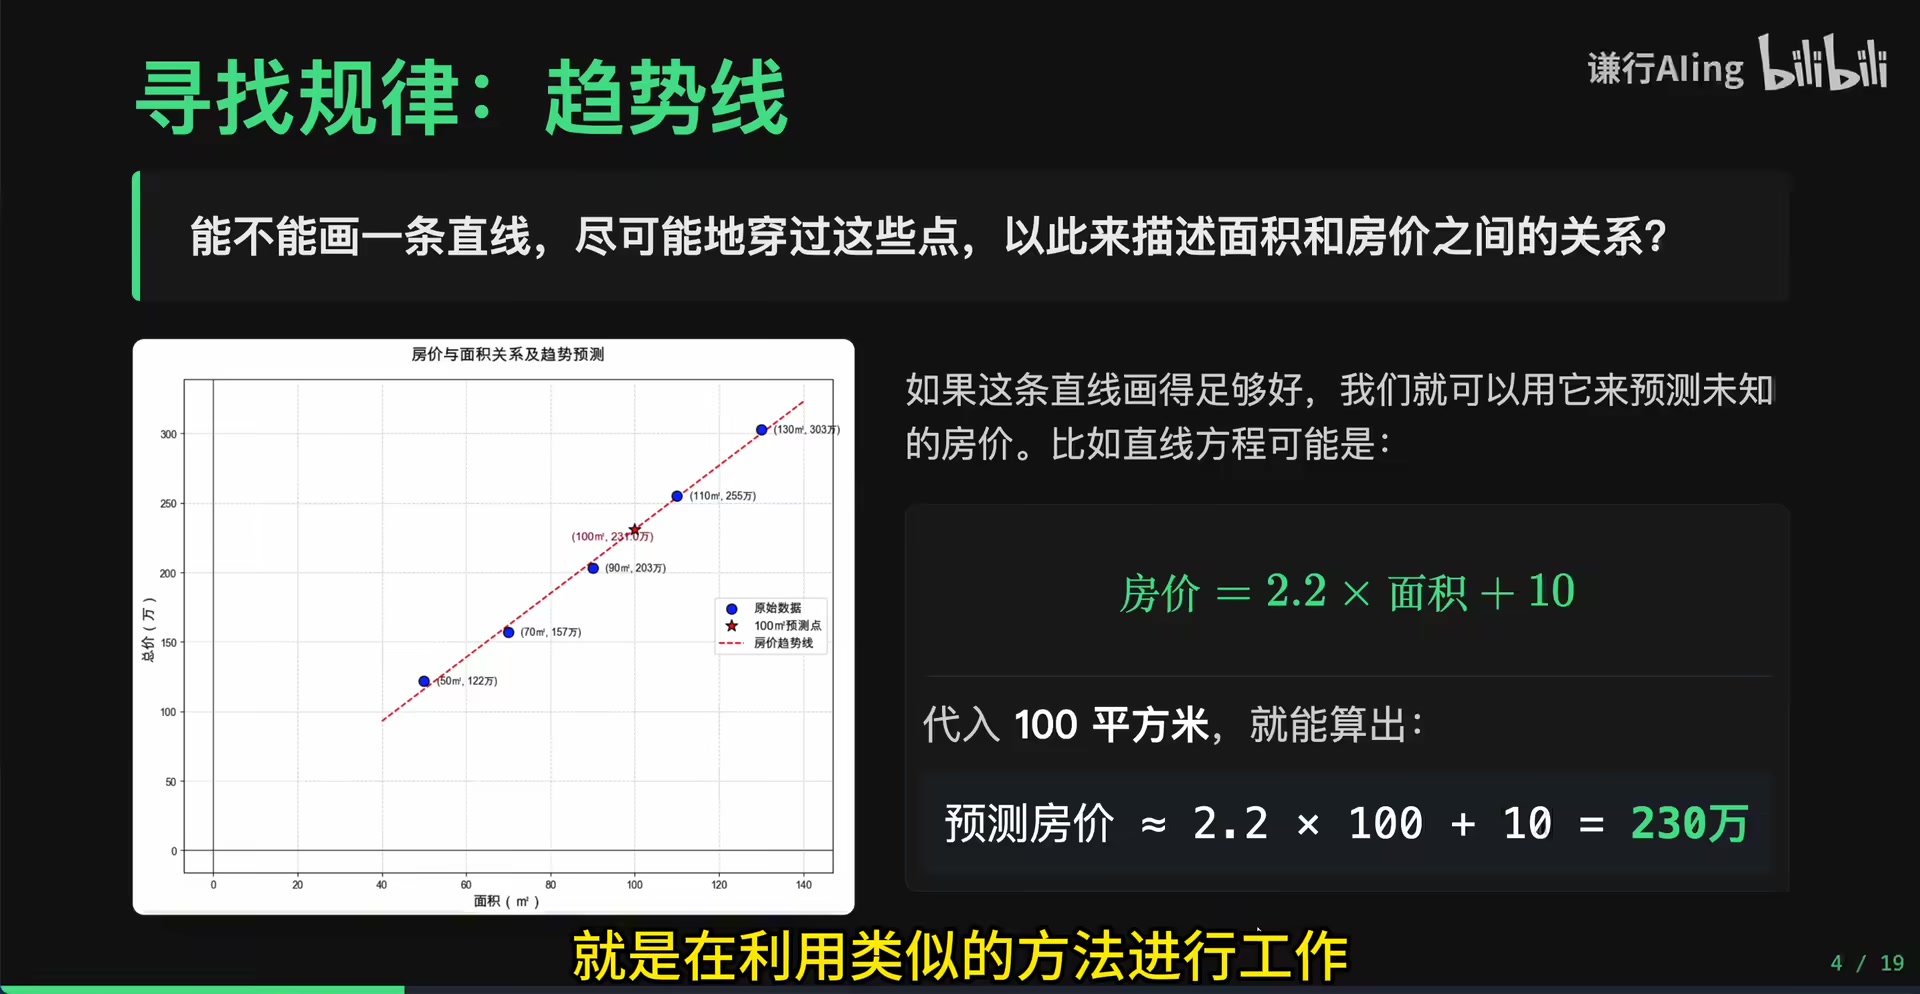
假设有一个地区的房价与面积数据:
- 凭直觉观察:面积越大,房价越高(正相关)
- 100平的房子 → 房价应在 203~255 万之间
 *
2.2 用直线拟合数据
将所有数据点画在坐标系上后发现:这些点大致可以被一条直线串联起来。
虽然不能严丝合缝,但每个点都离直线很近。于是尝试画一条直线,尽可能穿过这些点。
观察得到的直线大致表达式为:
$$\hat{y} = 2.2x + 10$$
代入 $x = 100$:$\hat{y} \approx 230$ 万 —— 比凭直觉的区间精准得多。
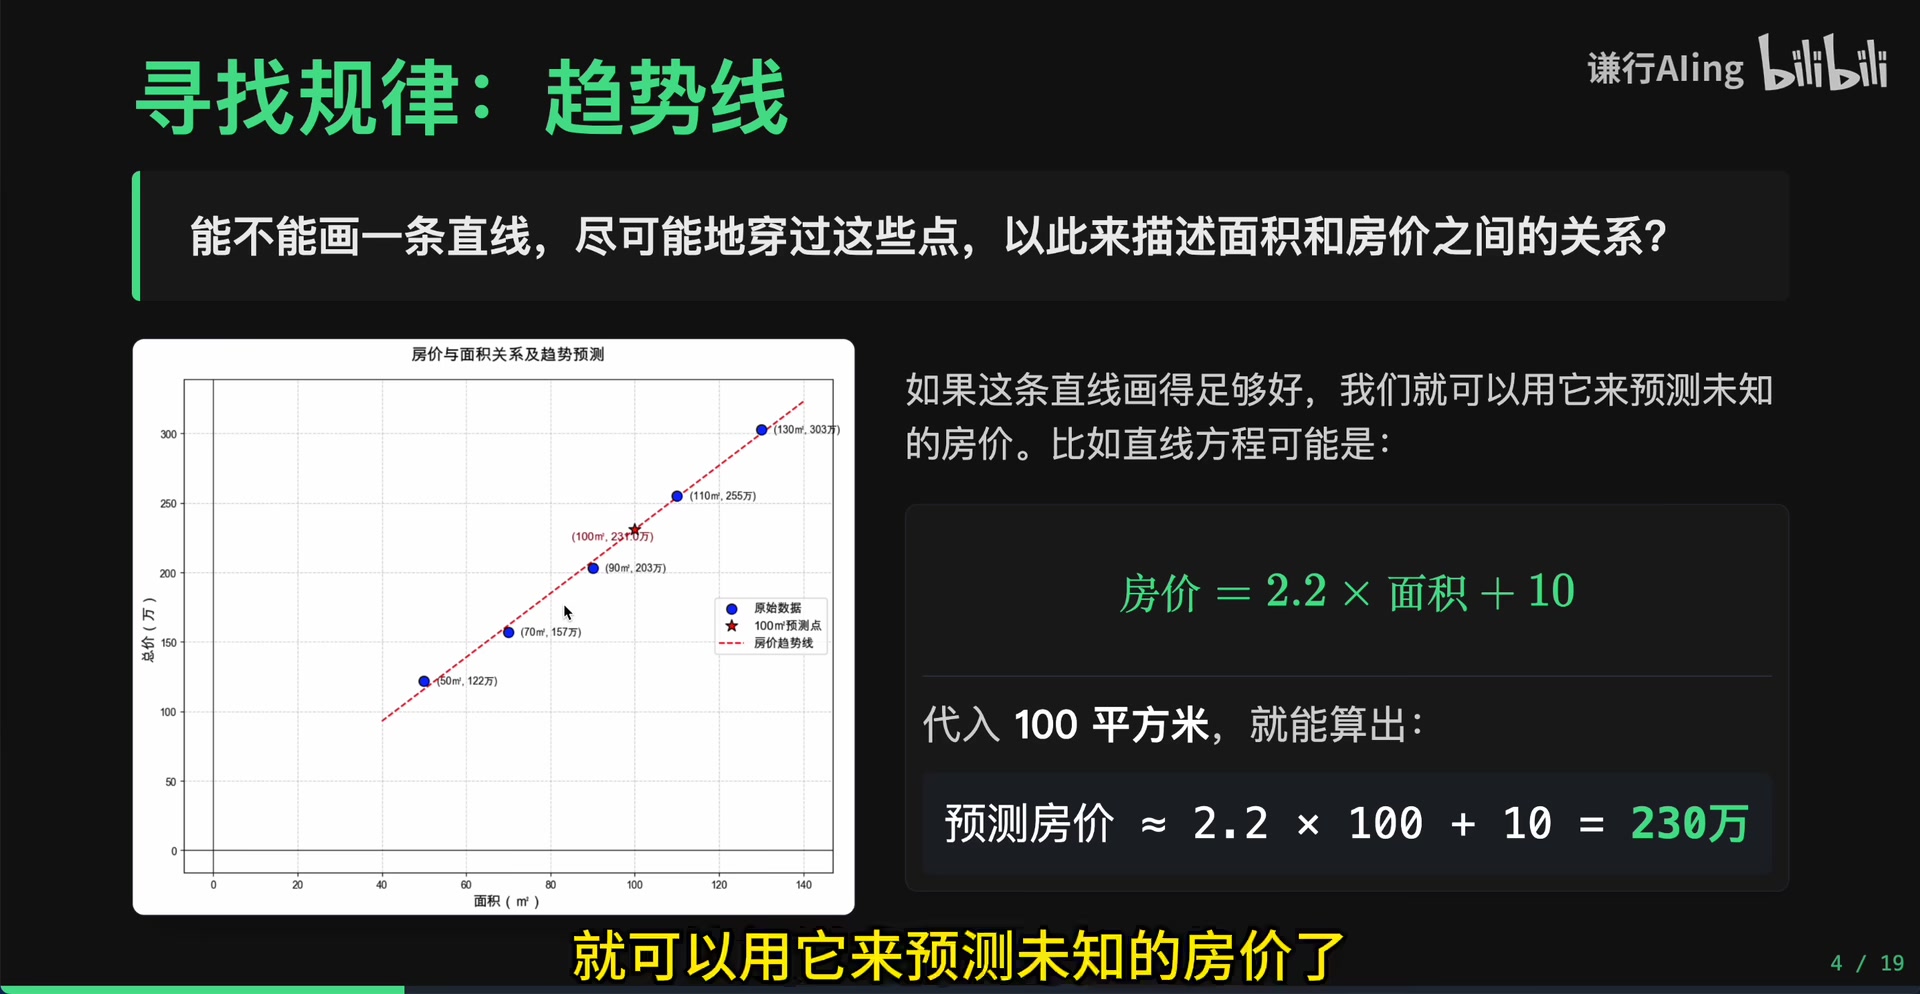 *
核心思想:寻找数据背后的规律,画一条尽可能拟合数据的直线,用于预测未知值。
三、线性回归的数学定义
线性回归通过构建线性方程来拟合数据的内在分布规律,从而实现对连续数值的预测。
3.1 关键概念解析
(1)什么是”线性”?
数学中线性指输入与输出按比例变化、可叠加,需满足两个性质:
- 比例性(齐次性):$f(ax) = a \cdot f(x)$
- 可加性:$f(x + y) = f(x) + f(y)$
⚠️ 注意:线性 不一定 是直线!
- 一维空间中:线性关系是一条直线
- 高维空间中:可能是平面或超平面
(2)什么是”拟合数据”?
为数据寻找一个函数规律,使其尽可能描述数据特征。
(3)什么是”连续数值”?
与”离散数据”相对。例如:
- 连续:房价、温度(任意实数)
- 离散:分类标签(猫/狗、垃圾邮件/正常邮件)
(4)什么是”回归”?
源自统计学中的**”回归均值”** 现象:身高极端的父母,其子女身高趋向群体平均值。
在机器学习中,”回归”被引申为:通过数据建模,找到输入与输出之间的映射关系,从而预测连续数值。
 *
四、线性回归模型公式
4.1 单特征模型
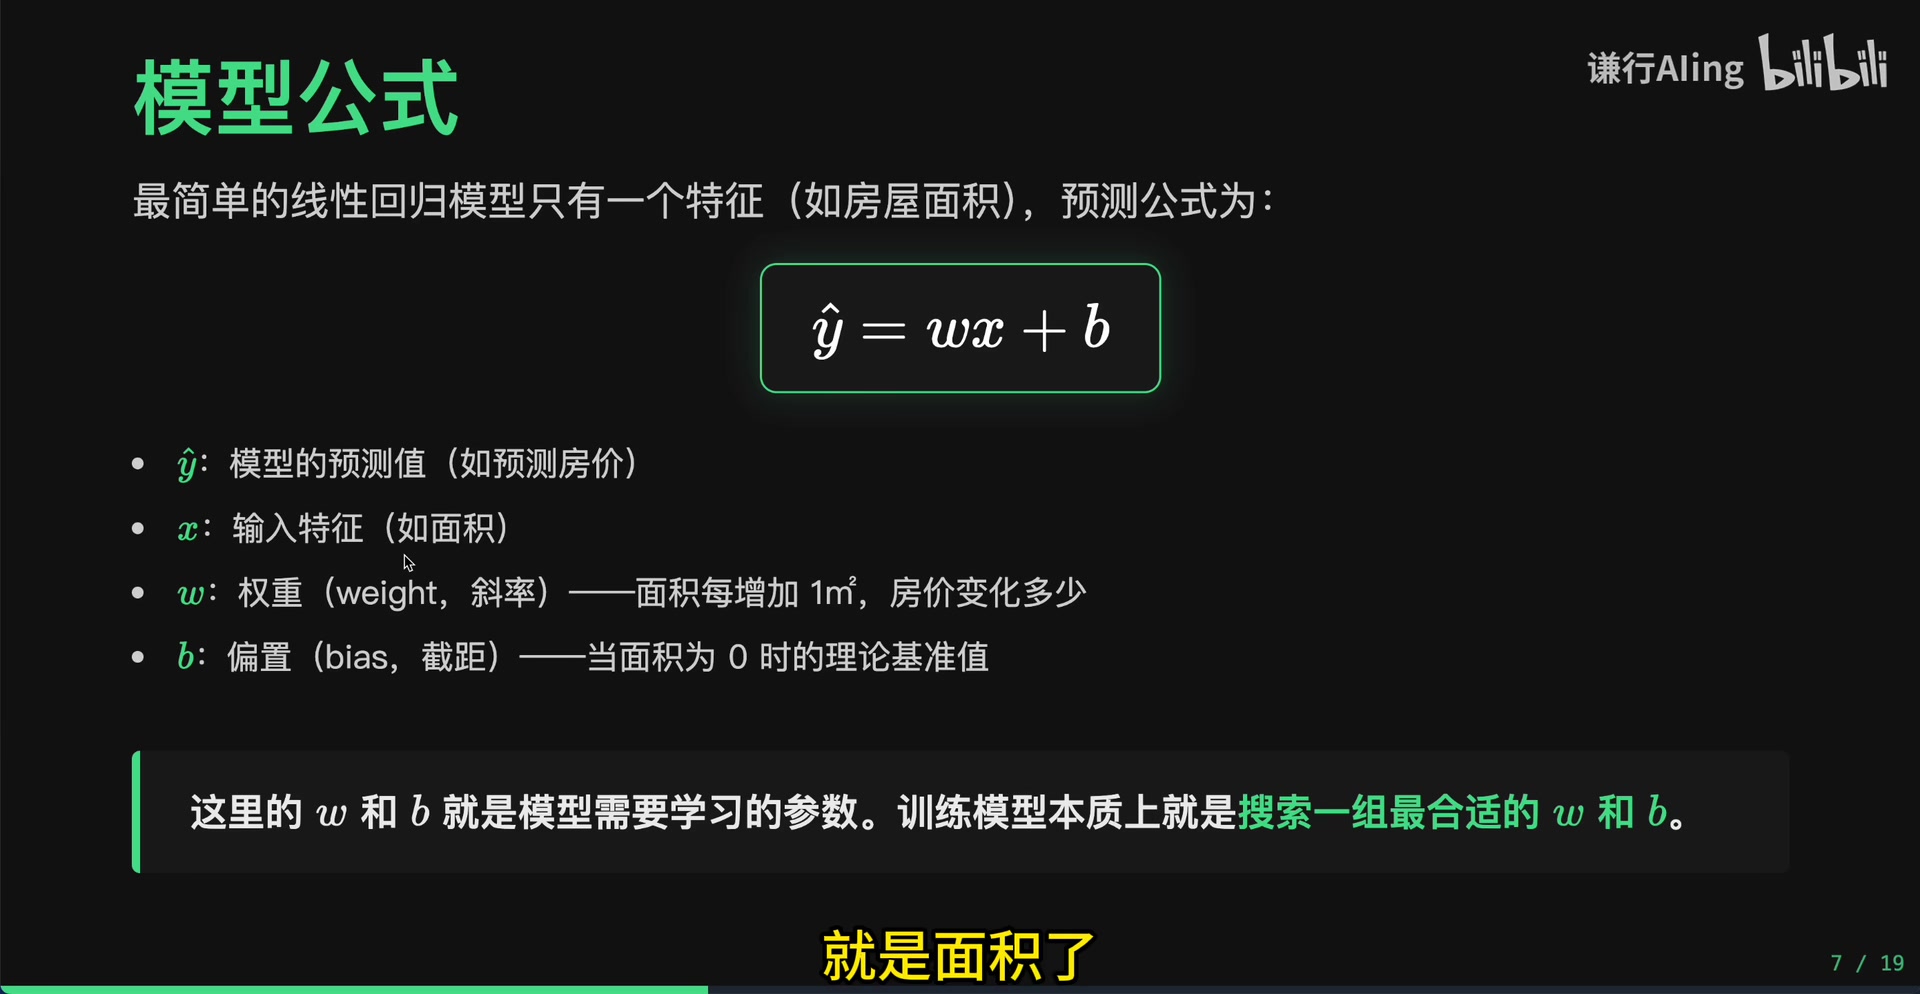
$$\hat{y} = wx + b$$
| 符号 | 含义 |
|---|---|
| $\hat{y}$ | 模型的预测值(带”小帽子”) |
| $x$ | 特征数据(如:面积) |
| $w$ | 权重(Weight):直线斜率,表示特征每增加1单位,预测值变化多少 |
| $b$ | 偏置(Bias):截距,特征为0时的理论基准值 |
重要:$w$ 和 $b$ 就是常说的模型参数。大模型所谓”多少B参数”,就是指 $w$ 和 $b$ 的总数。
4.2 训练的本质
训练模型的本质就是搜索一组最适合的 $w$ 和 $b$,让预测线尽可能贴近真实数据。
 *
五、损失函数(Loss Function)
5.1 为什么需要损失函数?
需要一种方法度量预测值与真实值之间的偏差,以判断当前参数好不好。
5.2 均方误差 MSE(Mean Squared Error)
线性回归中最常用的损失函数:
$$\text{MSE} = \frac{1}{N} \sum_{i=1}^{N} (\hat{y}_i - y_i)^2$$
| 符号 | 含义 |
|---|---|
| $N$ | 样本数量 |
| $\hat{y}_i$ | 第 $i$ 个样本的预测值 |
| $y_i$ | 第 $i$ 个样本的真实值 |
5.3 MSE 的两大优势
1. 消除正负号影响
- 若仅使用 $\hat{y} - y$,正负误差可能相互抵消,明明预测不准却得到 0
- 平方后所有误差都为正数,避免抵消
2. 放大误差,便于优化
- 例:误差 $3$ 平方后为 $9$;误差 $0.4$ 平方后为 $0.16$
- 大误差被进一步放大(惩罚项),小误差变得更小,优化方向更明确
训练目标:让 MSE 尽可能小(理想情况接近 0)。
六、优化算法:梯度下降(Gradient Descent)
6.1 核心思想
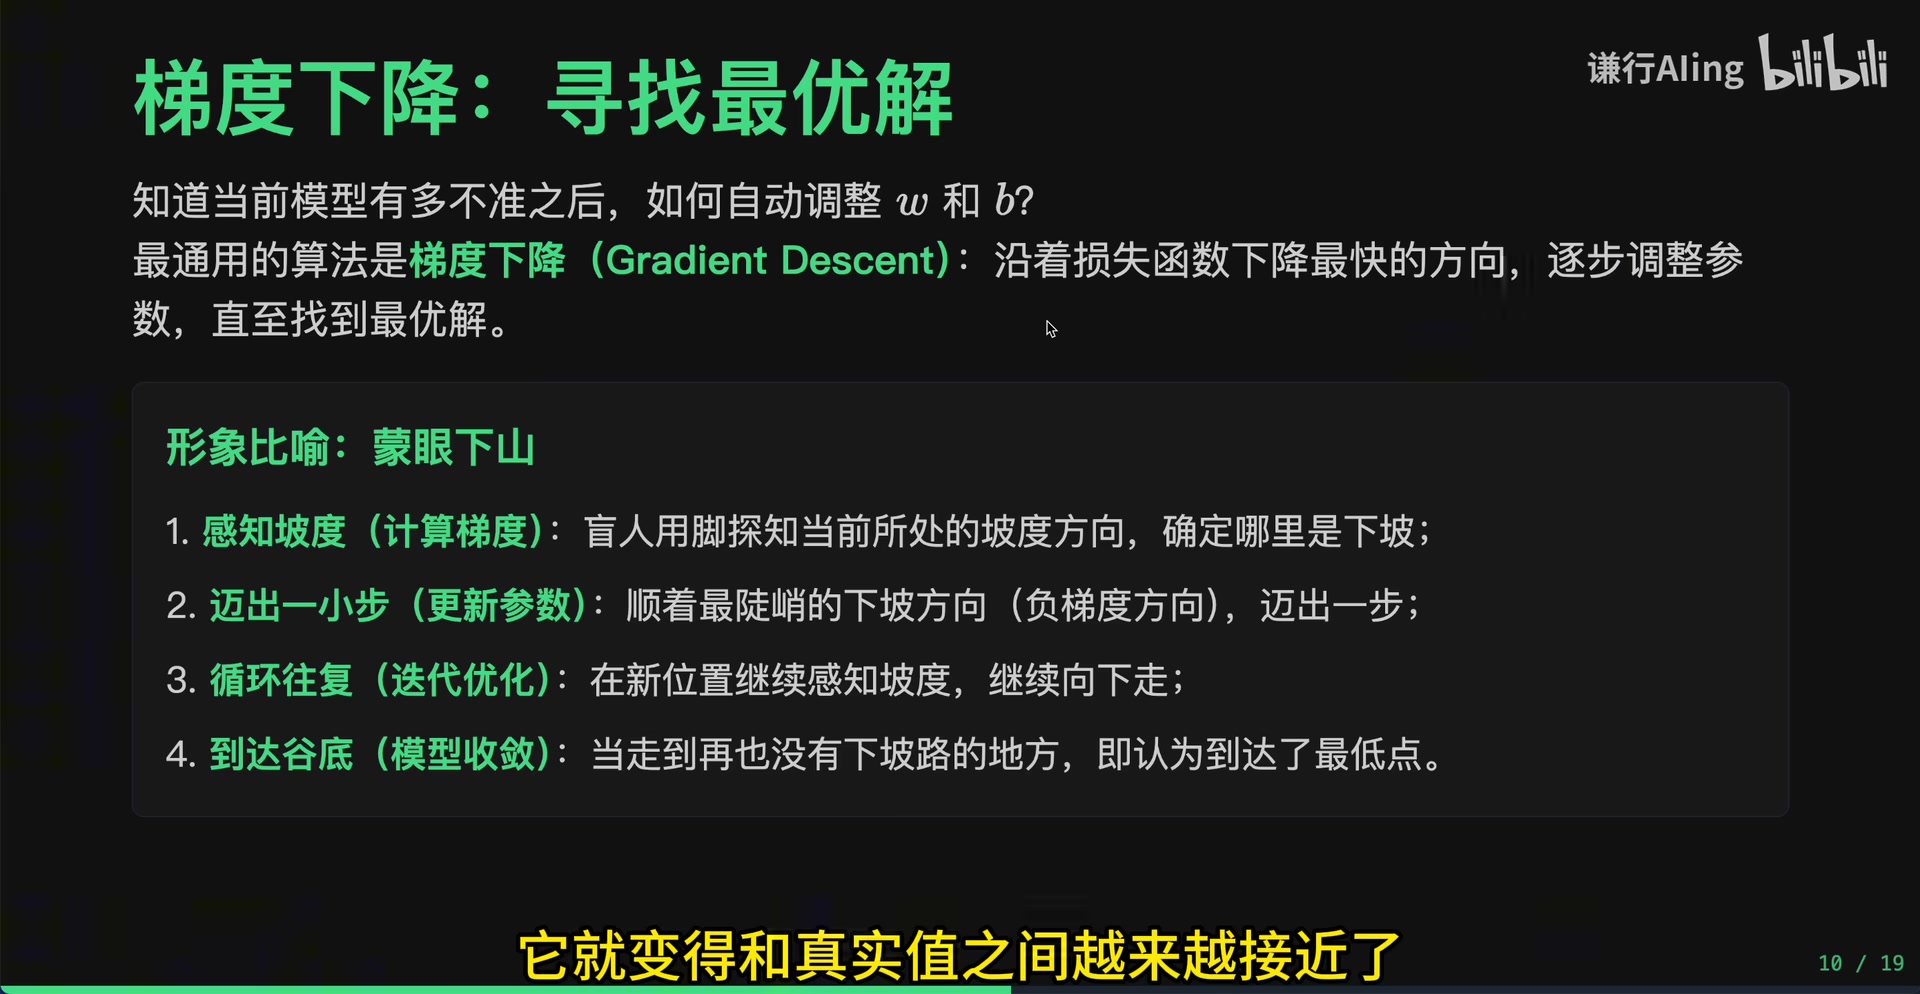
对损失函数求偏导数,根据导数(梯度)方向调整参数:
- 若梯度为正(损失递增)→ 减小参数
- 若梯度为负(损失递减)→ 增大参数
逐步迭代,使 $w$ 和 $b$ 越来越接近最优值。
6.2 形象比喻:蒙眼下山
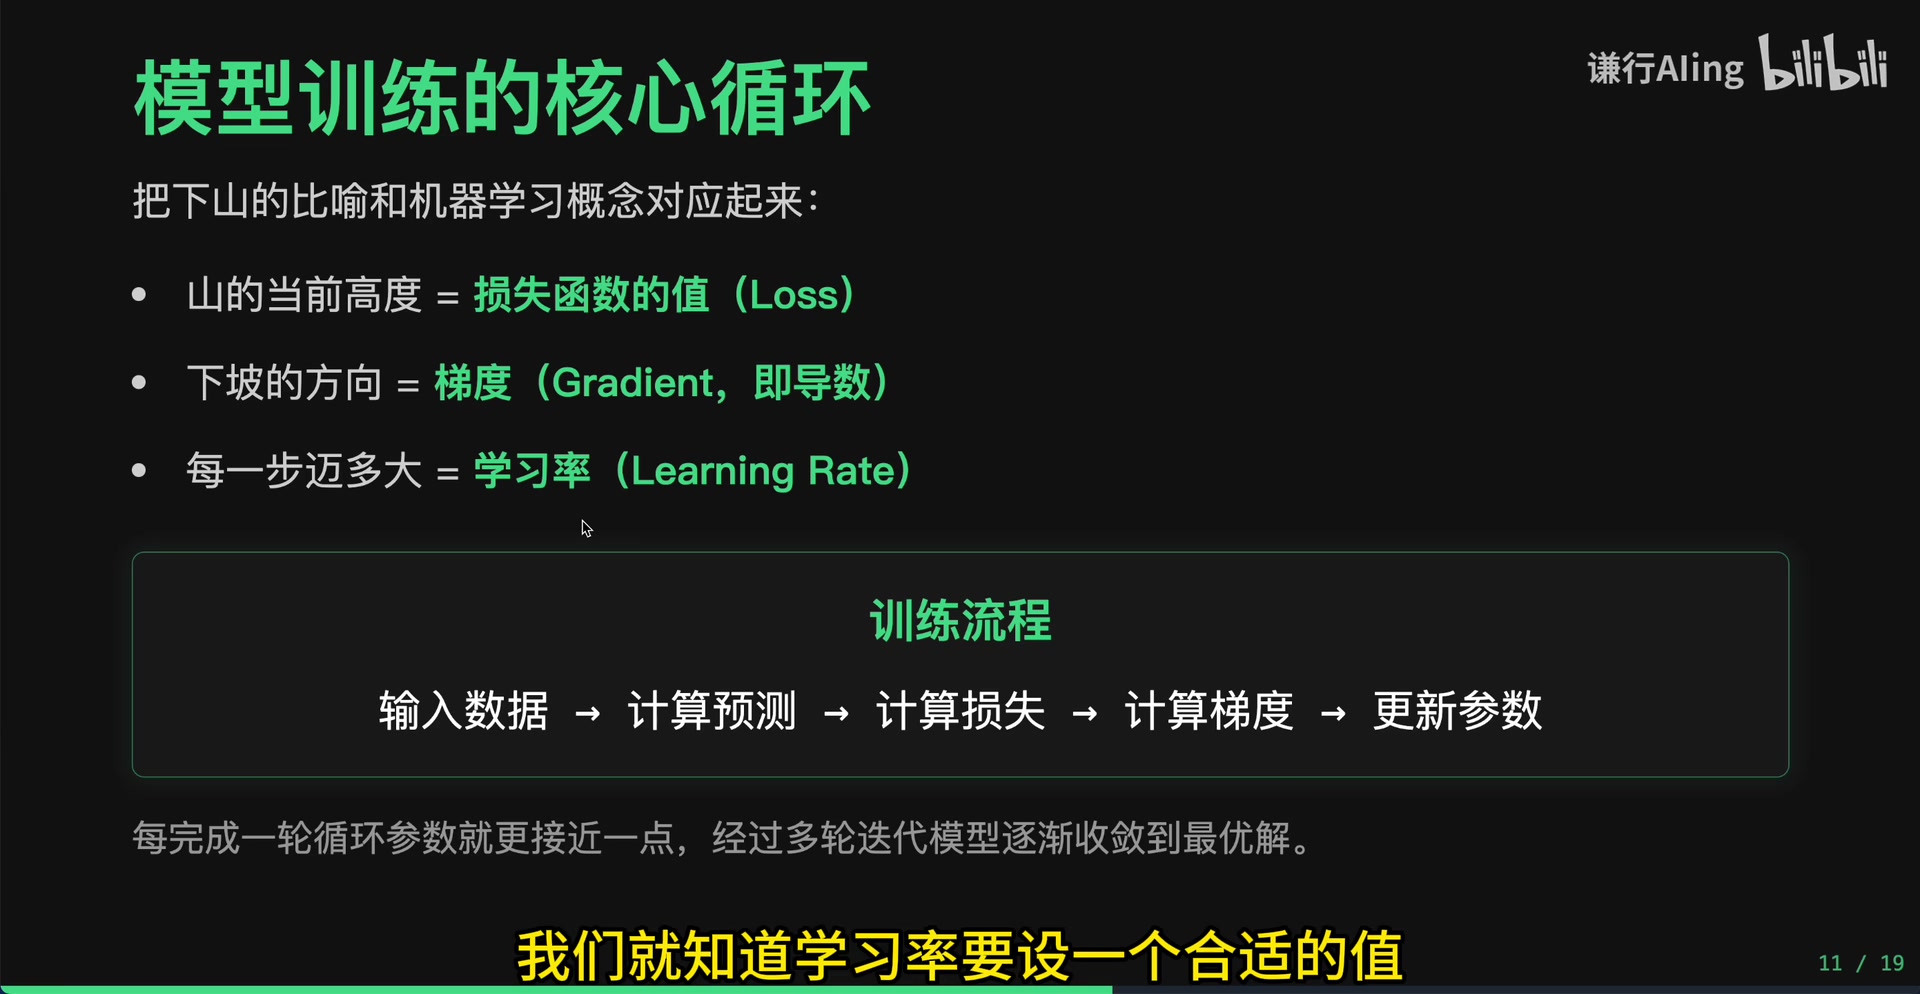
| 现实场景 | 机器学习对应 |
|---|---|
| 山的高度 | 损失函数的值 |
| 山底 | 损失函数最小值(接近0) |
| 下坡方向 | 梯度(偏导数) |
| 每步迈多大 | 学习率(Learning Rate) |
| 反复迭代探路 | 多轮训练 |
 *
6.3 关键要点
- 不是一锤子买卖:需一步步迭代,每次走一小步,重新评估方向
- 学习率不能太大:跨步太大会”趟过”最优点,造成反复震荡
- 学习率不能太小:训练速度过慢
- 数据量大或特征多时,必须使用梯度下降(线性回归在小数据时也可用最小二乘法直接解)
七、模型训练完整流程
输入数据 → 预测 → 计算损失(MSE) → 对损失函数求导(梯度) |
经过多轮迭代,模型逐渐收敛到最优解。
 *
八、多元线性回归(多特征扩展)
8.1 现实问题
房价不仅由面积决定,还受楼层、距地铁距离、房龄等因素影响。
8.2 模型公式
$$\hat{y} = w_1 x_1 + w_2 x_2 + w_3 x_3 + \cdots + w_d x_d + b$$
例如房价预测:
$$\hat{y} = w_1 \cdot \text{面积} + w_2 \cdot \text{楼层} + w_3 \cdot \text{距地铁} + w_4 \cdot \text{房龄} + b$$
预期相关性:
- 面积、楼层 → 正相关(系数为正)
- 距地铁距离、房龄 → 负相关(系数为负)
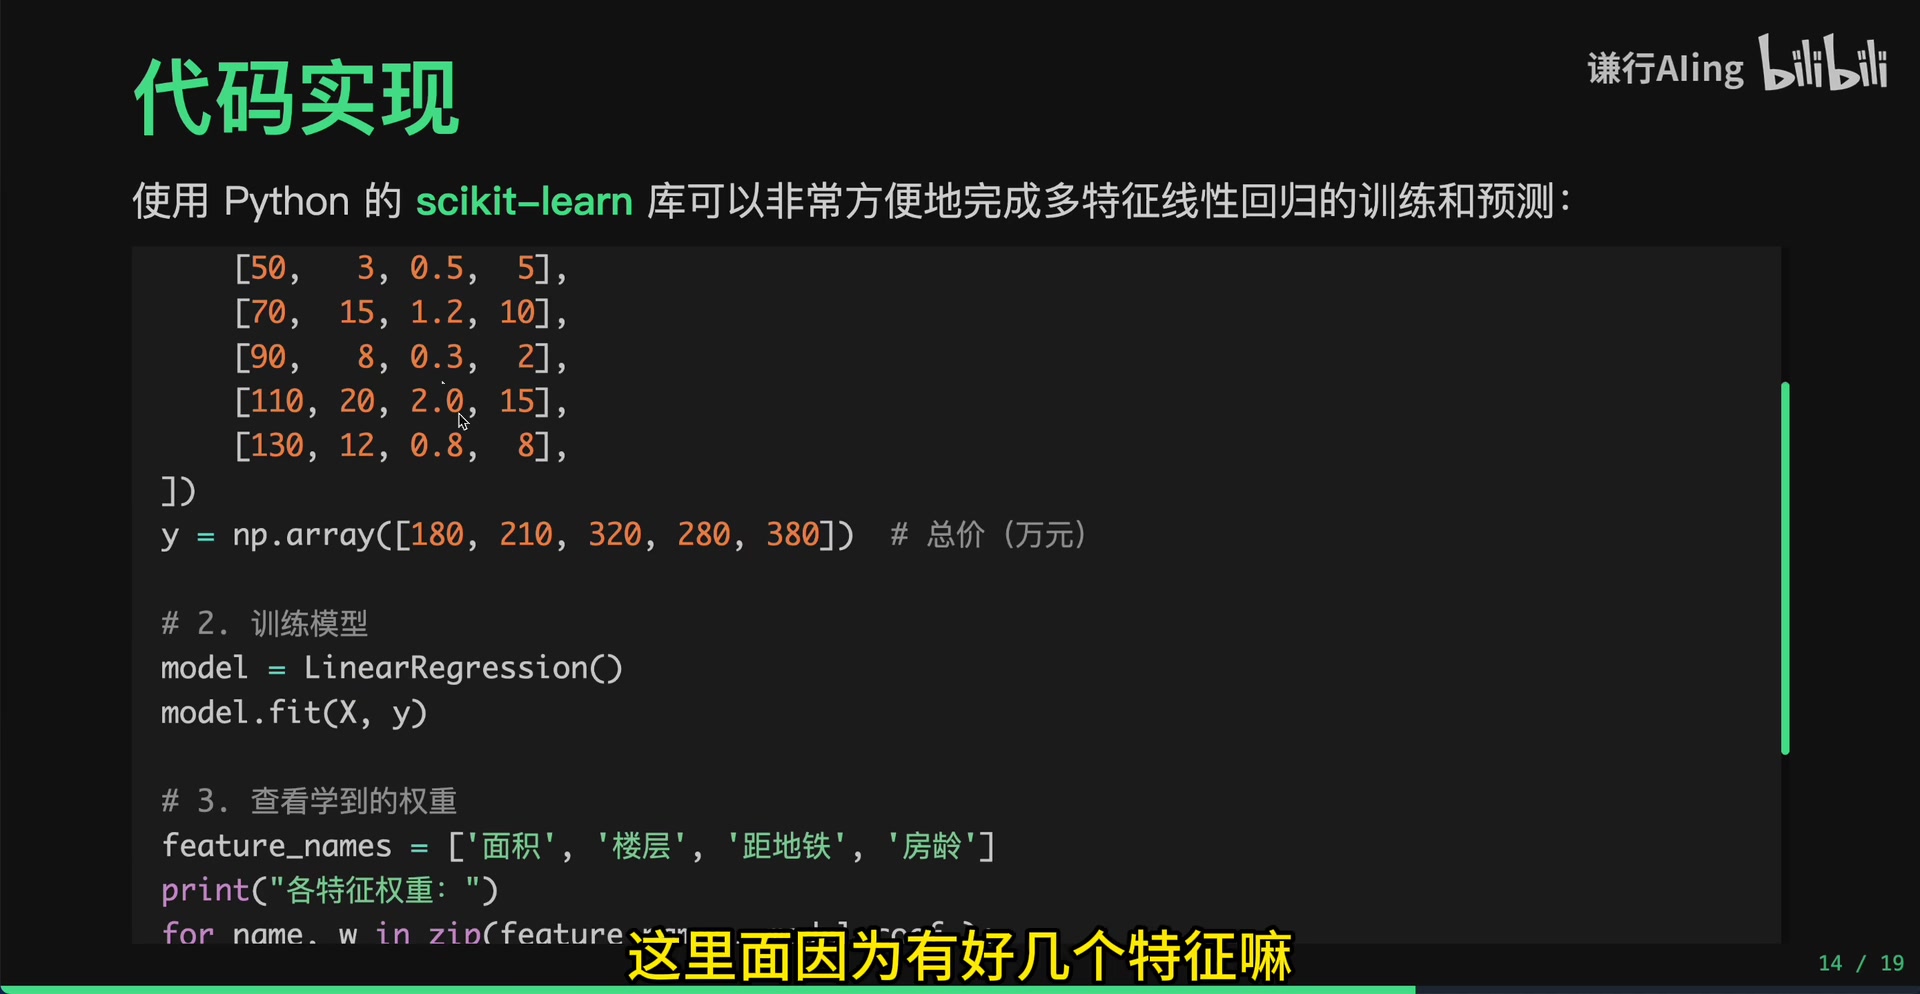
8.3 代码示例(sklearn)
from sklearn.linear_model import LinearRegression |
示例输出:
- $w_1 \approx 2.42$(面积)
- $w_2 \approx 1.3$(楼层)
- $w_3 \approx -\text{某值}$(距地铁,负)
- $w_4 \approx -\text{某值}$(房龄,负)
- $b \approx 49$
预测 100平 + 某楼层 + 某距离 + 5年房龄 → 289 万(比单特征预测的 230 万更精准)
 *
8.4 向量化表达
为简化书写,使用矩阵/向量形式:
$$\hat{y} = \mathbf{w}^T \mathbf{x} + b$$
- $\mathbf{w}$:权重列向量
- $\mathbf{x}$:特征列向量
- $\mathbf{w}^T$:转置(行变列、列变行),使矩阵乘法维度匹配
本质:无论 1 个特征还是 100 个特征,模型结构相同,都是 $wx + b$。
九、多项式回归(非线性拟合)
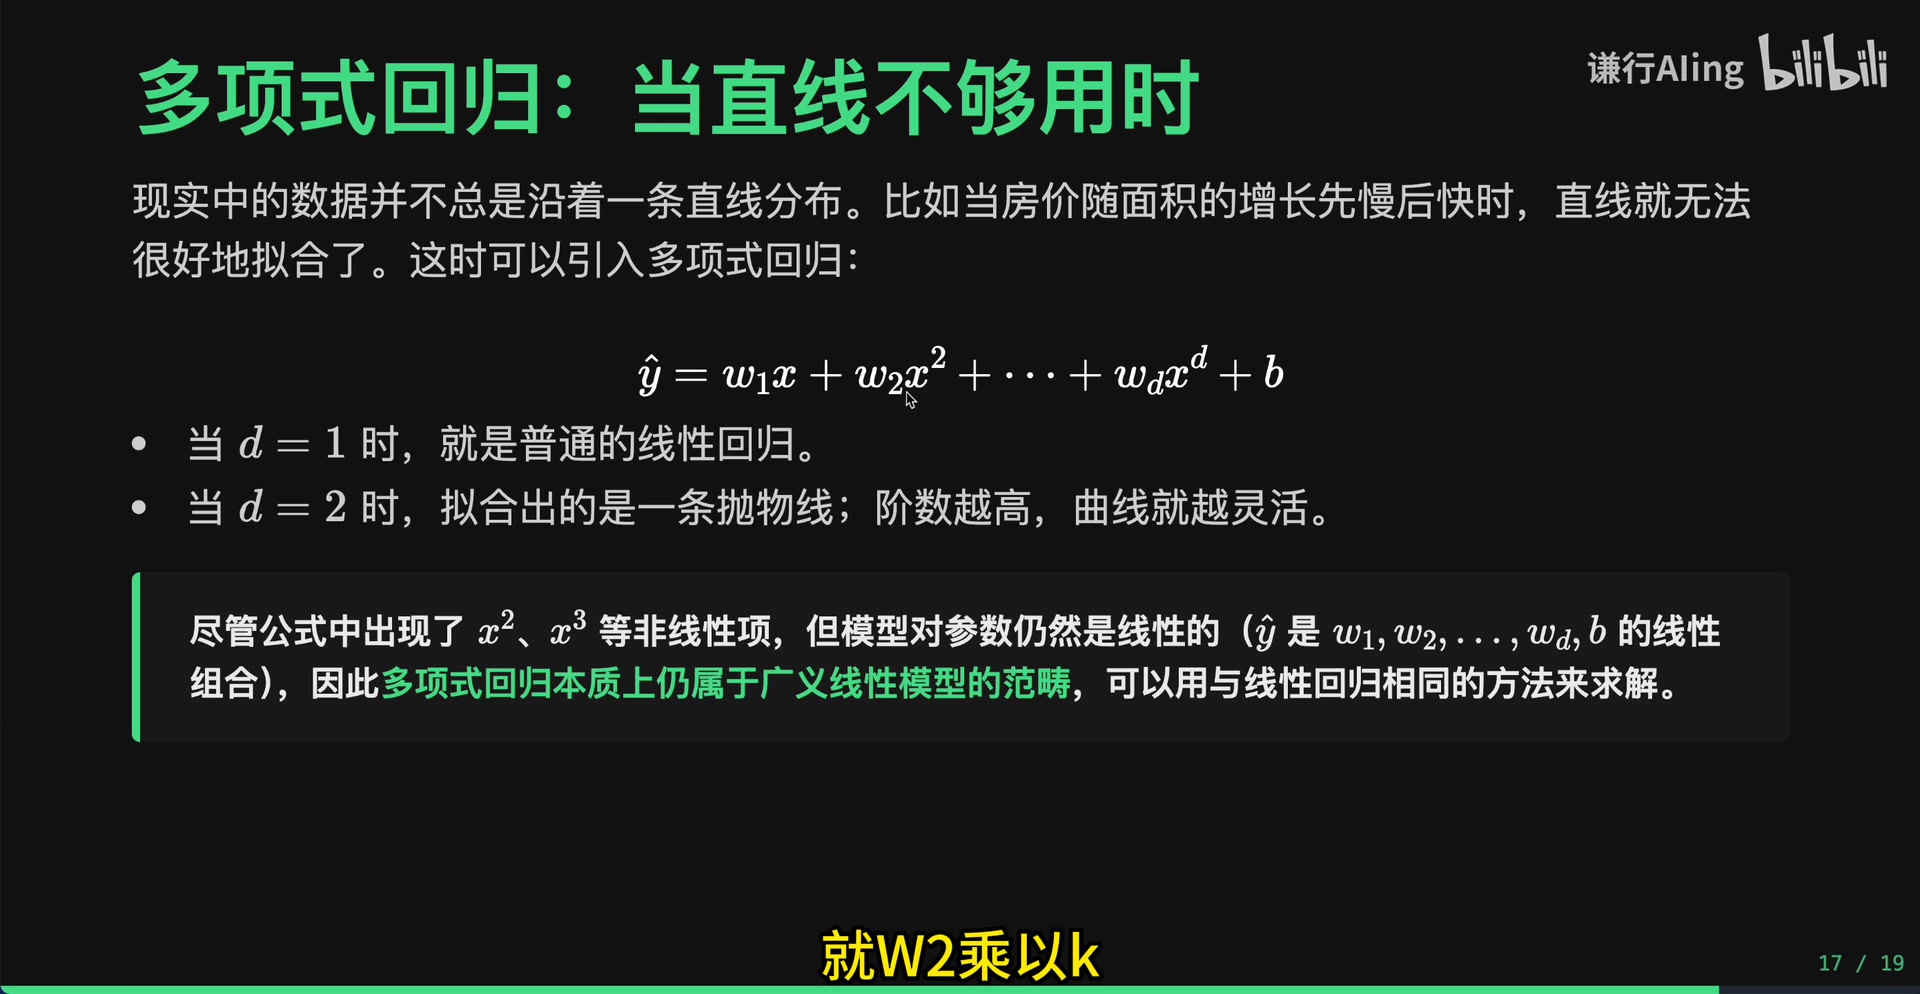
9.1 问题背景
现实数据并非总是直线分布,可能呈曲线(先快后慢/先慢后快)。
9.2 多项式模型
$$\hat{y} = w_1 x + w_2 x^2 + w_3 x^3 + \cdots + w_d x^d + b$$
- $d = 1$:普通线性回归(直线)
- $d = 2$:抛物线
- $d$ 越大:曲线越灵活
9.3 关键认知 ⭐
多项式回归本质上仍是线性回归!
原因:所谓”线性”是指对参数线性,而非对特征线性。
可以将 $x^2$ 视为新特征 $z$,则模型变为:
$$\hat{y} = w_1 x + w_2 z + \cdots$$
这就是典型的多元线性回归。这种把原特征转换为新特征的过程称为特征工程。
9.4 重要结论
- 线性回归不一定画的是直线
- 线性回归指的是对参数线性,不是对特征线性
- 当特征非线性时,称为多项式回归,本质仍属于广义线性回归
 *
十、线性回归的延
refer
-
声明:
若文章存在错误,望诸君不吝指正^
blog仅供个人记录学习所用部分笔记由于年代久远,做的笔记找不到最初是引用谁的,若是不允许引用转载,请联系我