6-数据预处理全攻略
数据预处理全攻略
📋 知识要点总结
本笔记系统介绍了机器学习中数据预处理的全流程,涵盖以下核心内容:
- 数据预处理的必要性:Garbage In, Garbage Out 原则
- 核心工具库:pandas、matplotlib、seaborn、scikit-learn
- 数据集划分:训练集/测试集的正确分割时机
- 探索性数据分析 (EDA):使用可视化发现数据问题
- 数据清洗:处理重复值、缺失值、异常值
- 特征编码:序数编码、独热编码、标签编码
- 特征工程:特征构造与删除
- 特征缩放:标准化 (Standardization) 与归一化 (Normalization)
- Pipeline 流水线:使用 scikit-learn 自动化预处理流程
1. 数据预处理概述
1.1 为什么需要数据预处理
在前面的课程中,我们介绍了线性回归模型和梯度下降算法。很多同学掌握后直接用自己的数据进行模型训练,但结果往往不及预期。原因在于前面 demo 中展示的数据非常干净,而现实世界中的数据往往充满各种问题:
- 存在异常值和缺失值
- 包含文本、类别等非数值类型的数据
- 量纲差距巨大(例如房价是百万级,房间个数却是个位数)
- 特征之间的差异过大导致模型训练困难
在算法界有一句至理名言:“Garbage In, Garbage Out”。如果数据质量低,那么训练出来的模型质量也肯定特别低。
1.2 四大核心工具
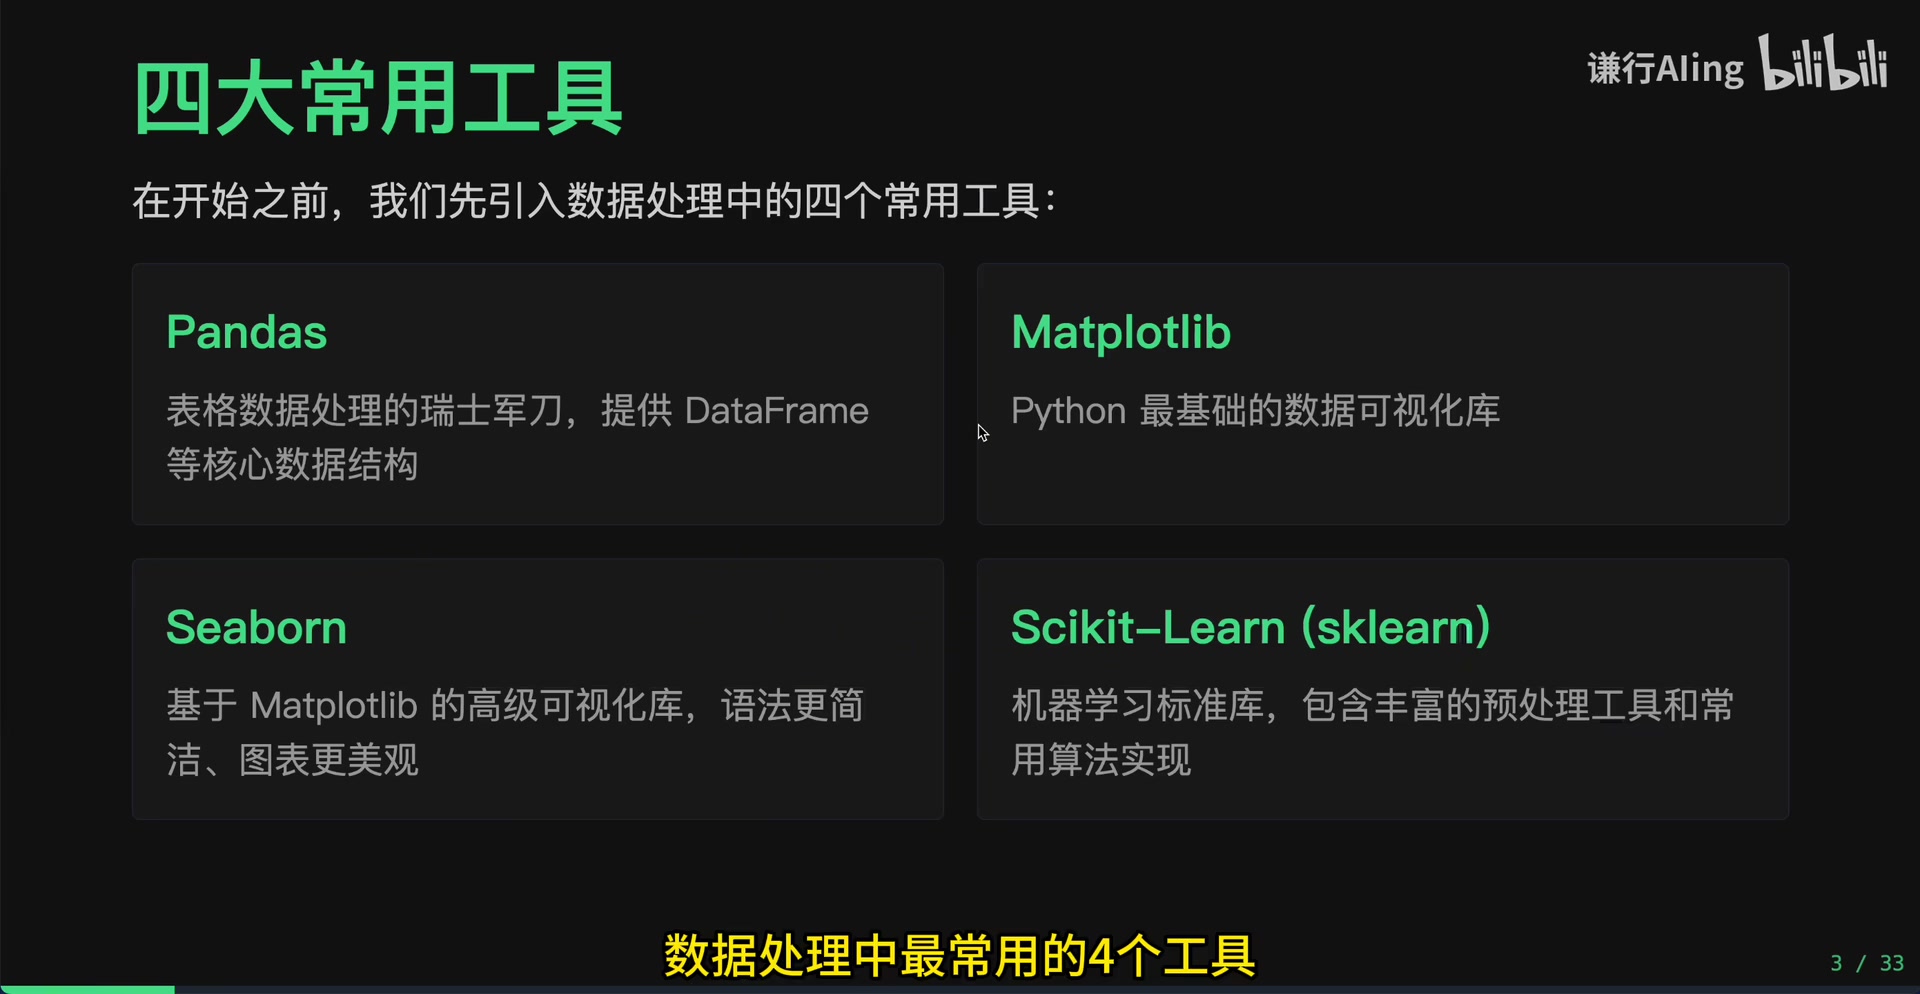
数据处理中最常用的四个 Python 工具:
| 工具 | 功能 |
|---|---|
| pandas | 处理二维数据(类似 Excel 表格),支持各种常见快捷处理 |
| matplotlib | Python 最基础的数据可视化库 |
| seaborn | 基于 matplotlib 的高级可视化库,语法更简洁,图表更美观 |
| scikit-learn | 机器学习的标准库,包含丰富的预处理工具和常用算法实现 |
 *
2. 数据集介绍与初步分析
2.1 Titanic 数据集
本课程使用开源的 Titanic 生存预测数据集作为示例。虽然 seaborn 中也内置了该数据集,但已经做过预处理,所以我们尽可能使用其原始数据来学习预处理过程。
2.2 数据基本情况
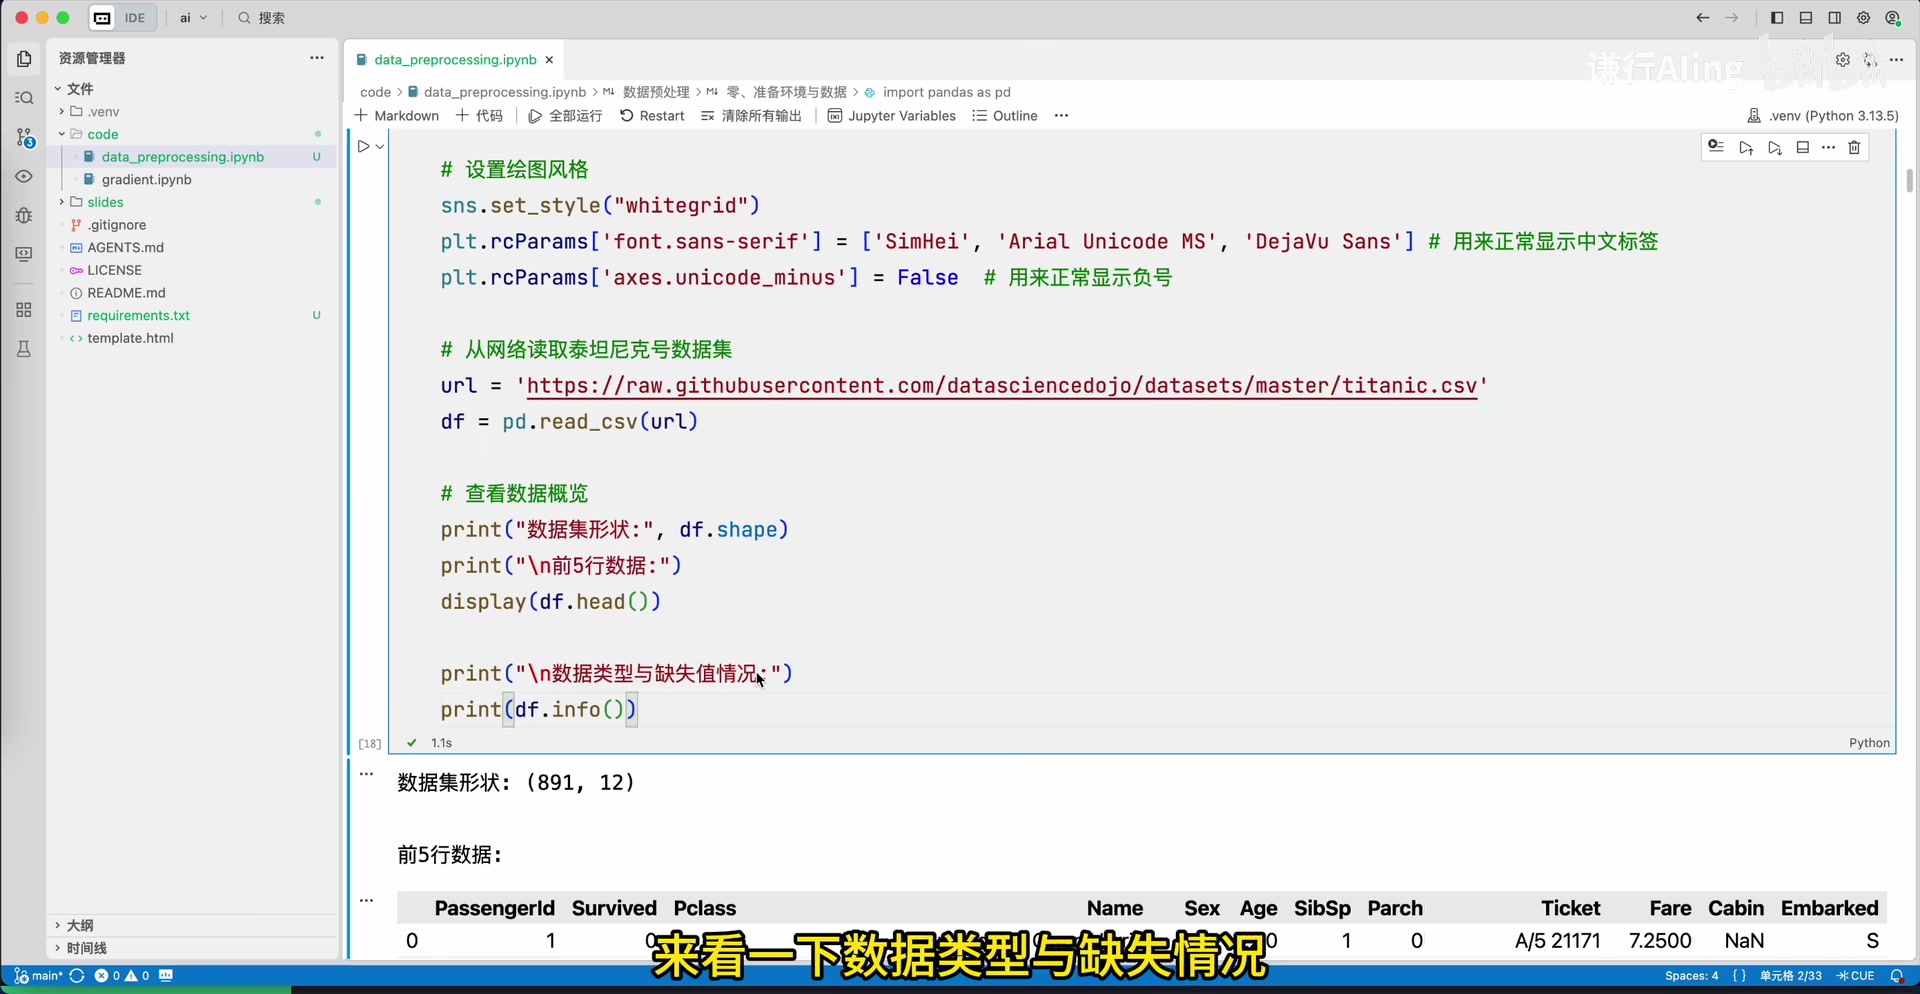
加载数据后可使用以下方法查看基本情况:
df.shape # 查看数据形状 |
Titanic 数据集共有 891 行 × 12 列(11 个特征 + 1 个标签 Survived)。
通过 df.info() 可观察到:
- 大多数字段有 891 条非空数据
Age只有 714 条非空(缺失较多)Cabin仅有 204 条非空(缺失严重)Embarked(登陆港口)只有 2 条缺失- 许多字段是
object(字符串)类型,不是 int 或 float
 *
3. 数据集划分:预处理前的关键步骤
3.1 数据集的分类
- 训练集 (Training Set):用于训练模型学习数据中的规律
- 验证集 (Validation Set):用来调整超参数或评估模型在未见数据上的表现
- 测试集 (Test Set):模拟真实世界的数据,评估模型的泛化能力
3.2 为什么要先划分再预处理
很多初学者最容易犯的错误是先对所有数据做预处理,然后再划分。这是不正确的。
原因:如果对所有数据做完预处理,里面会包含很多主观的认知。再对测试集进行验证发现也 OK,但这只代表模型对自己修改过的数据预测得准,而不能代表对真实世界(未修改过的)数据预测得准。被修改过之后会造成数据泄露 (Data Leakage)。
3.3 正确做法
- 只能在训练集上进行 fit(学习参数)
- 对于测试集,只做一些转换 (transform) 工作
3.4 划分代码示例
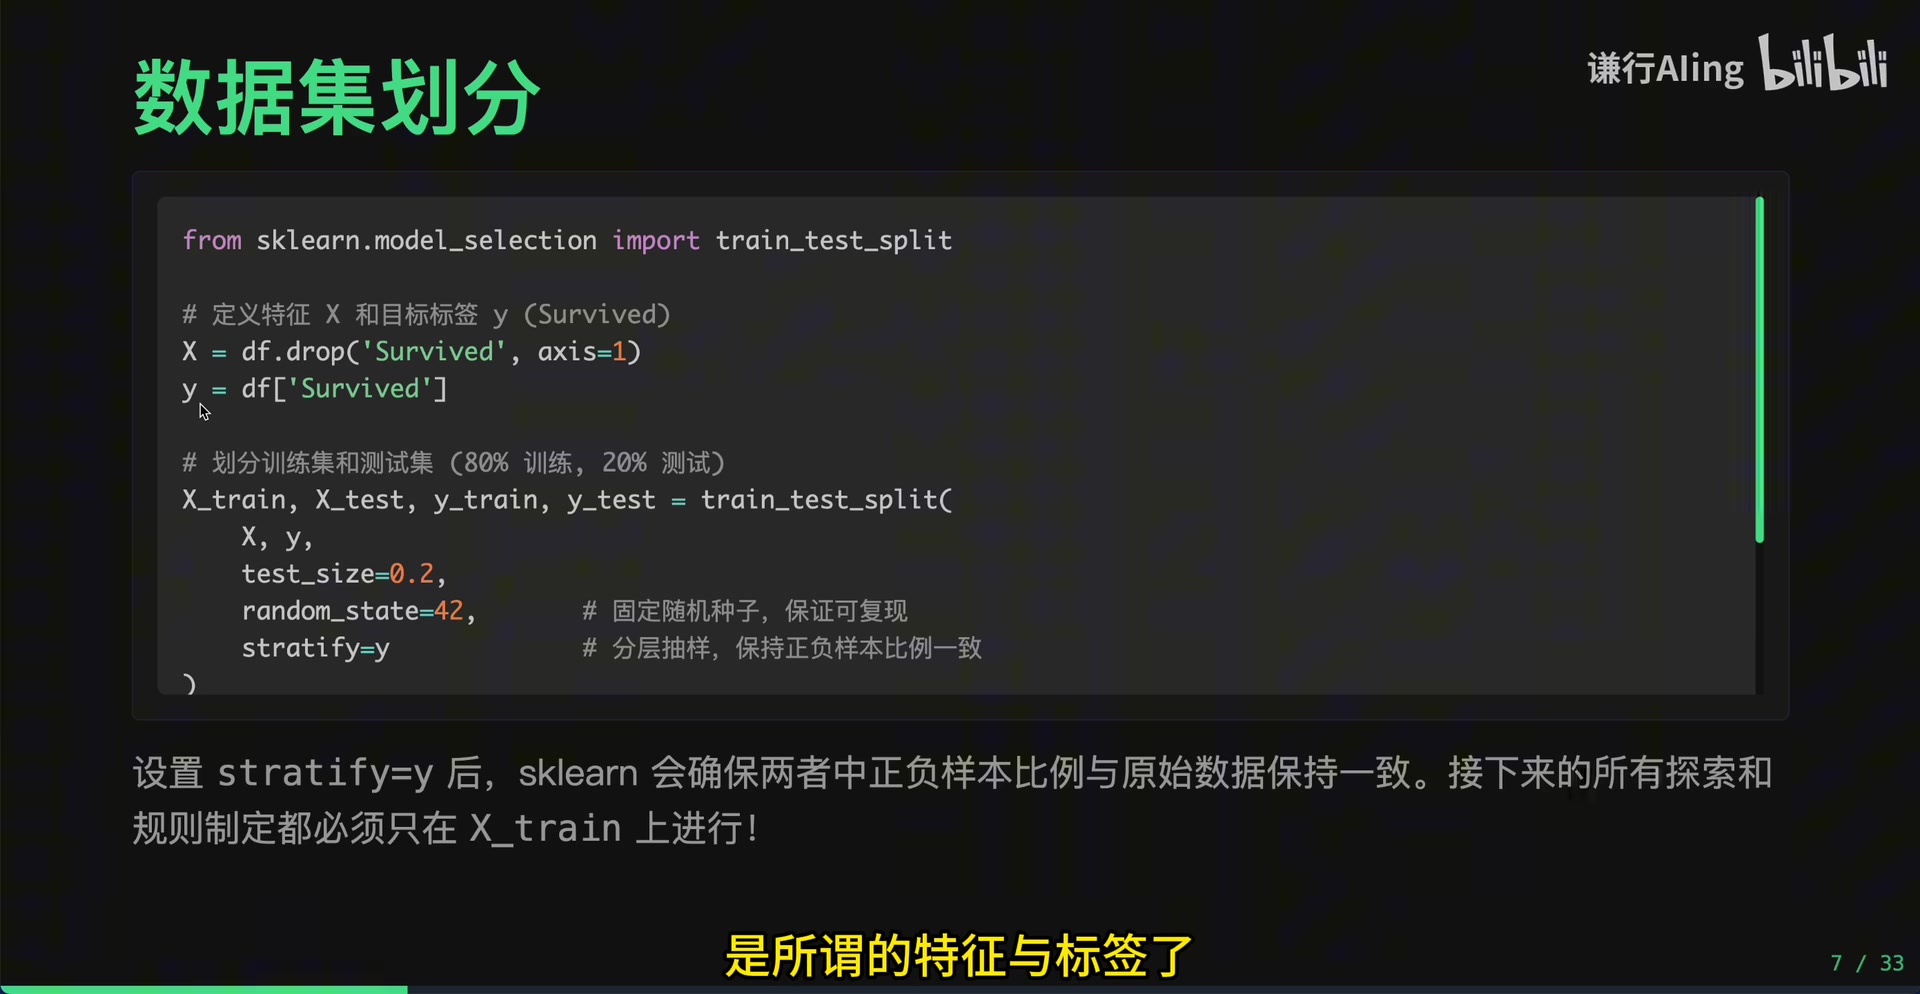
from sklearn.model_selection import train_test_split |
stratify=y 参数的重要性:如果只是纯粹随机分成 80% 和 20%,Y 值可能并不能保证两边的比例一致。设置 stratify 后,划分时会先学习数据,在分 80% 和 20% 时尽可能让标签值分布也符合原来的比例,这样更科学。例如划分后无论训练集还是测试集,生存率都保持在 38% 左右。
 *
4. 探索性数据分析 (EDA)
4.1 EDA 的概念
EDA (Exploratory Data Analysis, 探索性数据分析):对数据做一次全面的体检,发现存在的大概问题,然后再对数据进行预处理。
4.2 缺失值统计
# 缺失值的绝对数量 |
对 Titanic 数据集的初步分析:
Age:缺失率约 20%Cabin:缺失率约 77%(离谱)Embarked:只有 2 条缺失,占 0.3%(非常少)
4.3 数值特征统计
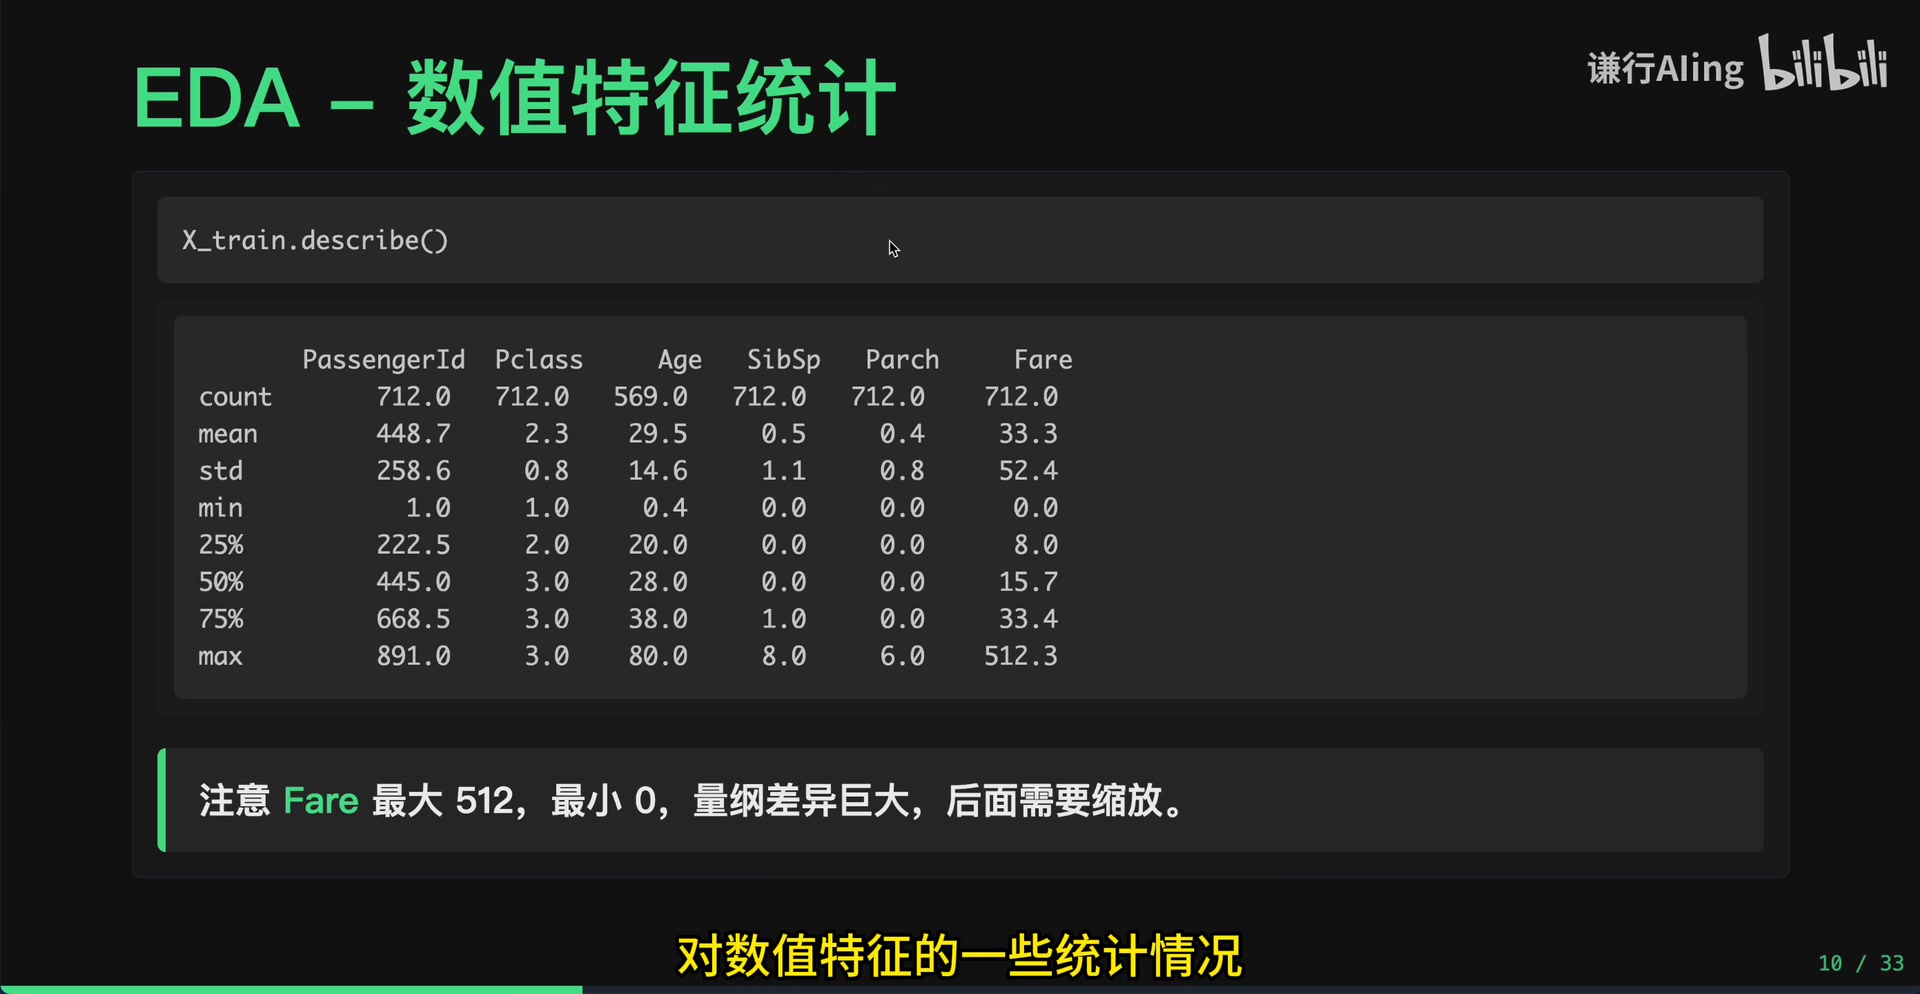
使用 df.describe() 查看数值特征的统计情况:
- count:个数
- mean:均值
- std:标准差
- min / 25% / 50% / 75% / max:最小值、各分位数、最大值
分位数 vs 均值:分位数(如第 75 百分位)比平均值在大部分时候更加可靠。防止出现”姚明和潘长江平均身高是 1.9 米”的偏差情况。
观察发现:Fare(票价)最大为 512,最小为 0,差距过大,中间值很小,需要进行缩放。
 *
4.4 数据可视化
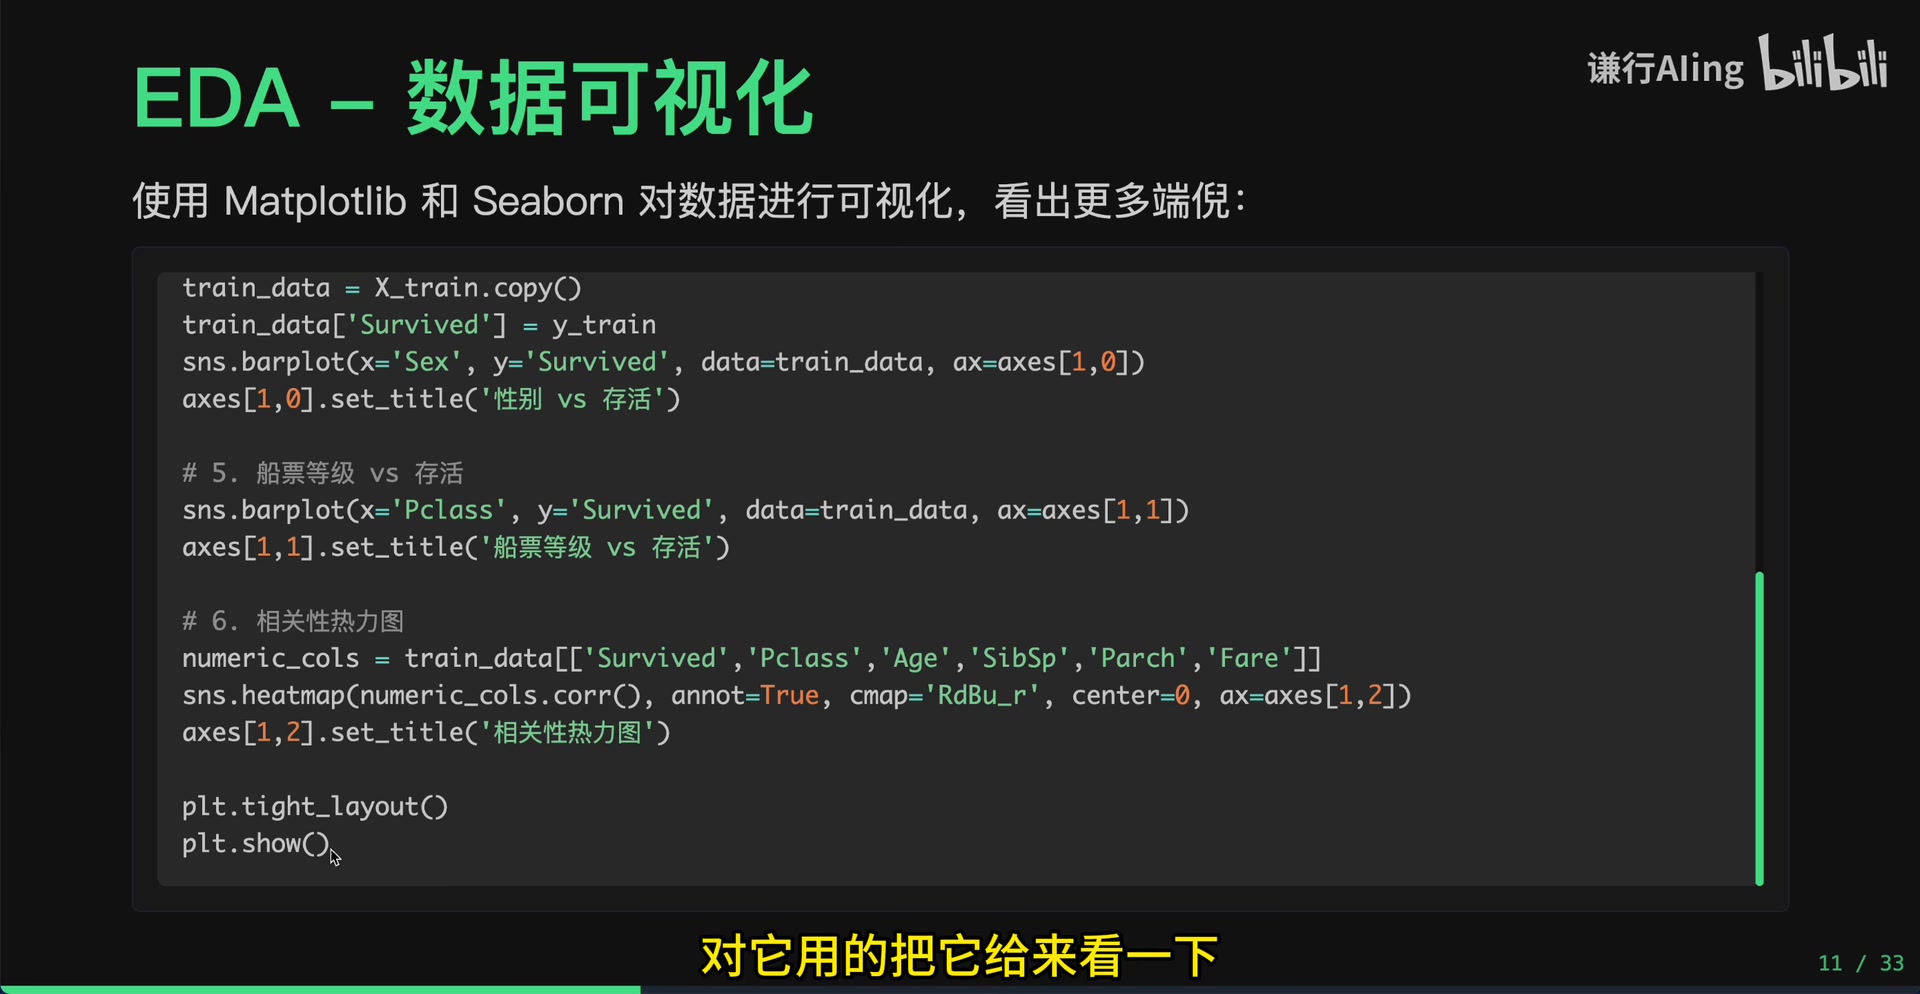
使用 matplotlib 和 seaborn 对数据进行可视化,可以看出更多端倪:
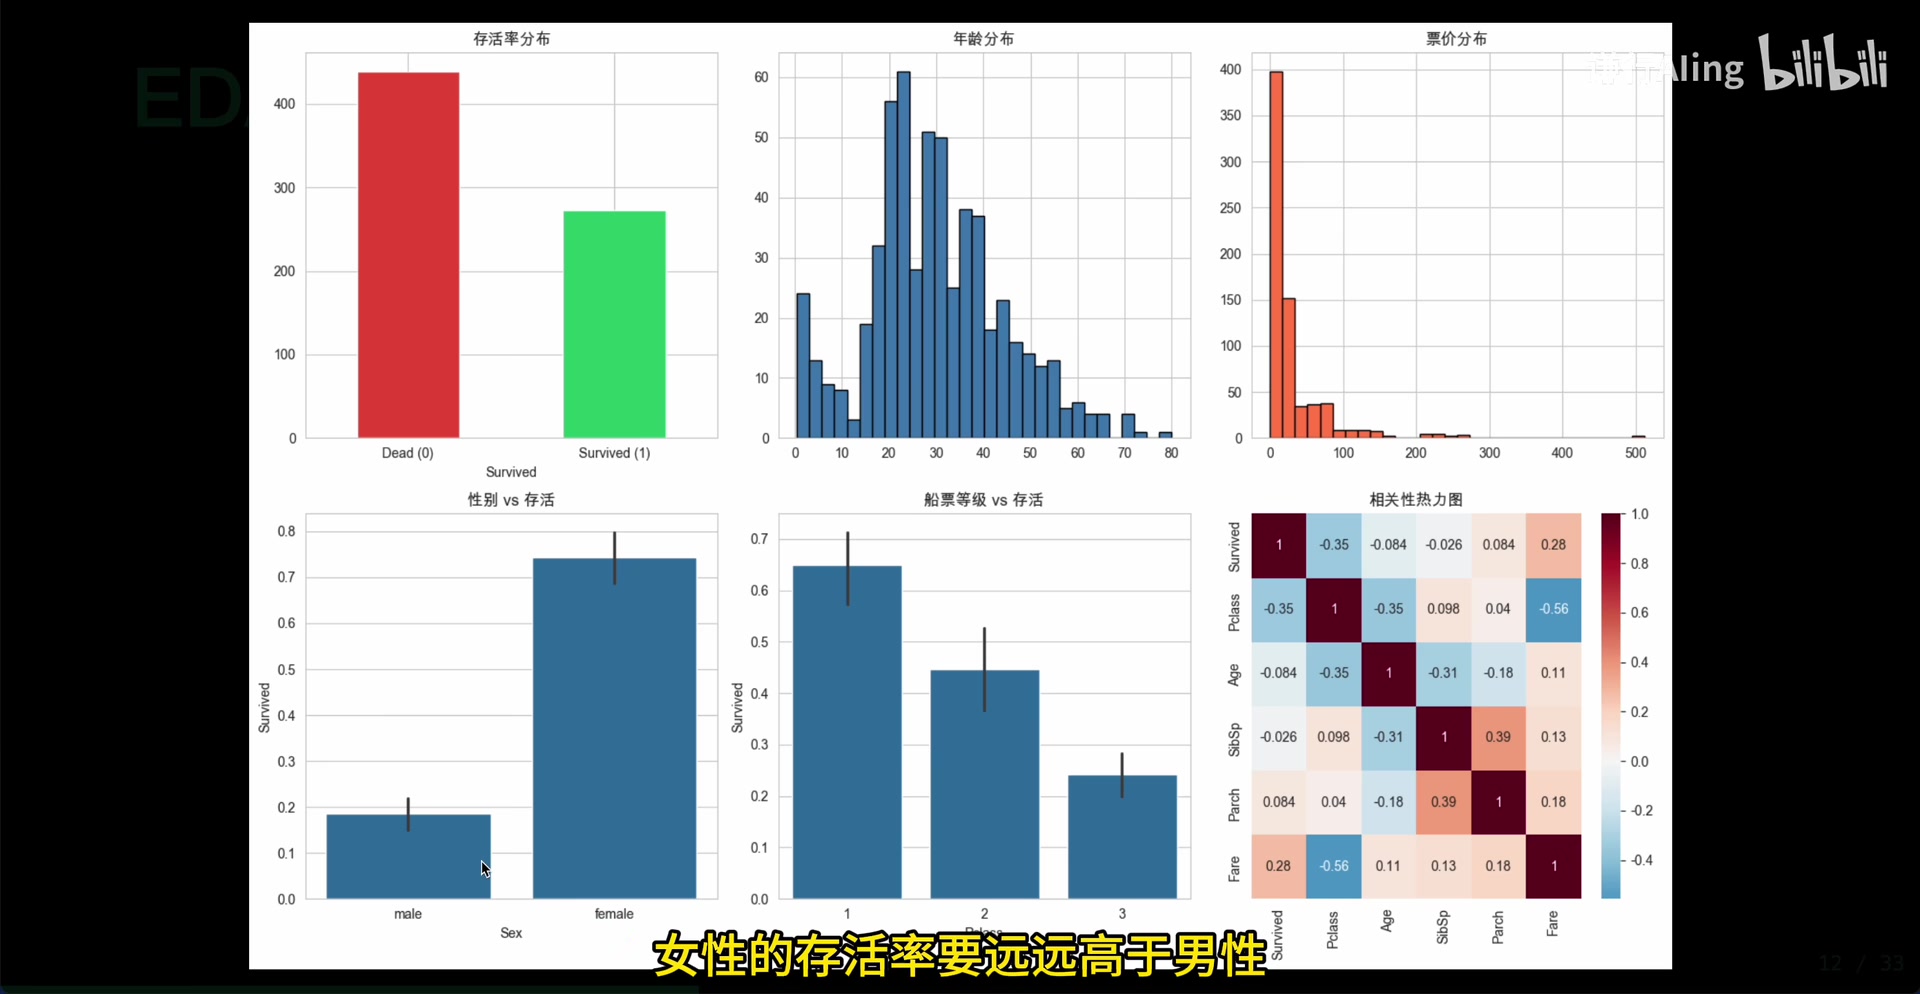
4.4.1 存活率分布
存活率看起来比死亡率要低一些,可能大部分人不幸遇难了。
 *
4.4.2 年龄分布
从 20~40 岁左右人数最多,但年龄大的也很多,年龄小的也有一些(可能有人带着孩子或携家带口)。
4.4.3 票价分布
票价分布严重右偏:左边有极值,导致右边变成长尾。最高一个达到 512,第二就只有 150。这个数据对模型训练极不友好,需要做特殊处理。
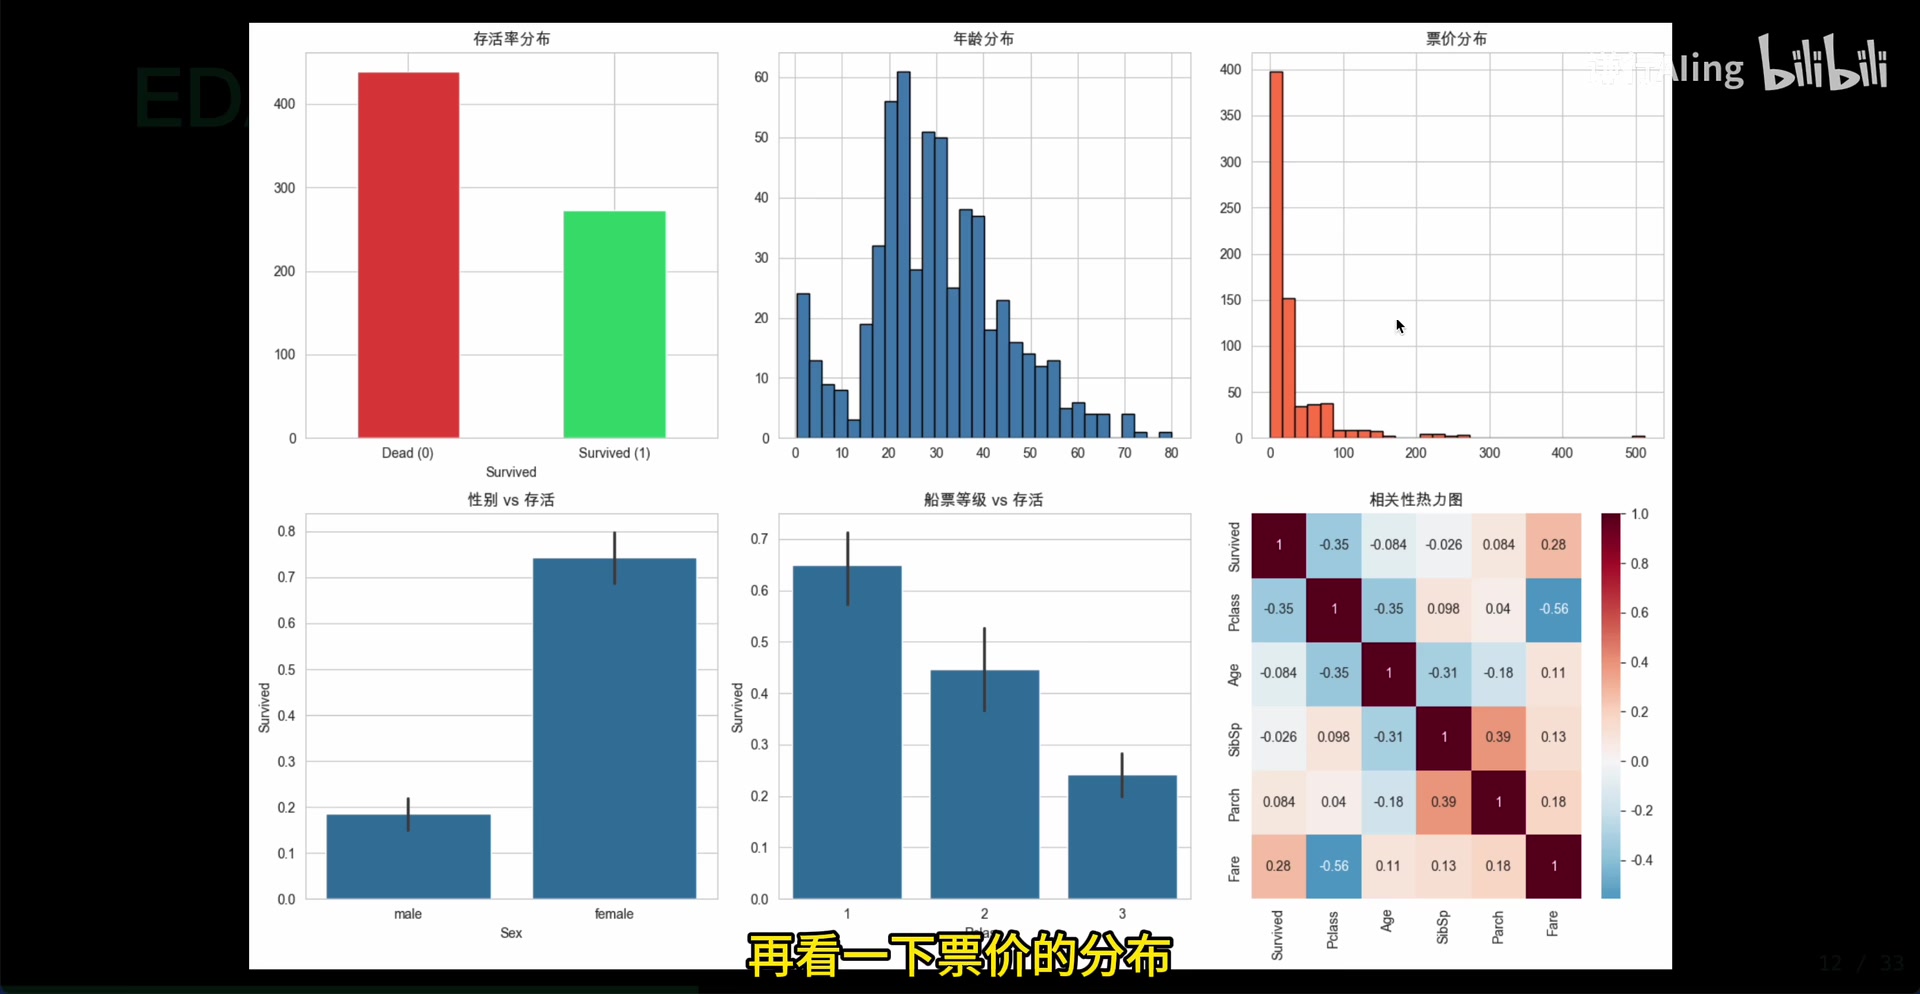 *
4.4.4 性别与存活率
有趣的是,女性的存活率要远远高于男性,虽然理论上男性身体更强壮存活率应该更高。
4.4.5 船票等级与存活率
一等舱 > 二等舱 > 三等舱的存活率,可能有钱的人更容易活下来。
 *
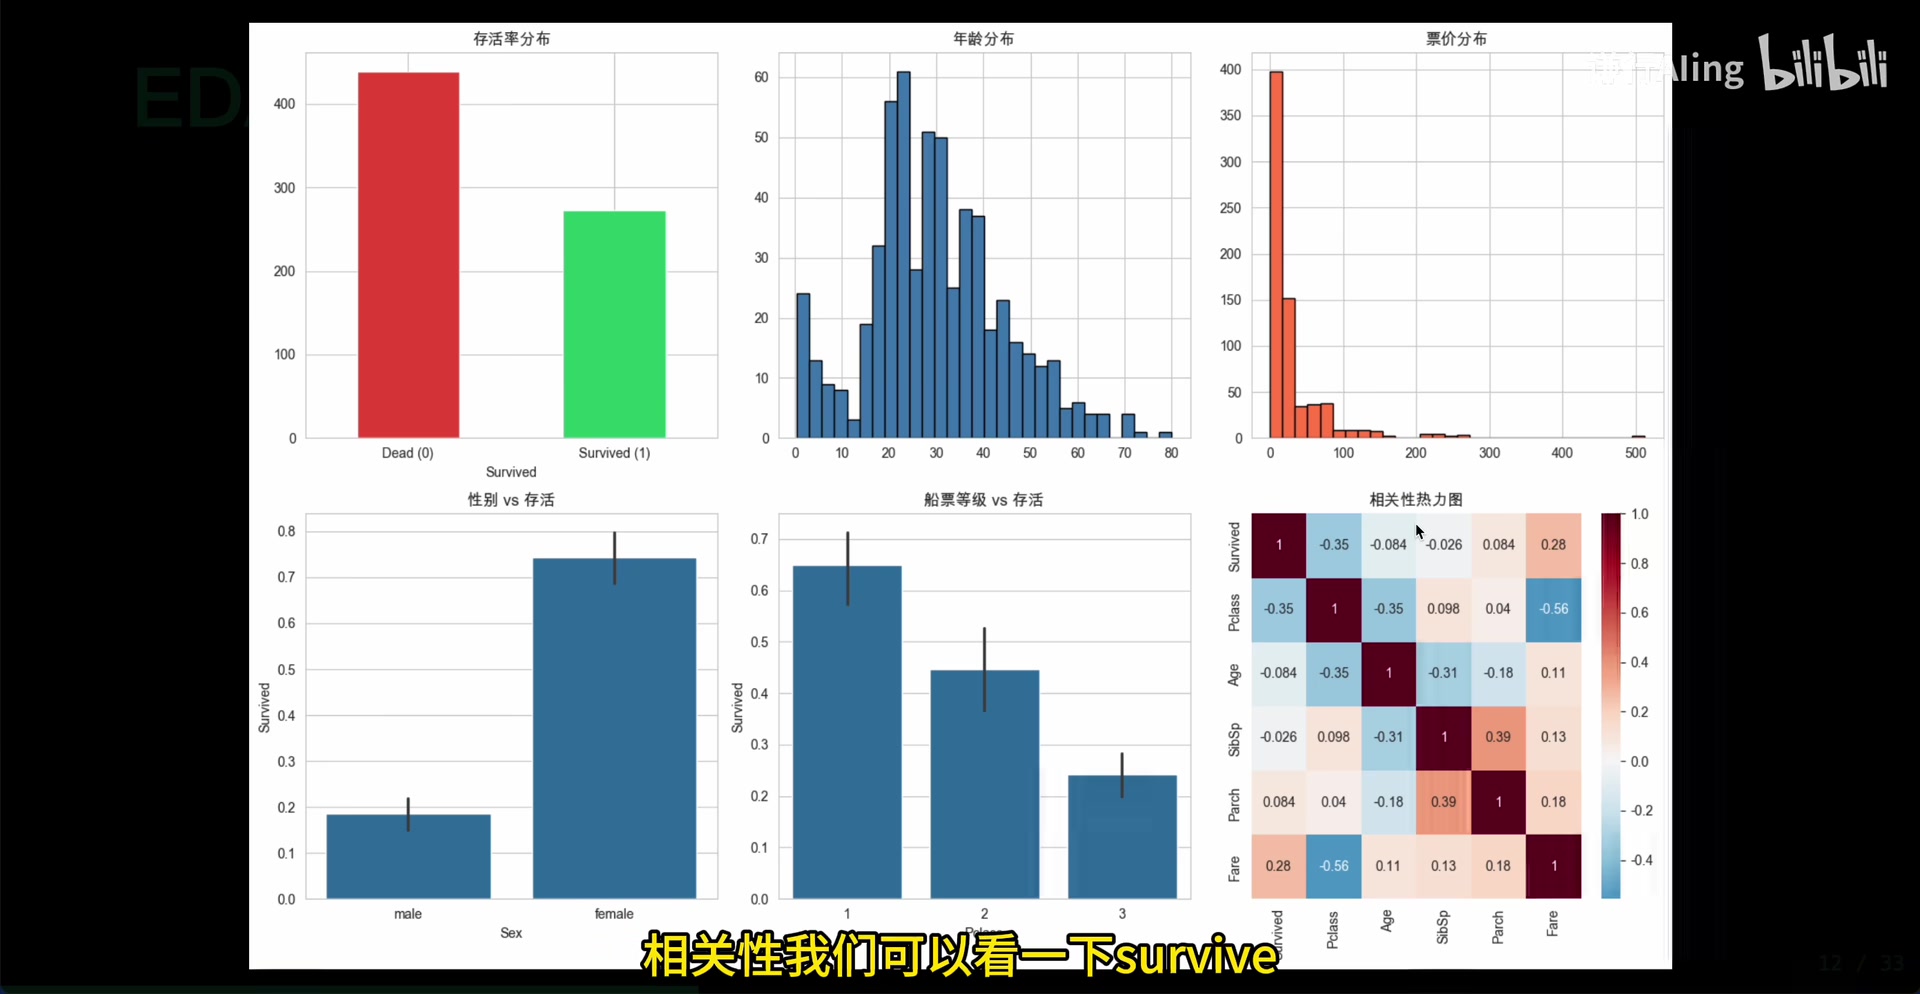
4.4.6 相关性热力图
通过热力图查看哪些属性与存活率最相关:
- 正相关:
Fare(票价)越高越相关 - 相关性较弱:
Age(年龄)关系没那么大 - 负相关:
Pclass(舱位等级)数值越小(一等舱),存活率越高 - 影响不大:
SibSp(亲属个数)
 *
4.5 EDA 关键发现与预处理方向
通过 EDA 得到了几个关键发现,指导后续预处理:
- 女性存活率远高于男性 → 性别是强特征,需要编码为数值
- 一等舱存活率最高 →
Pclass是强特征,需要保留 Age缺了 20% → 需要填充;分布偏态,应用中位数而非均值Cabin客舱信息缺了 77% → 信息量极少,可直接删除Fare严重右偏 → 需要对数变换或截断处理- 明显无用的特征 → 删除或提取关键信息
5. 数据清洗
5.1 处理重复值
在数据清洗中,首先要把重复值剔除掉。
# 删除重复行 |
重要提醒:特征和标签是靠索引值对应的,从 X_train 中删除一行之后,从 y_train 中也要把对应的行给删掉。
5.2 处理缺失值
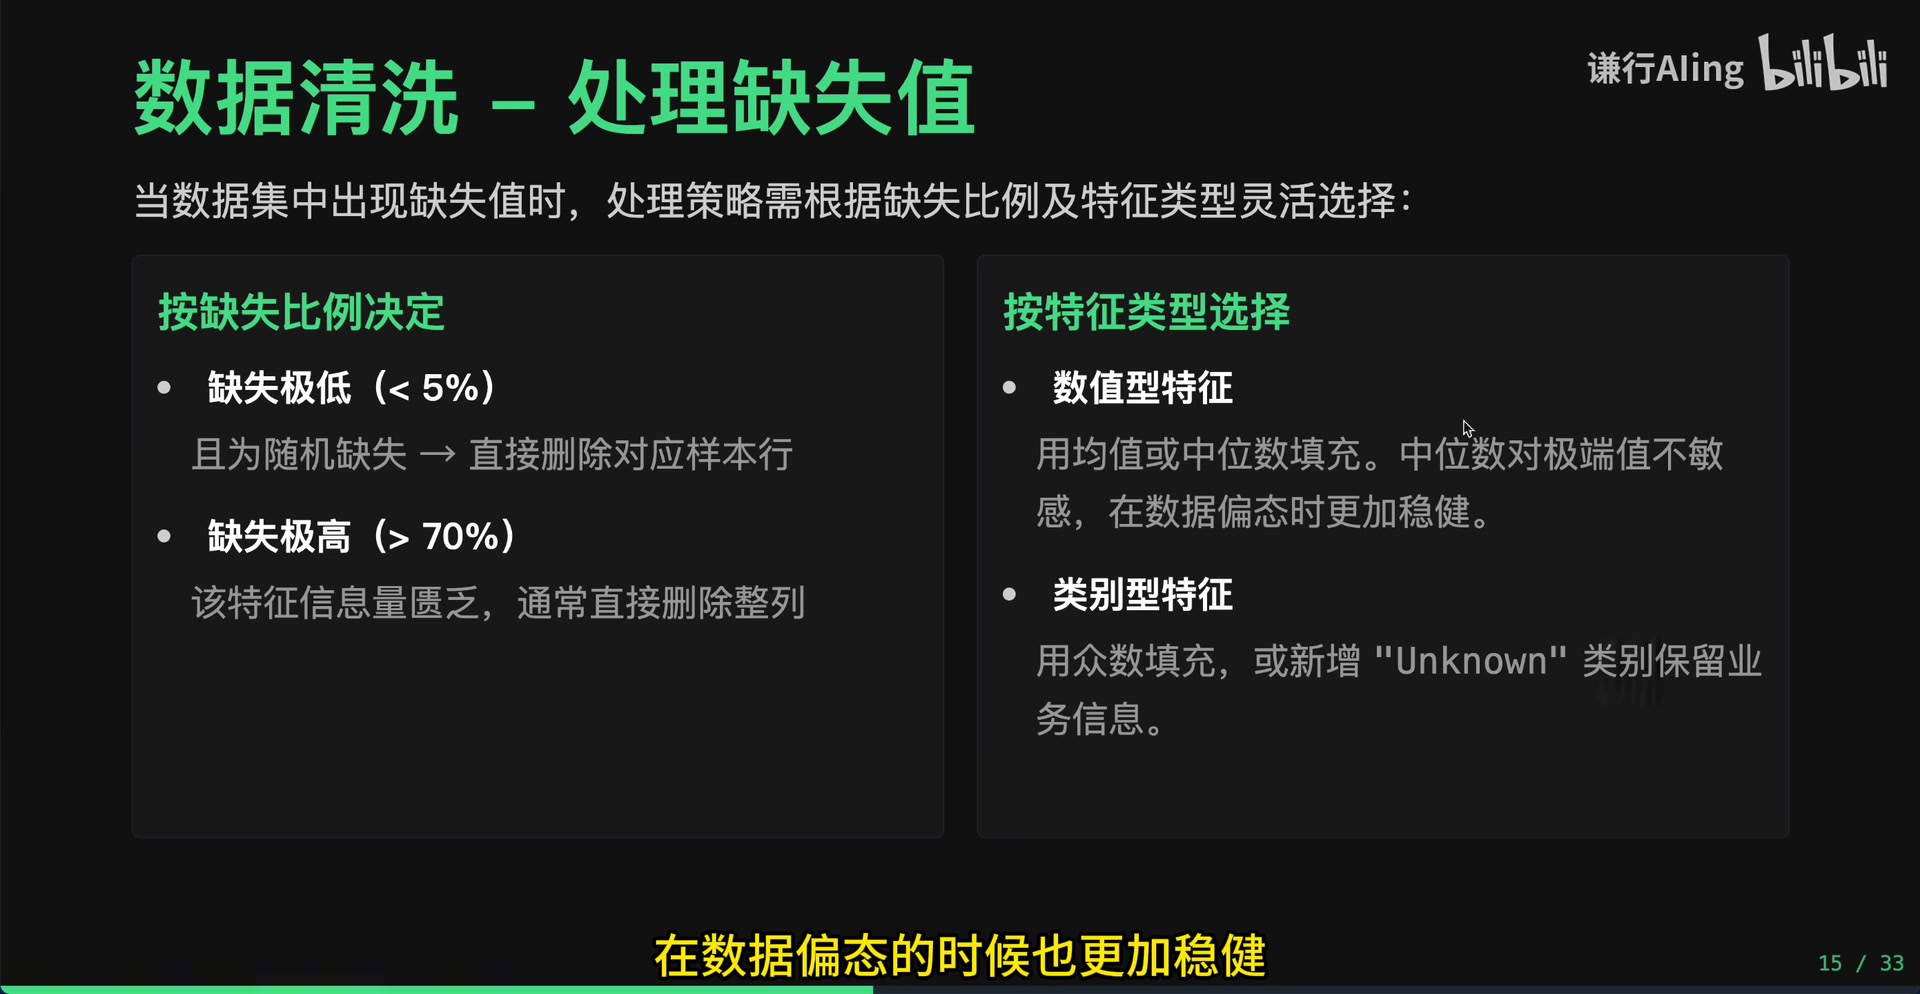
缺失值的处理方法根据缺失率不同而不同:
5.2.1 缺失率极低(< 5%)且随机缺失
- 可直接删除对应的行样本
5.2.2 缺失率特别高(> 70%)
- 信息量非常少
- 可直接删除该列
- 例如 Cabin 缺失 77%,可以删除
5.2.3 中等缺失率:填充策略
不要轻易删除数据,因为数据来之不易:
- 删除一行可能浪费 249 个其他特征
数值型特征:
- 用均值或中位数填充
- 中位数对极值不敏感,在数据偏态时更稳健
- 大部分情况下使用中位数而非均值
类别型特征:
- 用众数 (most_frequent) 填充,即出现次数最高的值
- 或者新增一个 “Unknown” 类别,保留业务信息
- 例如:有些缺失并非数据获取问题,而是”就是没有”,需要根据业务判断
 *
5.2.4 使用 scikit-learn 处理缺失值
from sklearn.impute import SimpleImputer |
核心原则:
- 只能对训练集进行 fit(学习参数)
- 对于训练集和测试集都做 transform(转换)
- 否则相当于作弊(数据泄露)
5.2.5 特殊处理:Cabin 客舱信息
由于 Cabin 缺失 77%,可做以下处理:
- 添加新列
Has_Cabin:是否有客舱信息(0/1) - 删除原来的
Cabin列
这样做既保留了部分信息,又避免了缺失值问题。
5.3 处理异常值
5.3.1 异常值的定义
异常值是指显著偏离其他观测值的极端值(极大或极小)。
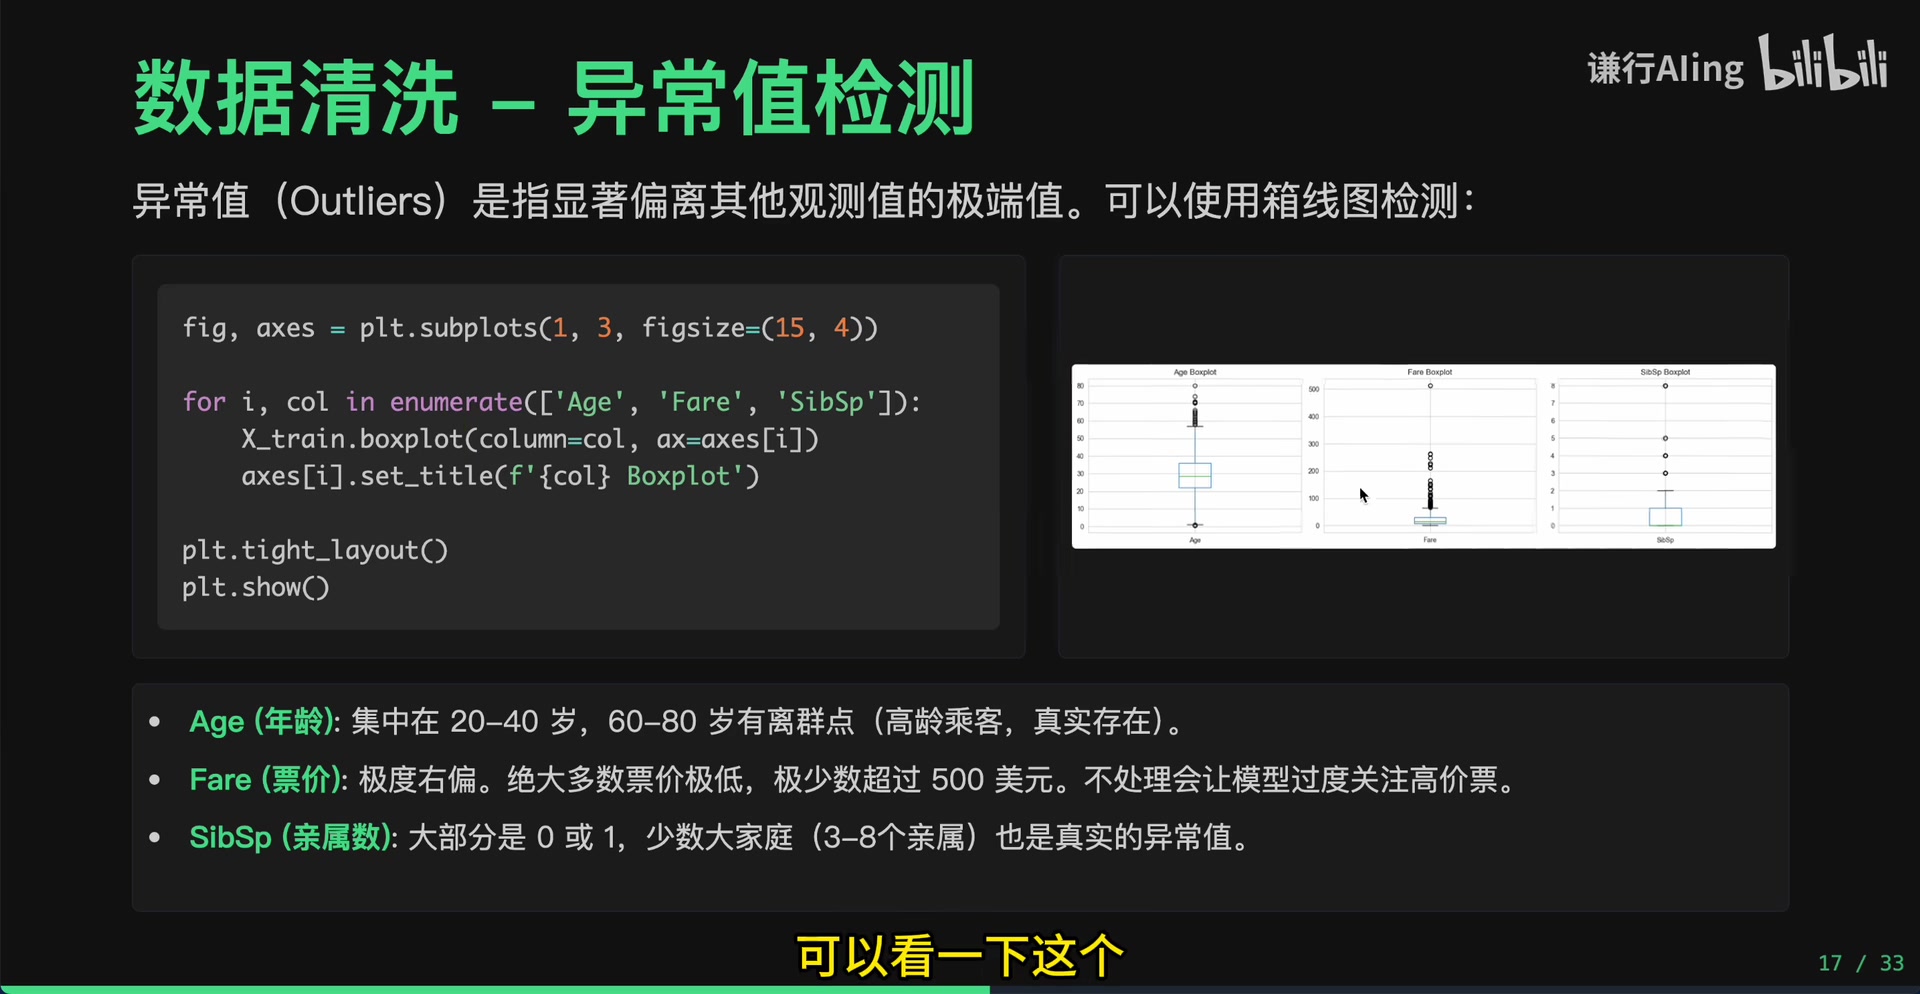
5.3.2 箱线图(Box Plot)识别
使用箱线图可以直观看出异常值情况:
Age:中位数在中间,但 60~80 岁之间有很多离群点Fare:极度右偏,只有一个值在高位(如 512),绝大部分票价都很低SibSp:大部分在 0~1 之间,少数较大值可能是真实情况
 *
5.3.3 截断策略(IQR 方法)
设置一个合理的区间,超出范围的值截断到边界值:
- 计算 Q1(25 分位数)和 Q3(75 分位数)
- IQR = Q3 - Q1
- 合理区间:[Q1 - 1.5×IQR, Q3 + 1.5×IQR]
- 对于
Fare:最小也得是 0(票价不能为负),最大是 Q3 + 1.5×IQR
# 截断到合理区间 |
重要原则:在数据预处理时,尽量不要删除数据。截断(clip)比删除更合理。
6. 特征编码
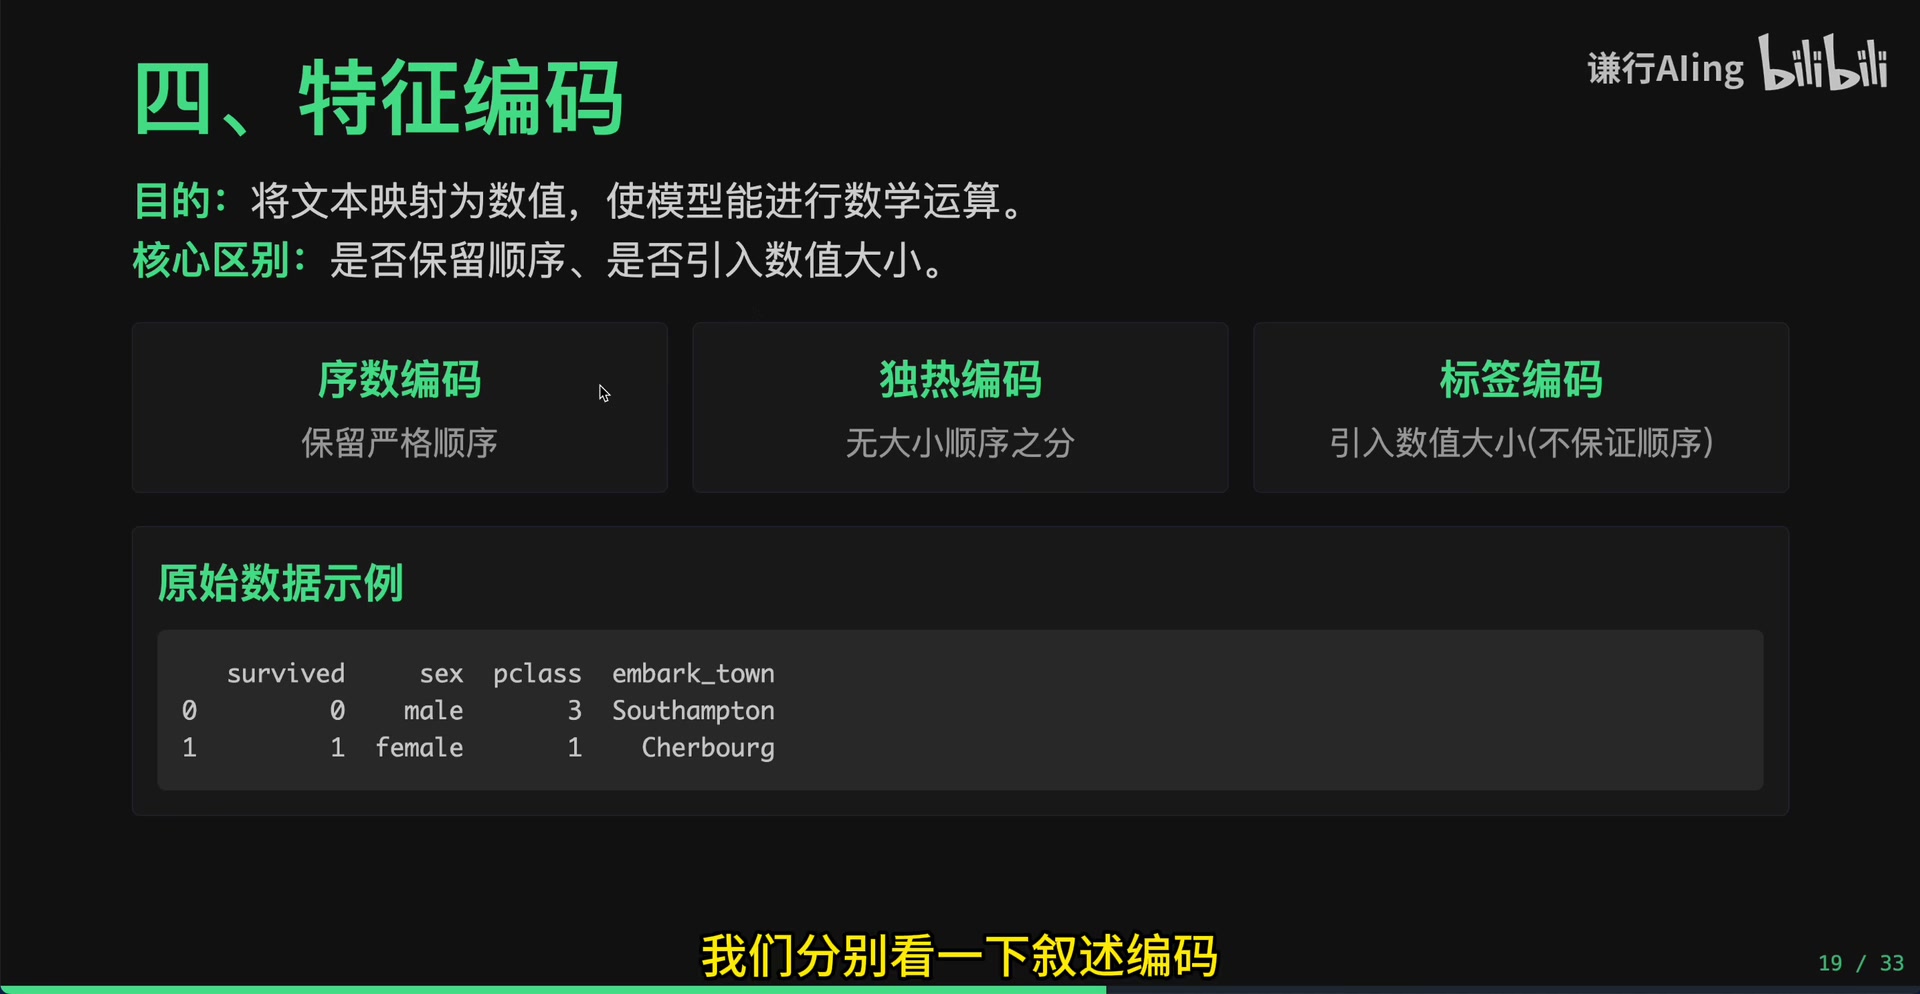
6.1 特征编码的目的
将文本类特征映射成数值类,使模型能进行数学运算。线性回归的本质就是进行数学运算。
6.2 三种主要编码方式
| 编码方式 | 是否保留顺序 | 适用场景 |
|---|---|---|
| 序数编码 | 保留 | 有顺序关系的类别(如学历、满意度) |
| 独热编码 | 不保留 | 无顺序关系的类别(如颜色、城市) |
| 标签编码 | 不保留 | 二分类、树模型、多分类标签 |
 *
6.3 序数编码 (Ordinal Encoding)
把类别映射为整数,严格保留顺序。
适用场景:虽然用文本表示但有顺序关系的数据:
- 学历:低、中、高 → 0、1、2
- 客户满意度:4 颗星、3 颗星 → 4、3
代码实现:
from sklearn.preprocessing import OrdinalEncoder |
6.4 独热编码 (One-Hot Encoding)
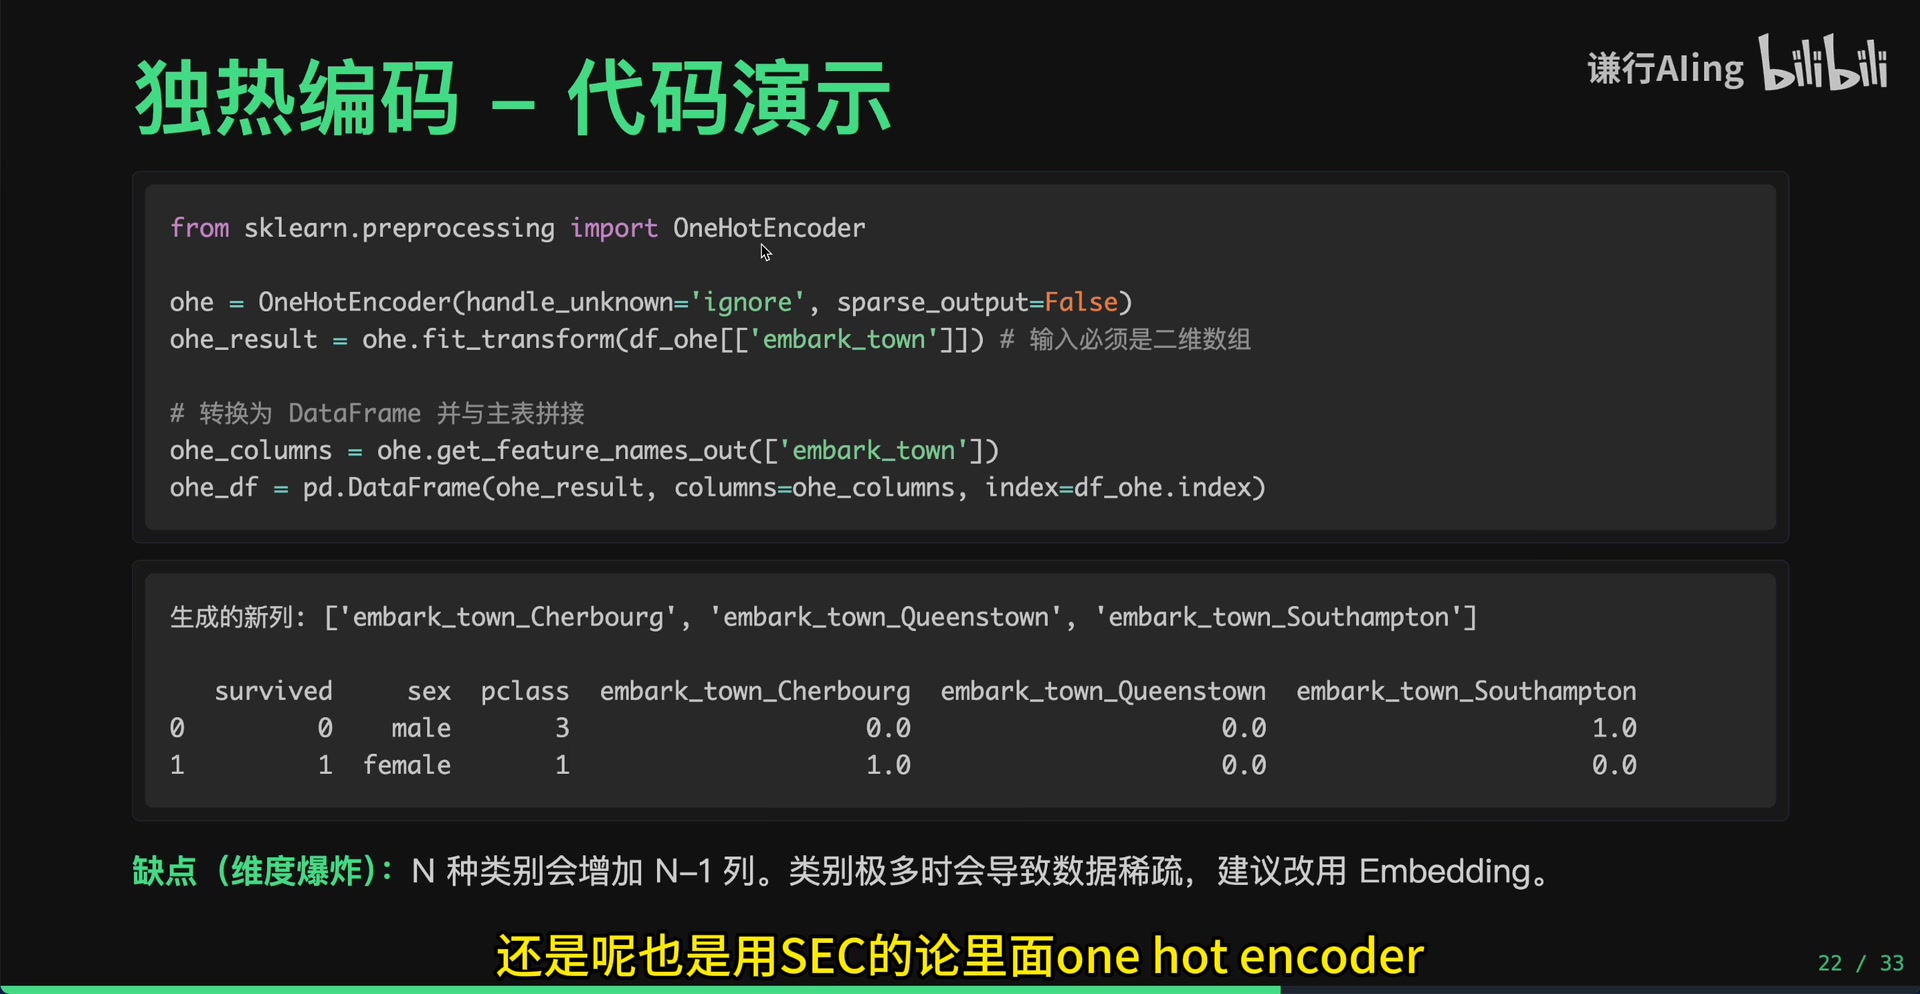
核心思想:把每个类别都变成一个独立的列,用 0 和 1 表示。
为什么要这么做?
假设颜色有红、绿、蓝三种:
- 用序数编码会变成 1、2、3
- 这会让模型错误认为”蓝 = 红 × 3”或”蓝色最大最好”
- 但实际上颜色没有顺序关系
独热编码做法:
- 红色 → [1, 0, 0]
- 绿色 → [0, 1, 0]
- 蓝色 → [0, 0, 1]
优点:完全消除顺序关系,模型能正确学习
缺点:明显增加列数。如果类别有 500 个,就需要增加 499 列,训练时非常复杂。类目过多时需用 embedding 等高级方法。
代码实现:
from sklearn.preprocessing import OneHotEncoder |
 *
6.5 标签编码 (Label Encoding)
特点:
- 把文本映射成数字,不保证顺序
- 引入了数值大小,但数值本身无意义
- 按字母顺序或出现顺序决定(如 0、1、2、3、4…)
严格适用范围:
✅ 可以使用:
- 二分类特征(如性别:男/女),比独热更省空间
- 分类任务的标签列(最终预测结果),因为算法要求输出数字
- 树模型:对数值大小不敏感
❌ 严禁使用:
- 线性模型中无序特征(必须用独热)
- 多分类任务的无序特征
代码实现:
from sklearn.preprocessing import LabelEncoder |
6.6 编码方式选择总结
| 场景 | 推荐编码 |
|---|---|
| 线性模型 + 无序特征 | 独热编码 |
| 线性模型 + 有序特征 | 序数编码 |
| 二分类 | 标签编码 |
| 树模型 | 标签编码 |
| 神经网络 | Embedding(特征过多时) |
| 多分类标签 | 标签编码 |
7. 特征工程:构造与删除
7.1 核心理念
原始数据只是原材料,需要基于业务理解对数据集做关键处理,帮助模型挖掘数据背后的真正规律。
7.2 特征构造
示例 1:合并家庭规模
- Titanic 中有多个与亲戚数量相关的特征(SibSp, Parch)
- 合并为
FamilySize = SibSp + Parch + 1 - 标记
IsAlone:如果FamilySize = 1则为 1 - 家庭结构可能影响逃生策略
示例 2:从姓名提取头衔 (Title)
- 很多人的名字里带着头衔(Mr, Mrs, Master 等)
- 特殊头衔(Lady, Sir)能反映社会地位
- 这些信息可能影响逃生策略
- 提取后作为新特征使用
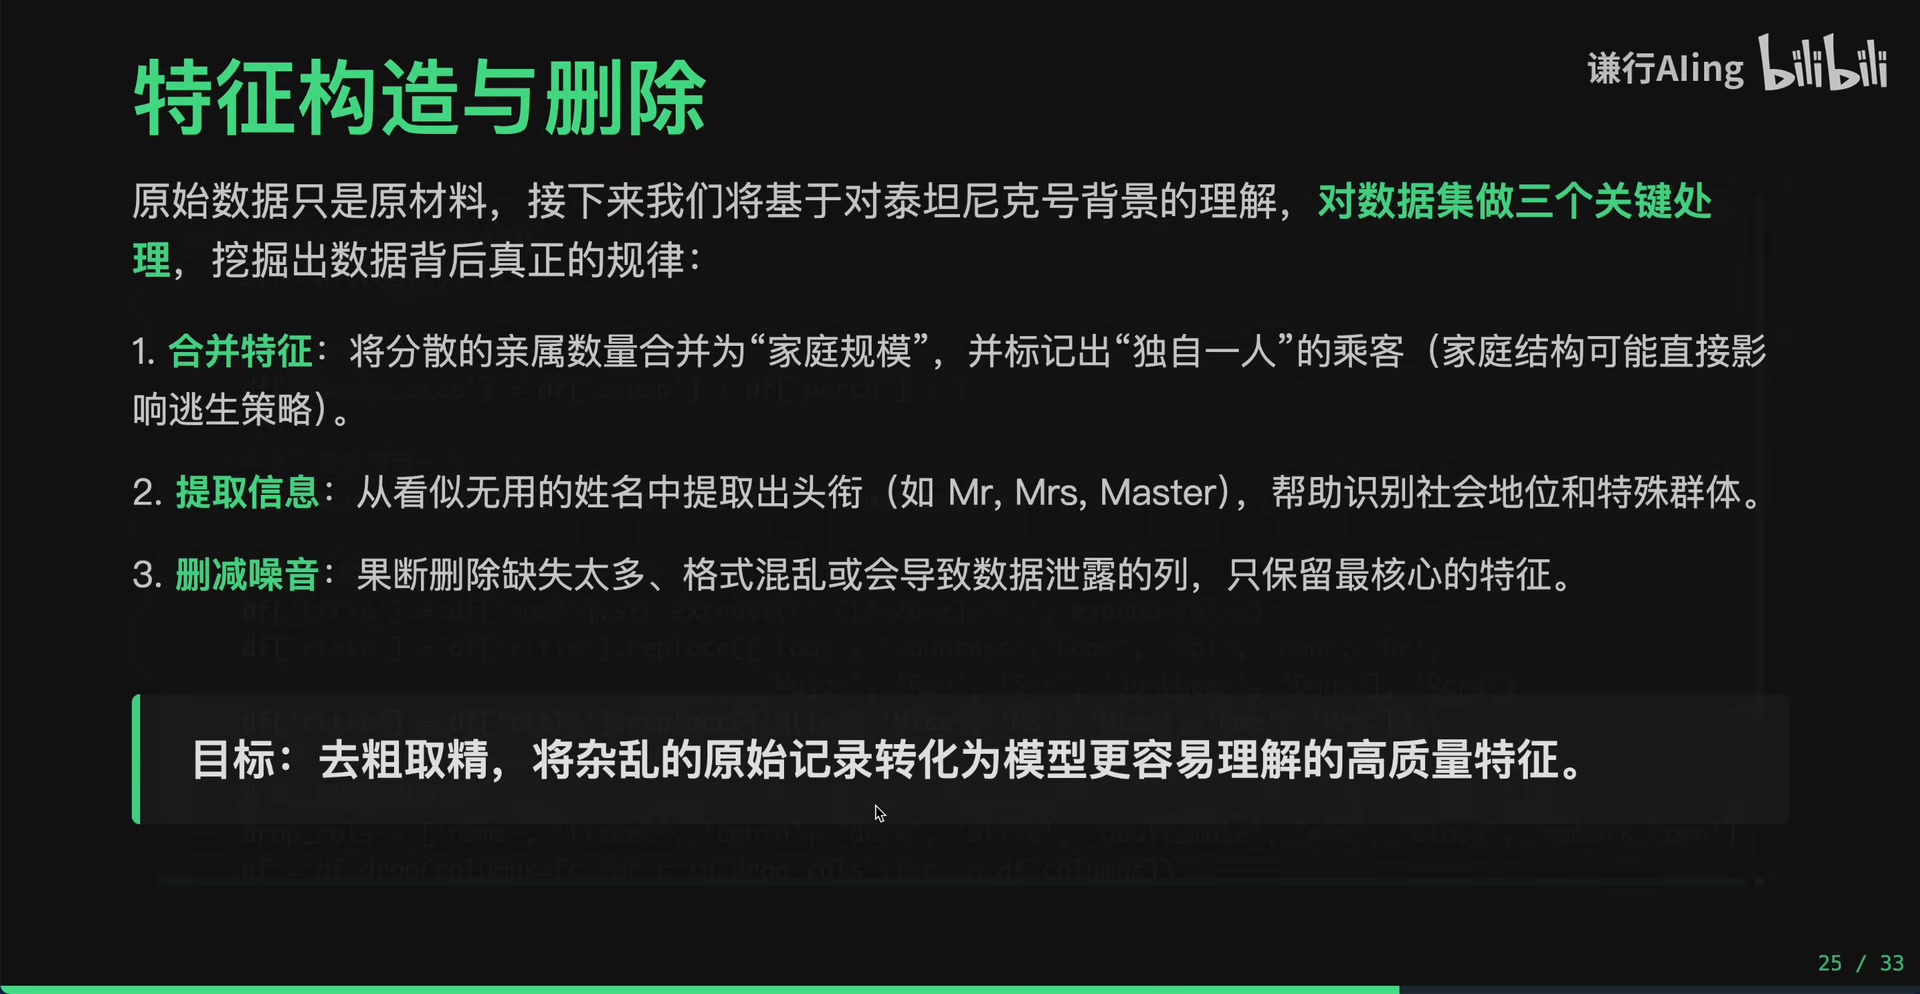 *
7.3 特征删除
- 缺失值太多的列
- 格式混乱的列
- 明显会导致数据泄露的列
7.4 特征工程的本质
去粗取精:把杂乱的原始记录转化成模型更容易理解的高质量特征。
💡 提示:在后面的无监督学习中,降维 (Dimensionality Reduction) 会做更多此类操作。无监督学习常作为监督学习的前一步,对数据做处理。
8. 特征缩放
8.1 为什么需要特征缩放
数据集中部分特征的量纲差异可能非常大:
Age:0~80Fare:0~100SibSp:0~8
如果不进行缩放:
- 模型会错误地认为数值比较大的特征更重要
- 会赋予其过大的权重
- 导致梯度下降更新参数时反复震荡
- 需要非常多的迭代次数才能找到最优解
- 甚至可能最终都无法收敛
类比:上节课讲梯度下降时,把房间面积改成百平米,实际就是最简单的数据缩放。
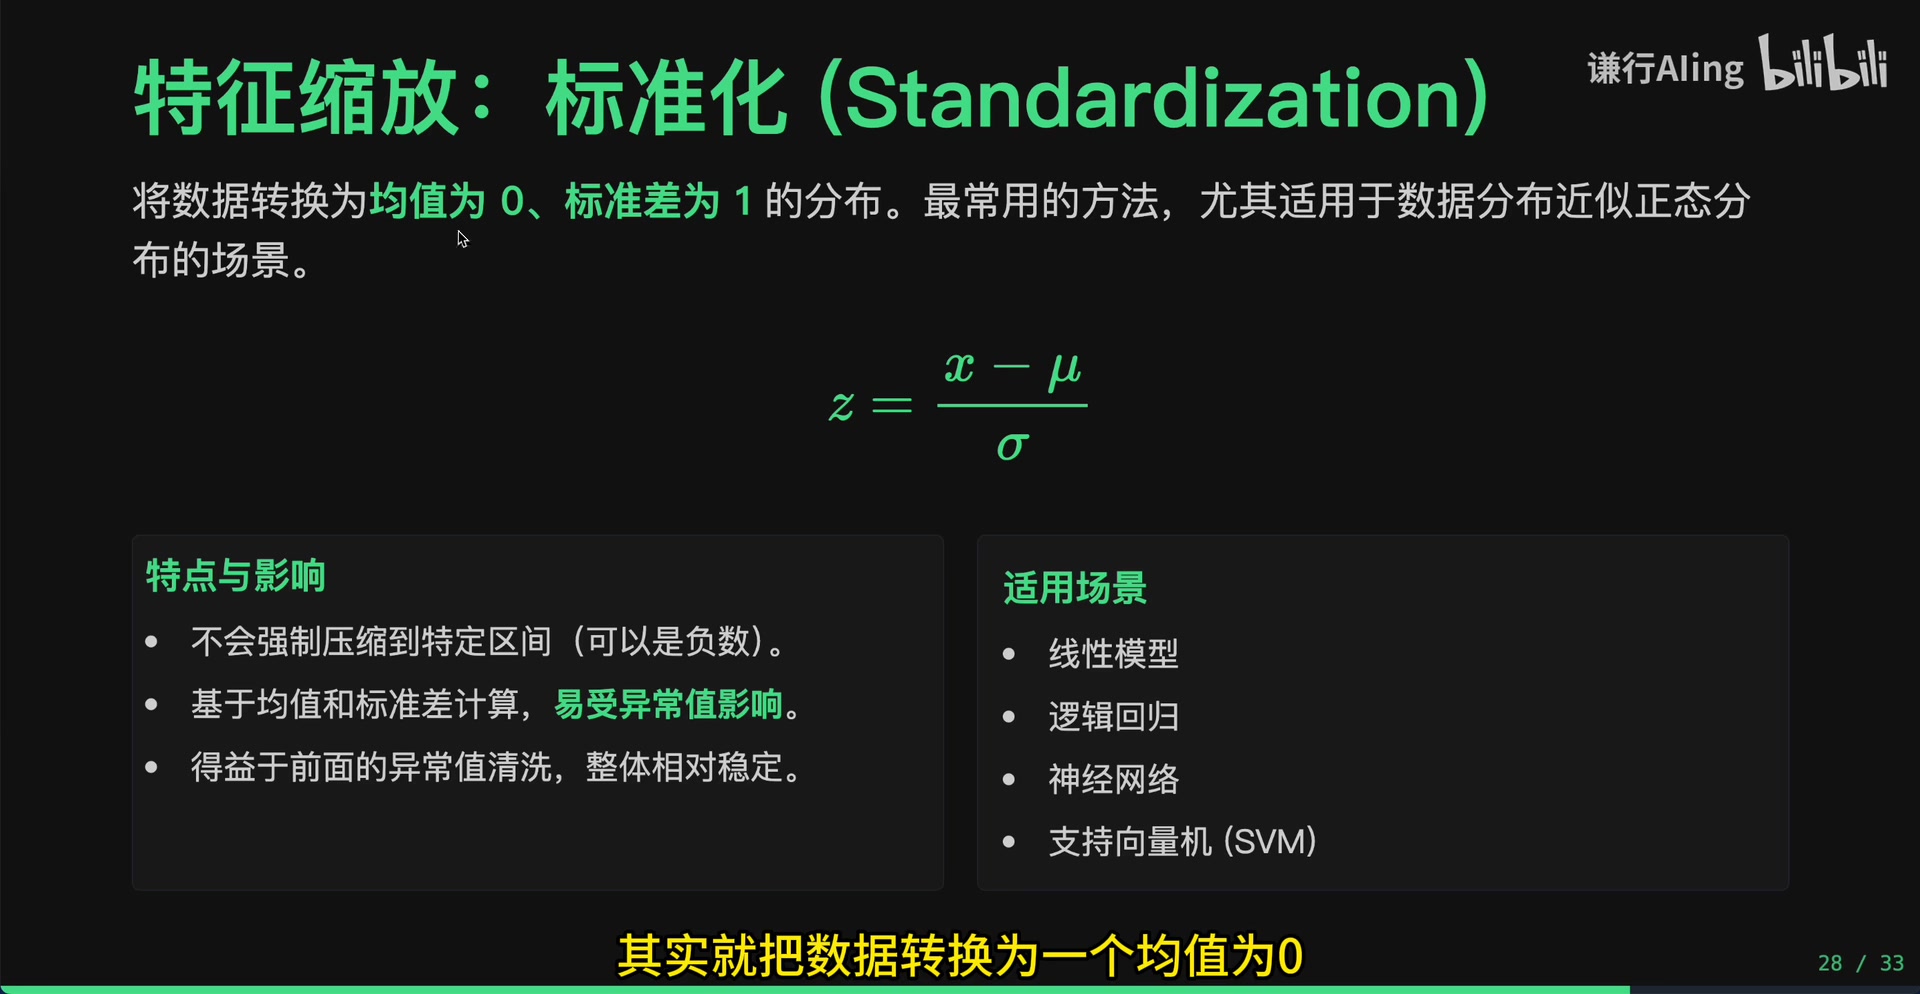
8.2 标准化 (Standardization)
定义:把数据转换为一个均值为 0、标准差为 1 的分布。
公式:
$$X_{std} = \frac{X - \mu}{\sigma}$$
其中 $\mu$ 是均值,$\sigma$ 是标准差。
特点:
- 不会强制压缩到特定区间,所以可能为负数
- 只要均值 ≈ 0,标准差 ≈ 1 即可
- 非常受异常值影响(应在标准化前先处理异常值)
- 最常用,尤其是数据分布近似正态分布时
适用场景:
- 线性模型
- 逻辑回归
- 基本上都要用标准化
 *
代码实现:
from sklearn.preprocessing import StandardScaler |
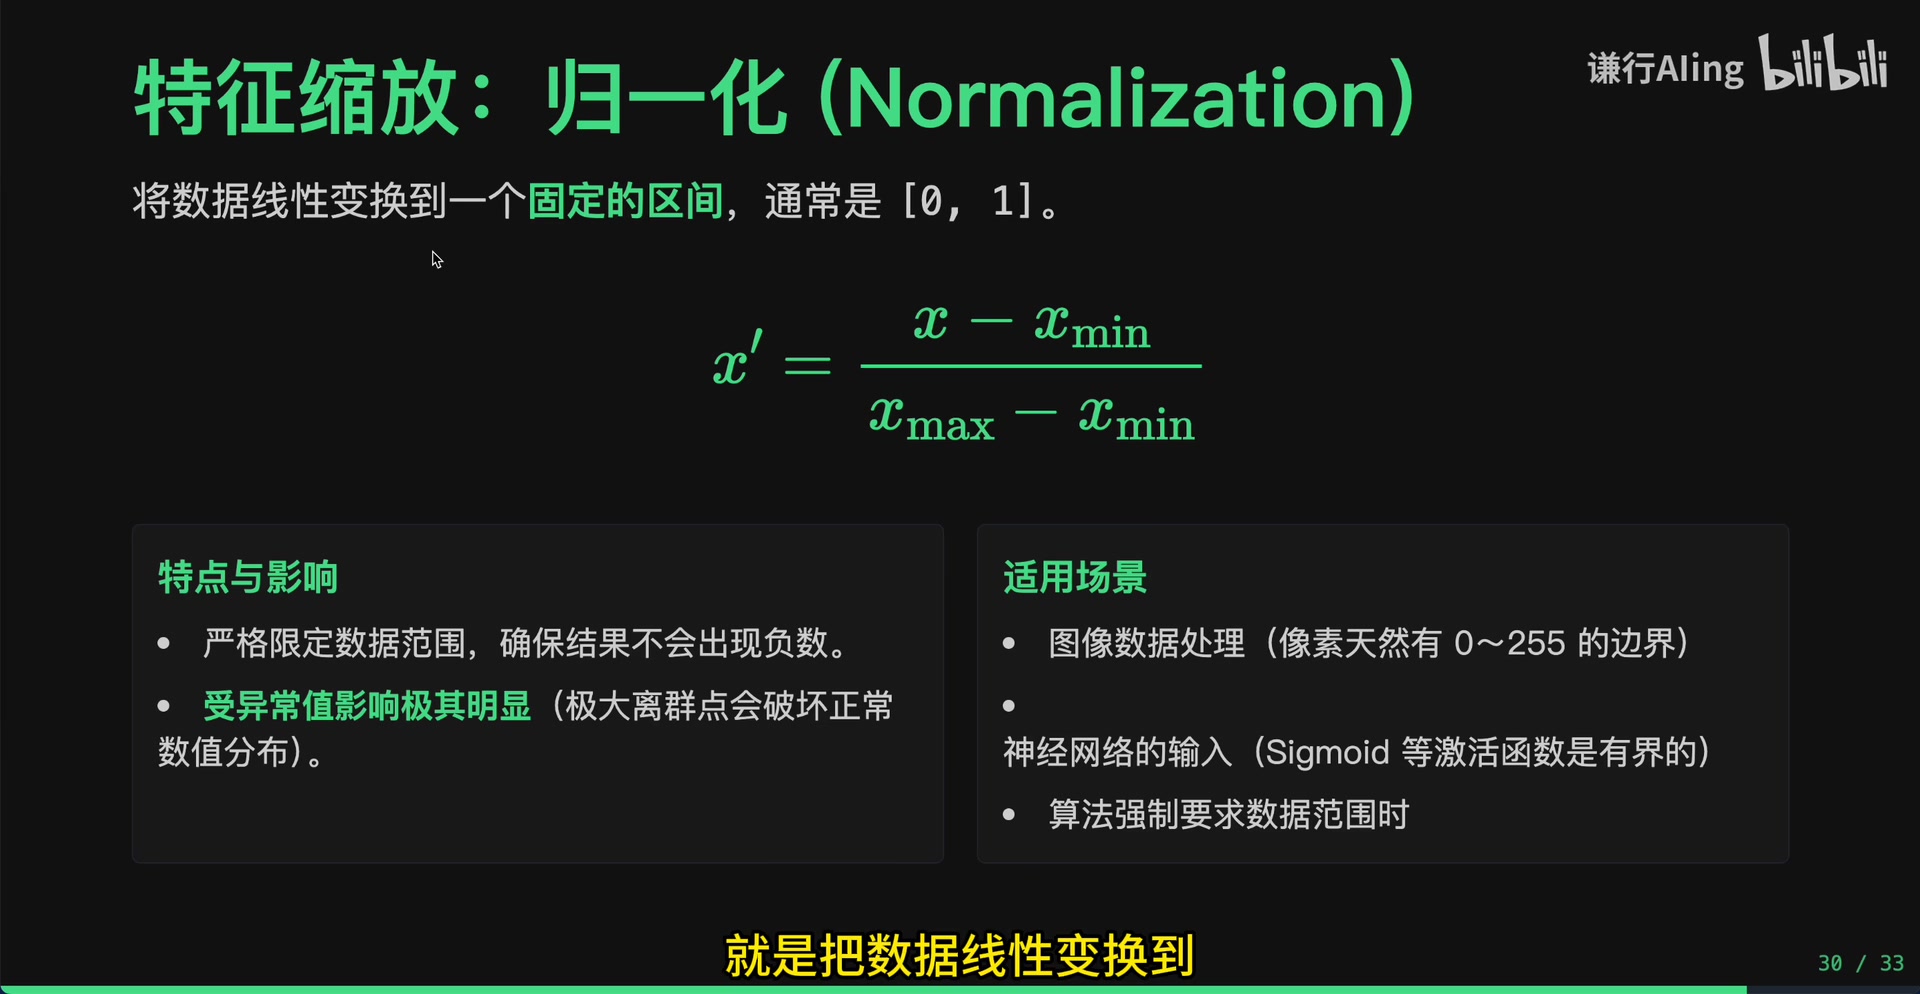
8.3 归一化 (Normalization)
定义:把数据线性变换到一个固定的区间,通常是 [0, 1]。
公式:
$$X_{norm} = \frac{X - X_{min}}{X_{max} - X_{min}}$$
特点:
- 严格限定数据范围
- 确保结果中不会出现负数
- 受异常值影响非常大(离群点会破坏正常分布)
适用场景:
- 图像处理(像素天然在 0~255 之间)
- 神经网络输入(因为 sigmoid 激活函数输出 0~1)
- 深度学习中用得更多
 *
8.4 标准化 vs 归一化对比
| 特性 | 标准化 | 归一化 |
|---|---|---|
| 输出范围 | 不固定(可能为负) | 固定 [0, 1] |
| 受异常值影响 | 较小 | 较大 |
| 适用分布 | 近似正态分布 | 任意分布 |
| 典型应用 | 线性模型、逻辑回归 | 神经网络、图像处理 |
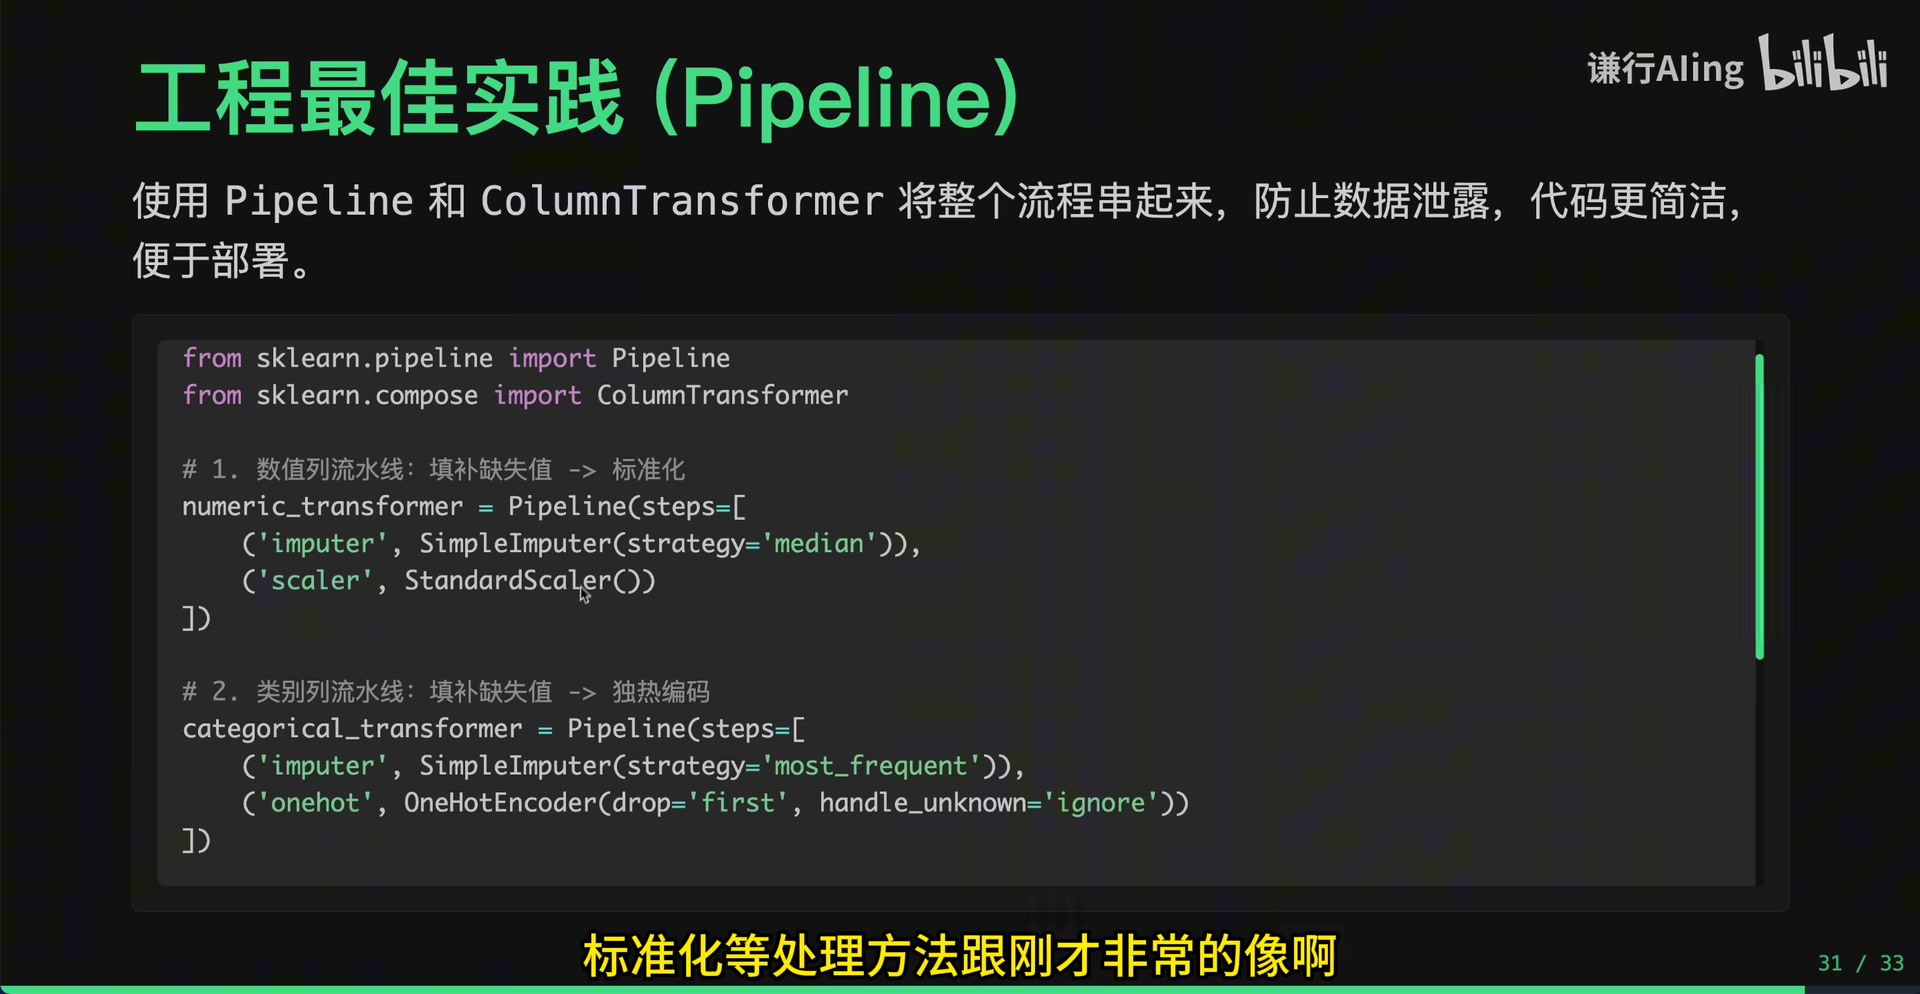
9. Pipeline 流水线
9.1 为什么需要 Pipeline
前面的预处理步骤非常多,流程特别长,中间容易出错。必须严格记住:
- 只能在训练集上 fit
- 在训练集和测试集上 transform
scikit-learn 提供了两个工具帮助自动化:
- Pipeline:串联多个处理步骤
- ColumnTransformer:对不同列应用不同处理
9.2 使用示例
from sklearn.pipeline import Pipeline |
 *
10. 核心原则总结
数据预处理的四个核心原则:
10.1 Garbage In, Garbage Out
数据质量决定模型上限。再好的算法也没法从垃圾数据中学到有价值的规律。
10.2 先划分数据集,再做预处理
- 训练集:fit(学习规律)
- 测试集:transform(用训练集学到的参数做转换)
- 避免数据泄露
10.3 用 EDA 探索数据
- 用图表看看数据究竟有什么问题
- 不知道要做哪些预处理时,EDA 是首选
10.4 用 Pipeline 自动化流程
- 处理步骤多,容易出错
- 用 Pipeline 封装,避免忙中出错
11. 完整预处理流程回顾
1. 加载数据 → df |
经过完整的数据预处理后,就可以进入真正的模型训练与评估阶段了。如果发现模型无法拟合数据或出现过拟合,下节课将学习如何识别和处理这些问题。
refer
-
声明:
若文章存在错误,望诸君不吝指正^
blog仅供个人记录学习所用部分笔记由于年代久远,做的笔记找不到最初是引用谁的,若是不允许引用转载,请联系我