HTTP协议相关知识
HTTP是什么
HTTP 是超文本传输协议,也就是HyperText Transfer Protocol。是一种用于分布式、协作式和超媒体信息系统的应用层协议。是一个基于请求与响应,无状态的,应用层的协议,常基于 TCP/IP 协议传输数据,互联网上应用最为广泛的一种网络协议,所有的互联网文件都必须遵守这个标准。
HTTP的名字「超文本协议传输」,它可以拆成三个部分:
协议
HTTP 是一个用在计算机世界里的协议。它使用计算机能够理解的语言确立了一种计算机之间交流通信的规范(两个以上的参与者),以及相关的各种控制和错误处理方式(行为约定和规范)。
传输
就是把一堆东西从 A 点搬到 B 点,或者从 B 点 搬到 A 点。HTTP 协议是一个双向协议。HTTP 是一个在计算机世界里专门用来在两点之间传输数据的约定和规范。我们在上网冲浪时,浏览器是请求方 A ,百度网站就是应答方 B。双方约定用 HTTP协议来通信,于是浏览器把请求数据发送给网站,网站再把一些数据返回给浏览器,最后由浏览器渲染在屏幕,就可以看到图片、视频了。
超文本
HTTP 传输的内容是「超文本」「文本」,在互联网早期的时候只是简单的字符文字,但现在「文本」。的涵义已经可以扩展为图片、视频、压缩包等,在 HTTP 眼里这些都算做「文本」。「超文本」,它就是超越了普通文本的文本,它是文字、图片、视频等的混合体,最关键有超链接,能从一个超文本跳转到另外一个超文本。HTML 就是最常见的超文本了,它本身只是纯文字文件,但内部用很多标签定义了图片、视频等的链接,在经过浏览器的解释,呈现给我们的就是一个文字、有画面的网页了。
HTTP客户端请求消息
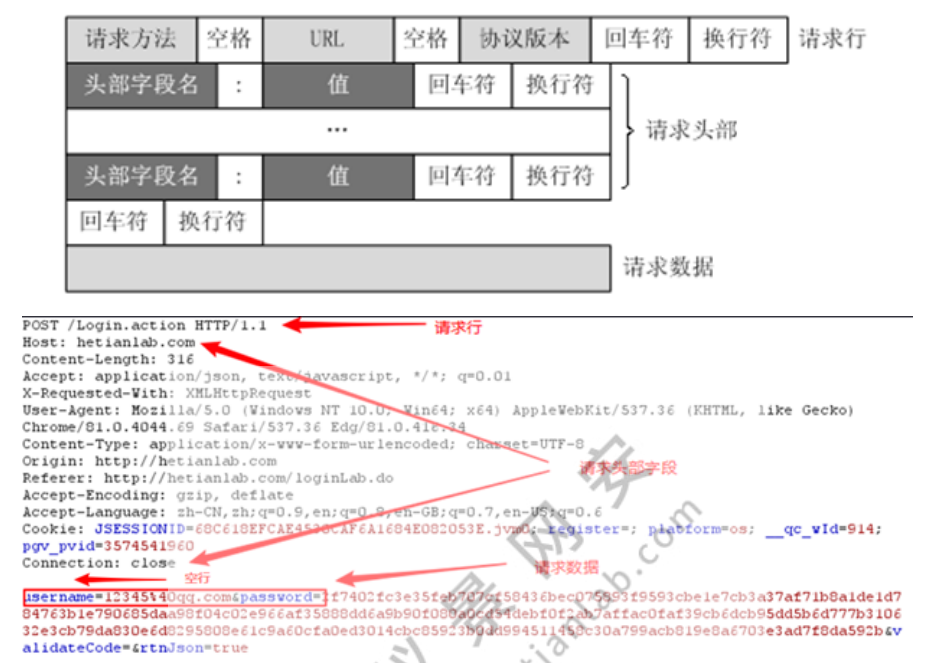
HTTP请求报文:web客户端向服务器发送的请求
HTTP请求由四个部分组成:
- 请求行
- 请求头部
- 空行
- 请求正文
请求行
Method Request-URI HTTP-Version CRLF |
请求方法
HTTP1.0 定义了三种请求方法: GET, POST 和 HEAD方法。 |
请求头部字段
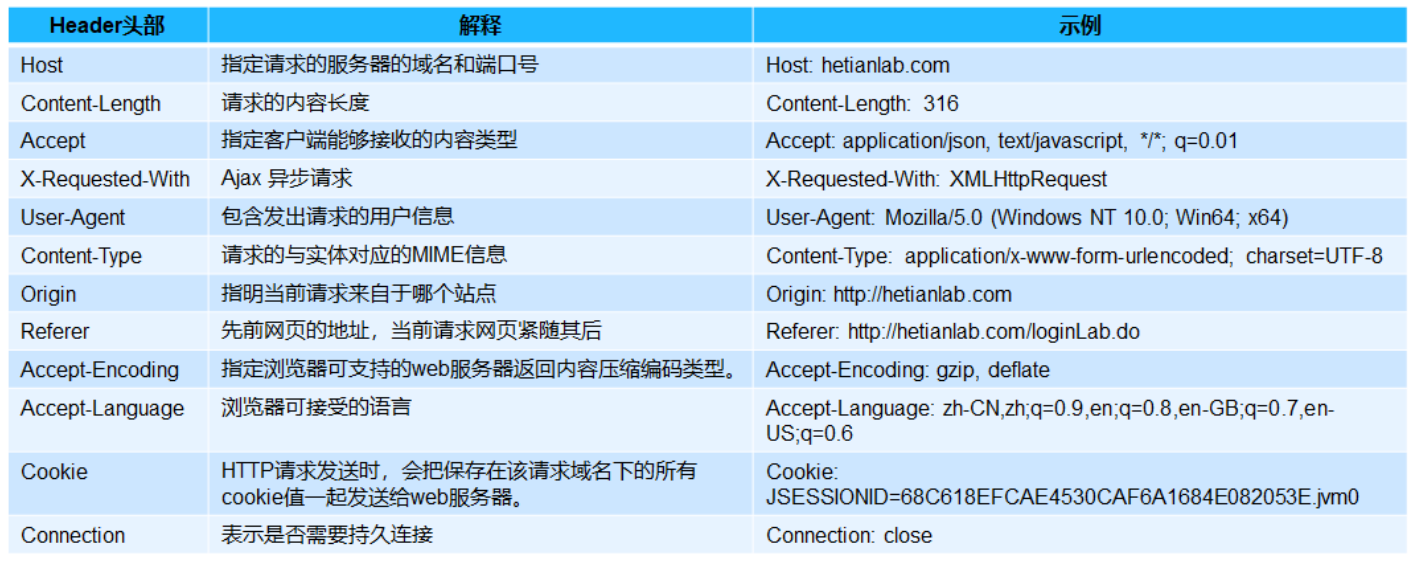
由关键字/值对组成,每行一对,关键字和值用冒号分享。请求头标通知服务器腾于客户端的功能和标识。
请求头部字段:(Request Header Fields)允许客户端传递关于自身的信息和希望的响应形式。
在HTTP/1.1协议中,所有的请求头,除Host外,都是可选的。注意useragent,accept,origin等字段
Header:Header_Value CRLF //注意冒号后面和头部值之间有一个空格 |
Host:
客户端发送请求时,用来指定服务器的域名。有了 Host 字段,就可以将请求发往「同一台」服务器上的不同网站。
Host: www.A.com
Content-Length:
服务器在返回数据时,会有 Content-Length 字段,表明本次回应的数据长度。
Content-Length: 1000如上面则是告诉浏览器,本次服务器回应的数据长度是 1000 个字节,如果还有更多的数据在后面,那就 属于下一个回应了。
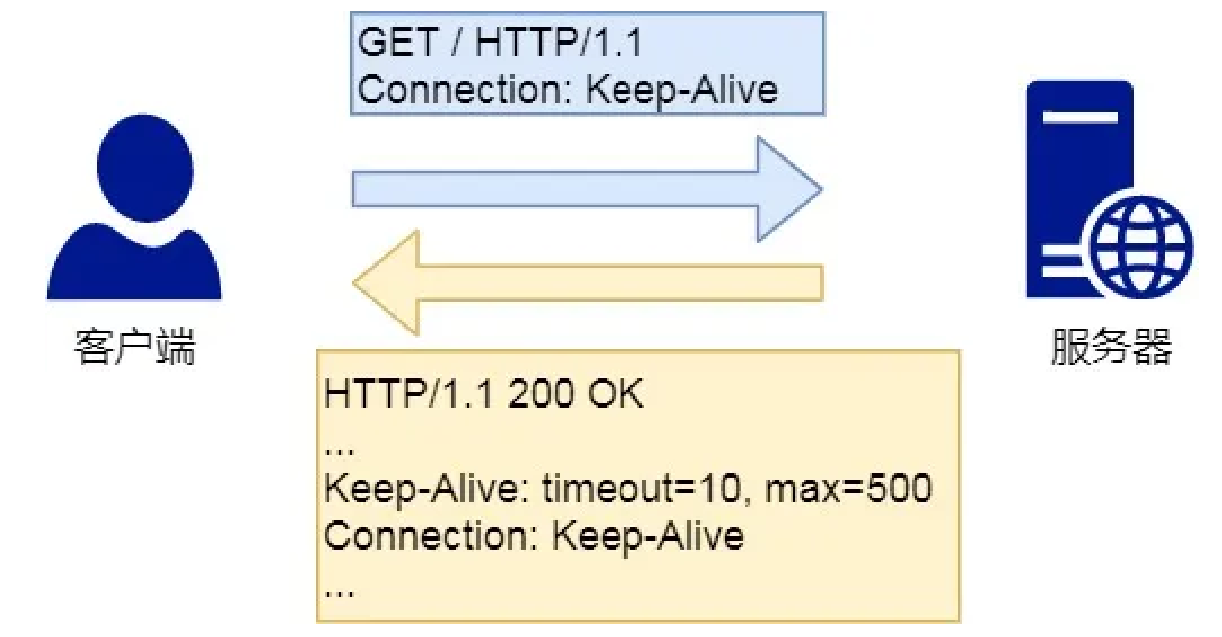
Connection:Connection
字段最常用于客户端要求服务器使用 TCP 持久连接,以便其他请求复用。HTTP/1.1 版本的默认连接都是持久连接,但为了兼容老版本的 HTTP,需要指定Connection 首部字段的值为 Keep-Alive 。一个可以复用的 TCP 连接就建立了,直到客户端或服务器主动关闭连接。但是,这不是标准字段。
Connection: keep-alive
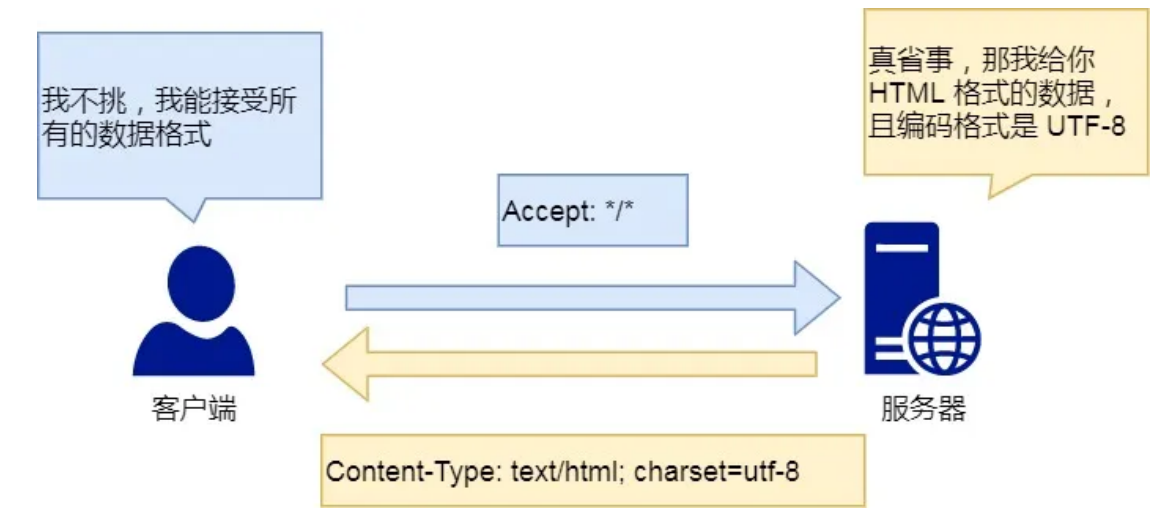
Content-Type:
Content-Type 是 HTTP 协议中的一个重要请求头或响应头字段,用于声明传输数据的媒体类型(MIME 类型),帮助客户端和服务器理解如何处理数据。
它的核心作用包括:
- 定义数据格式
明确传输内容的类型,例如文本、图片、JSON 或二进制文件等。
- 示例:
text/html→ HTML 页面application/json→ JSON 数据image/png→ PNG 图片
- 指定字符编码
可附加字符集信息,确保文本正确解析(如中文不乱码)。
- 示例:
text/plain; charset=utf-8→ UTF-8 编码的纯文本text/html; charset=gbk→ GBK 编码的 HTML
- 指导客户端行为
浏览器根据Content-Type决定如何渲染内容(如显示图片、下载文件等)。
- 若响应头为
application/pdf,浏览器可能直接打开 PDF 文件; - 若为
application/octet-stream,浏览器会触发下载。
- 若响应头为
常见场景:
1. 请求中的 Content-Type
当客户端发送数据(如 POST 请求)时,需告知服务器数据的格式:
POST /api/user |
- 如果服务器期望 JSON 但未收到正确的
Content-Type,可能返回415 Unsupported Media Type错误。
2. 响应中的 Content-Type
服务器返回数据时需明确类型,以便客户端处理:
200 OK |
- 若错误设置为
text/plain,浏览器会将 HTML 代码显示为纯文本。
3. 表单提交
- 默认表单:
Content-Type: application/x-www-form-urlencoded(键值对编码)。 - 文件上传:
Content-Type: multipart/form-data(支持二进制文件)。
常见 MIME 类型
| 类型 | 用途 | 示例值 |
|---|---|---|
text/plain |
纯文本 | 日志、简单文本 |
text/html |
HTML 页面 | 网页内容 |
application/json |
JSON 数据 | API 响应 |
application/xml |
XML 数据 | 配置、数据交换 |
image/jpeg |
JPEG 图片 | 图片资源 |
multipart/form-data |
表单文件上传 | 上传文件 |
application/octet-stream |
二进制流(如文件下载) | 下载未知类型文件 |
注意事项
- 必填性:
- 在 POST/PUT 请求中,
Content-Type通常必须明确指定。 - 若缺失或错误,可能导致服务器无法解析请求体。
- 在 POST/PUT 请求中,
- 安全影响:
- 错误设置可能引发漏洞(如将用户输入直接作为
text/html返回,导致 XSS 攻击)。
- 错误设置可能引发漏洞(如将用户输入直接作为
- 与
Accept头的区别:
Content-Type表示发送方的数据类型;Accept表示接收方期望的数据类型(如Accept: application/json)。
Content-Type: text/html; charset=utf-8 |
Accept :
客户端请求的时候,可以使用 Accept 字段声明自己可以接受哪些数据格式。指浏览器或其他客户可以接爱的 MIME 文件格式。Servlet 可以根据它判断并返回适当的文件格式。
Accept: \*/\* |
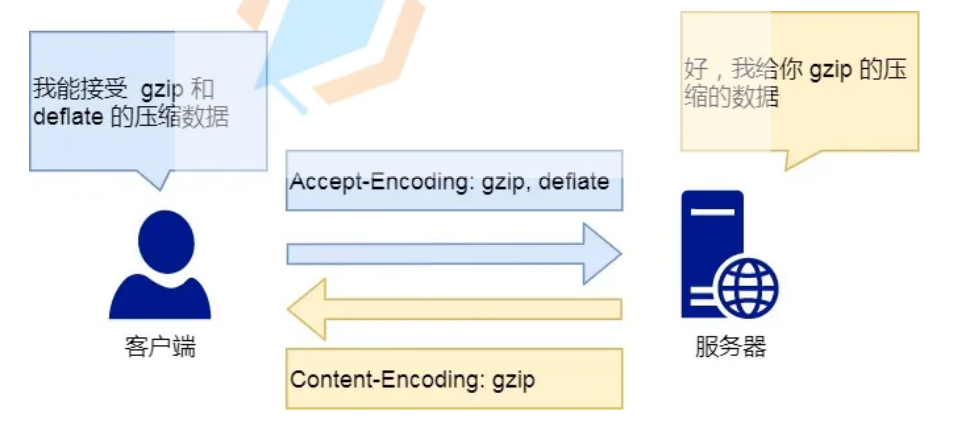
Content-Encoding:
Content-Encoding 字段说明数据的压缩方法。表示服务器返回的数据使用了什么压缩格式
Content-Encoding: gzip |
Accept-Encoding:
客户端在请求时,用 Accept-Encoding 字段说明自己可以接受哪些压缩方法。
Accept-Encoding: gzip, deflate |
Connection:
用来告诉服务器是否可以维持固定的 HTTP 连接。http 是无连接的,HTTP/1.1 使用 Keep-Alive为默认值,这样,当浏览器需要多个文件时(比如一个 HTML 文件和相关的图形文件),不需要每次都建立连接
Cookie:
浏览器用这个属性向服务器发送 Cookie。Cookie 是在浏览器中寄存的小型数据体,它可以记载和服务器相关的用户信息,也可以用来实现会话功能。
Referer :
表 明 产 生 请 求 的 网 页 URL 。 如 比 从 网 页 /icconcept/index.jsp 中 点 击 一 个 链 接 到 网 页/icwork/search , 在 向 服 务 器 发 送 的 GET/icwork/search 中 的 请 求 中 , Referer 是http://hostname:8080/icconcept/index.jsp。这个属性可以用来跟踪 Web 请求是从什么网站来的。
空行
表示请求头结束,请求正文(请求体)开始
请求正文
- GET方法:提交数据时,数据参数会作为URL的一部分,放在文件路径后面发送给服务器,被称为查询字符串
http://www.hetianlab.com?username=12345%40qq.com&password=2f7402f......a592b&validateCode=&rtnJson=true |
- POST方法:发送的数据在请求体中
username=12345%40qq.com\&password=2f7402f......a592b\&validateCode=\&rtnJson=true |
- URL编码
注意%40是URI的编码方式,在burpsuite之中可以用CTRL+SHIFT+U对之进行解码,CTRL+U进行URL编码
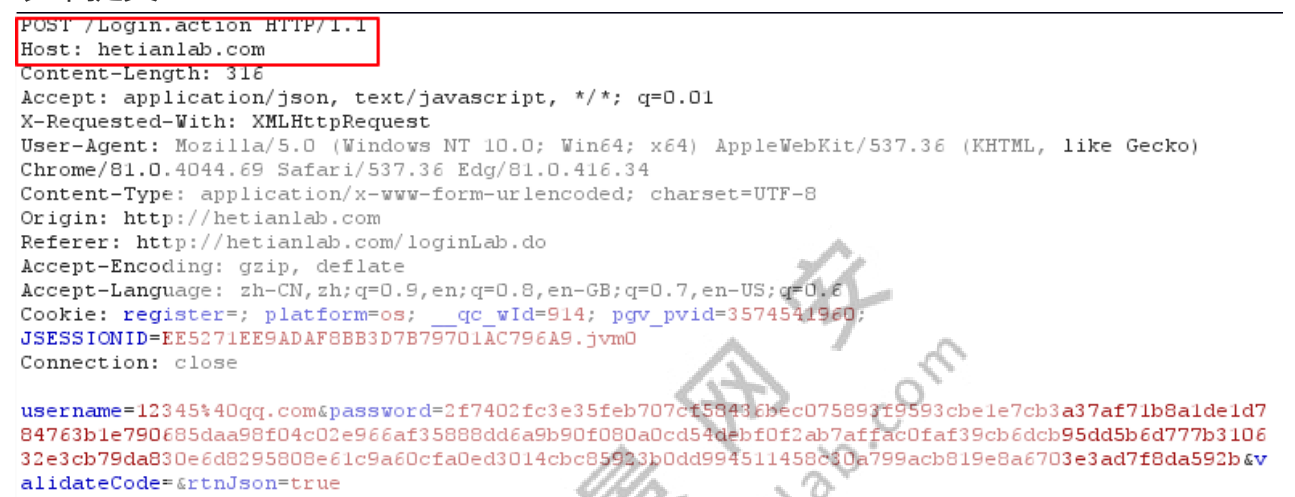
合天网安登录界面POST的包
百分号编码又叫做URL编码,是一种编码机制,只要用于URI(包含URL和URN)编码中。
URL中那些字符需要编码,又为什么进行编码?
为什么会需要编码?
那是因为这样东西不适合传输。原因可能有很多种:大小过大,包含隐私数据。对于URL而言,之所以进行编码是因为URL中有一些字符会引起歧义。
**例如:**URL参数字符串中使用键值对这样的形式来传参,键值对之间使用了 & 符号分隔。
如果value字符串中包含了 @ 或 & 等字符,那么一定会造成接收URL的服务器解析错误,因此就需要对造成歧义的 @ 和 & 进行转义,对其进行编码。
还有,如果URL的字符集使用的ASCII 码,不是 Unicode,这就意味着不可以在 URL 中包含任何的非 ASCII 码,例如:中文,否则客户端浏览器和服务器设定的字符集不同的情况下,输入的中文就会出现乱码。
百分号编码(URL编码)会对URL不允许出现的字符或者其他特殊情况的允许的字符进行编码,对于被编码的字符,最终会转为百分号 % 开头,后面跟这昂个十六进制数字的形式。例如:空格(SP)是不允许的字符,在ACSII码中对应的的二进制值是 00100000 ,最终转换为 %20。
URL编码的原则就是使用安全的字符(没有特殊用途或者特殊意义的可打印字符)去掉那些不安全的字符,以保证内容的正常显示。
HTTP服务端响应消息
HTTP响应报文:在接收和解释请求消息后,服务器返回一个HTTP响应消息。HTTP响应也由四个部分组成,分别是:
- 状态行
- 消息报头(响应报头字段)
- 空行
- 响应正文
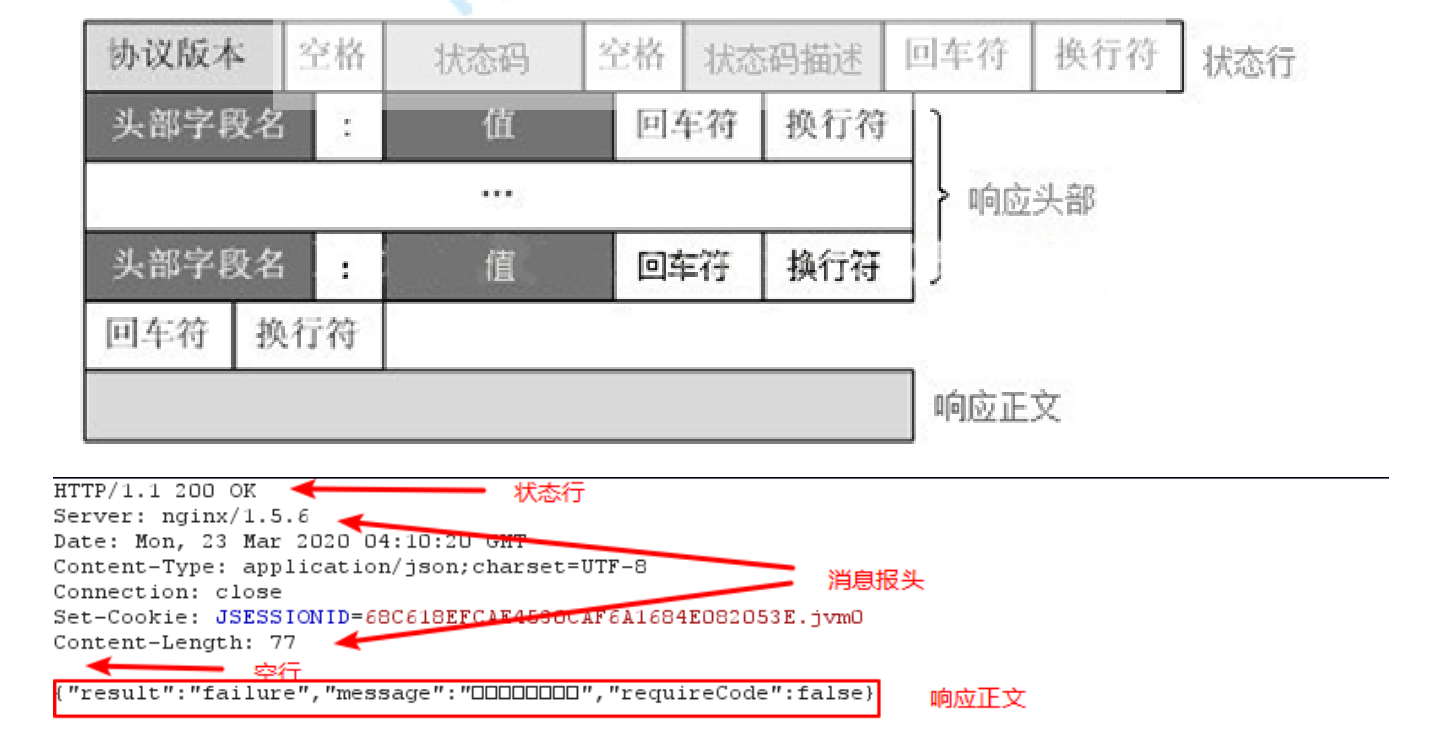
状态行
HTTP-Version Status-Code Reason-Phrase CRLF |
状态码
五大类HTTP状态码
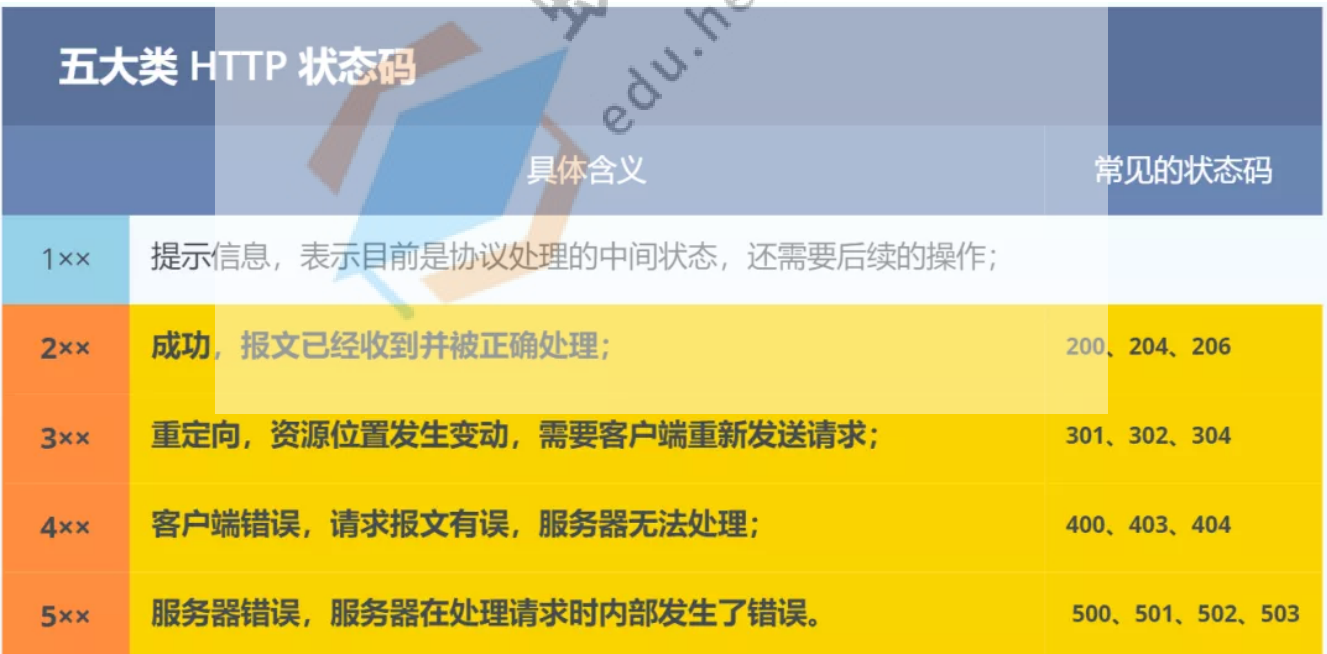
1xx 类状态码属于提示信息,是协议处理中的一种中间状态,实际用到的比较少。表示信息,请求收到,继续处理
2xx 类状态码表示服务器成功处理了客户端的请求,也是我们最愿意看到的状态。表示成功,行为被成功地接受、理解和采纳
- 「200 OK」是最常见的成功状态码,表示一切正常。如果是非 HEAD 请求,服务器返回的响应头都会有 body 数据。
- 「204 No Content」也是常见的成功状态码,与 200 OK 基本相同,但响应头没有body 数据。
- 「206 Partial Content」是应用于 HTTP 分块下载或断电续传,表示响应返回的body 数据并不是资源的全部,而是其中的一部分,也是服务器处理成功的状态。
3xx 类状态码表示客户端请求的资源发送了变动,需要客户端用新的 URL 重新发送请求获取资源,也就是重定向。表示重定向,为了完成请求,必须进一步执行的动作
- 「301 Moved Permanently」表示永久重定向,说明请求的资源已经不存在了,需改用新的 URL 再次访问。
- 「302 Moved Permanently」表示临时重定向,说明请求的资源还在,但暂时需要用另一个 URL 来访问。
- 301 和 302 都会在响应头里使用字段 Location ,指明后续要跳转的 URL,浏览器会自动重定向新的 URL。
- 「304 Not Modified」不具有跳转的含义,表示资源未修改,重定向已存在的缓冲文件,也称缓存重定向,用于缓存控制。
4xx 类状态码表示客户端发送的报文有误,服务器无法处理,也就是错误码的含义。
- 「400 Bad Request」表示客户端请求的报文有错误,但只是个笼统的错误。
- 「403 Forbidden」表示服务器禁止访问资源,并不是客户端的请求出错。
- 「404 Not Found」表示请求的资源在服务器上不存在或未找到,所以无法提供给客户端。
5xx 类状态码表示客户端请求报文正确,但是服务器处理时内部发生了错误,属于服务器端的错误码。
- 「500 Internal Server Error」与 400 类似,是个笼统通用的错误码,服务器发生了什么错误,我们并不知道。
- 「501 Not Implemented」表示客户端请求的功能还不支持,类似“即将开业,敬请期待”的意思。
- 「502 Bad Gateway」通常是服务器作为网关或代理时返回的错误码,表示服务器自身工作正常,访问后端服务器发生了错误。
- 「503 Service Unavailable」表示服务器当前很忙,暂时无法响应服务器,类似“网络服务正忙,请稍后重试”的意思。
几个比较重要的状态码:
- 200:存在文件
- 403:存在文件夹
- 3xx:均可能存在
- 404:不存在文件及文件夹
- 500:均可能存在
响应头部字段
响应头部字段(Response Header Fields):
响应报头允许服务器传递不能放在状态行中的附加响应信息,以及关于服务器的信息和对 Request-URI 所标识的资源进行下一步访问的信息。
常见头部:
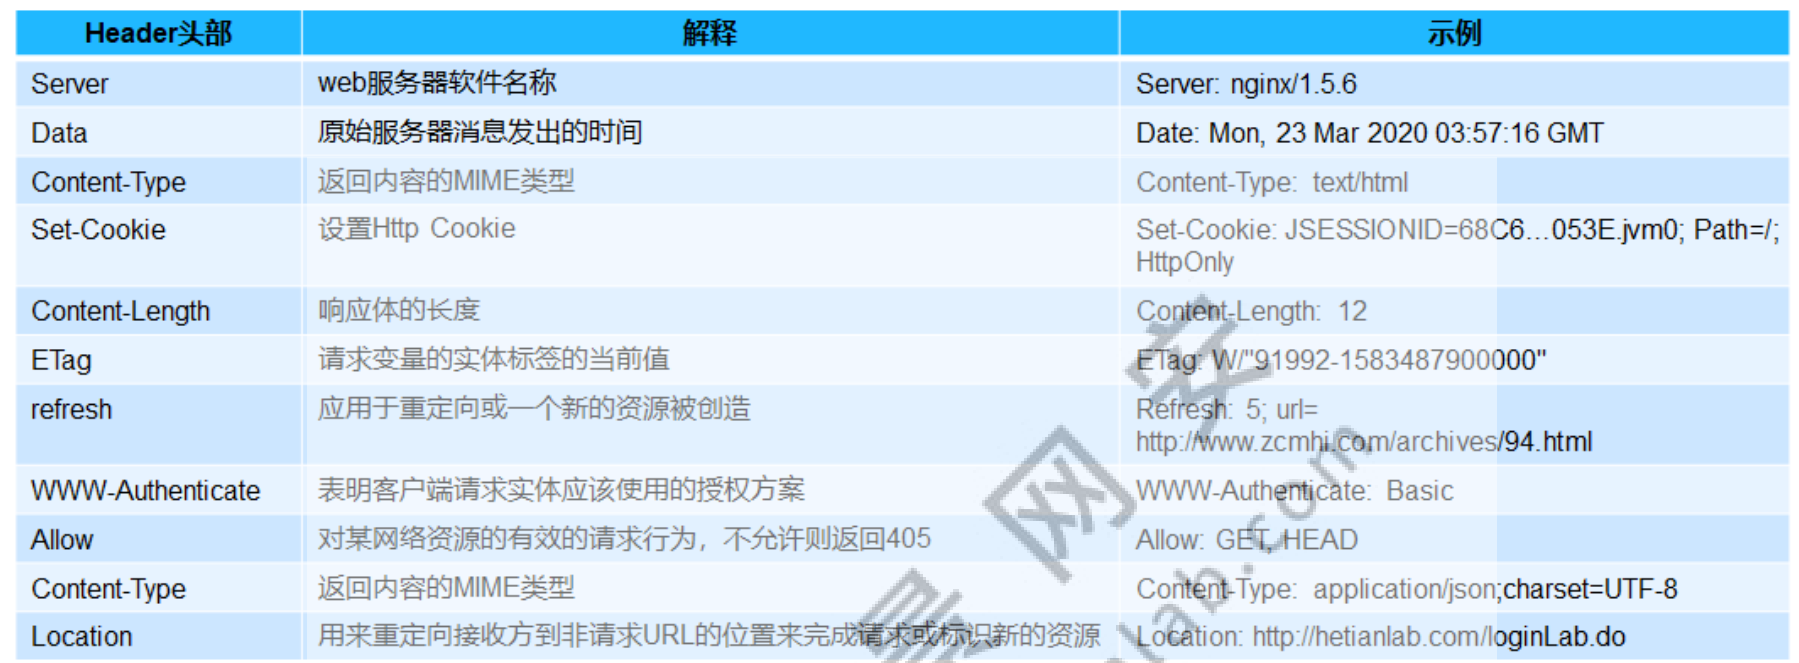
注意:
- 这个表格里面的data应该改为date,是日期
- setcookie字段:在用户第一次访问网站后的响应包中,服务器会在setcookie字段返回给客户一个cookie,以此来表示此后每一次访问用户的身份。
X-Real-IP 与 X-Forwarded-For 与 Remote Address
X-Real-IP:从字面看 X-Real-IP 代表的是客户端请求真实的 IP 地址,这个参数没有相关标准规范,如果是直接访问的请求,可能是客户端真实的 IP 地址,但是中间若经过了层层的代理,就是最后一层代理的 IP 地址。
X-Forwarded-For 记录着从客户端发起请求后访问过的每一个 IP 地址,当然第一个是发起请求的客户端本身的地址,各 IP 地址间由“英文逗号+空格”(
,)分隔。X-Forwarded-For 请求头格式:
注意到xff是可以伪造IP的,因此,一般来说,我们要获得客户端地址,直接从 X-Forwarded-For 拿到第一个 IP 地址即可。一般代码如下:
// 从ips中切割出client Ip 略X-Forwarded-For 作为 HTTP 请求的扩展头,在请求的过程中可以被直接的进行修改。正常情况下,我们所获得的 ip 第一部分应该是客户端 IP,但是如果客户端对 X-Forwarded-For 进行了修改,我们仍旧采用以上方法获得客户端 IP,那么客户端 IP 将会是被伪造过的。
可以看到,如果只是简单进行获取,可能造成许多安全问题,尤其对于对 IP 具有较高要求的场景,例如投票系统等,可以通过换IP来刷票
Remote Address——与服务器相连的机器的IP
REMOTE_ADDR代表着客户端的IP,但是这个客户端是相对服务器而言的,也就是实际上与服务器相连的机器的IP(建立tcp连接的那个),这个值是不可伪造的,如果没有代理的话,这个值就是用户实际的IP值,有代理的话,用户的请求会经过代理再到服务器,这个时候REMOTE_ADDR会被设置为代理机器的IP值
当你的浏览器访问某个网站时,假设中间没有任何代理,那么网站的web服务器(Nginx,Apache等)就会把remote_addr设为你的机器IP,如果你用了某个代理,那么你的浏览器会先访问这个代理,然后再由这个代理转发到网站,这样web服务器就会把remote_addr设为这台代理机器的IP
Remote Address代表的是当前HTTP请求的远程地址,即HTTP请求的源地址。HTTP协议在三次握手时使用的就是这个Remote Address地址,在发送响应报文时也是使用这个Remote Address地址。因此,如果请求者伪造Remote Address地址,他将无法收到HTTP的响应报文,此时伪造没有任何意义。这也就使得Remote Address默认具有防篡改的功能。
如果Http请求经过代理服务器转发,则这种情况,用户的真实ip会丢失,所以才有了
X-Forwarded-For的方式。
空行
表示响应头结束,响应正文(响应体)开始
响应正文
服务器返回的资源内容:关于这个内容是表示什么意思,还需要结合content-type来具体分析,下面会讲到
{"result":"success","message"\:null} |
HTTP请求方法理解
GET
Get 方法的含义是请求从服务器获取资源,这个资源可以是静态的文本、页面、图片视频等。
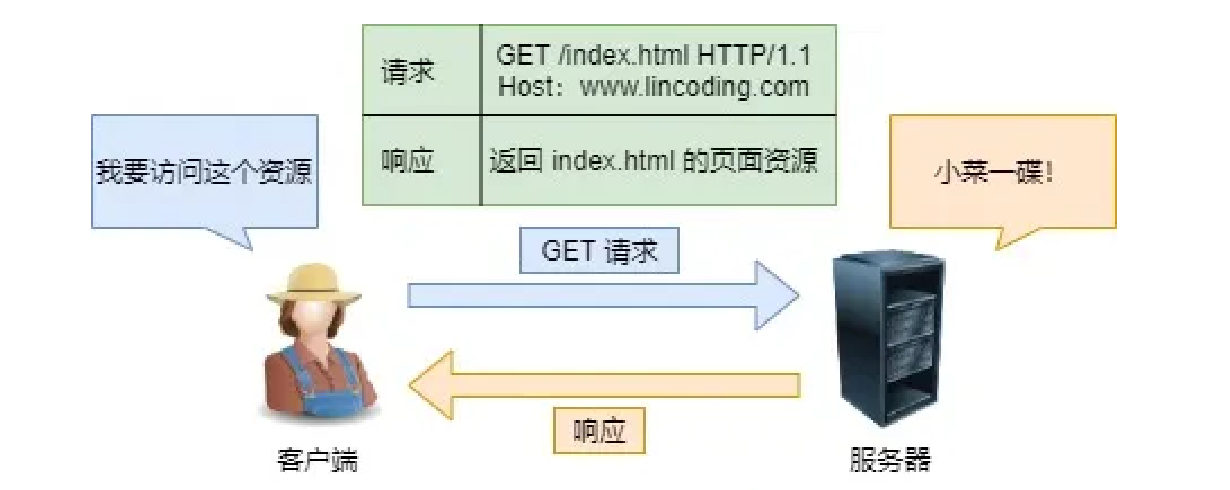
不包含请求主体
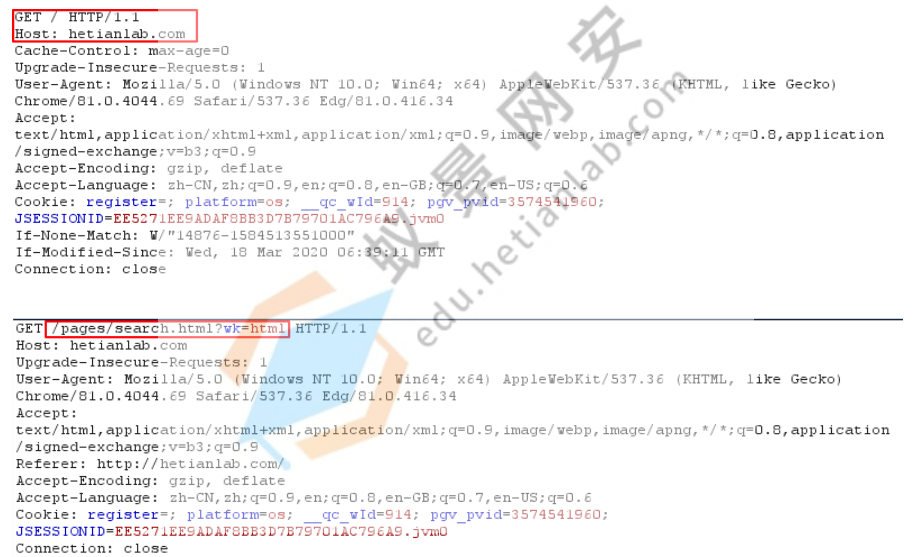
POST
POST:向 Request-URI 所标识的资源提交数据,数据就放在请求正文中用于向指定资源发送数据,指定的资源会对数据进行处理,然后将处理结果返回给客户端,一般用于表单提交、文件上传
POST提交数据的几种 Content-Type :
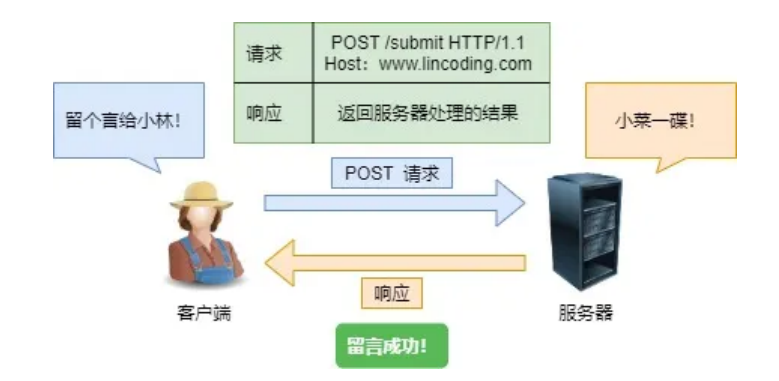
- application/x-www-form-urlencoded :最常见的 POST 提交数据方式,浏览器支持的原生 form 表单
- multipart/form-data :这种方式一般用来上传文件。
- application/json :在响应头中很常见,在请求头中用来告诉服务端消息主体是序列化后的 json 字符串。
下面具体谈谈这三种提交方式
1. application/x-www-form-urlencoded
最常见的POST提交数据方式,浏览器支持的原生form表单提交方式
该方式会将表单内的数据转换为键值对,比如,name=java&age = 23
2. multipart/form-data
这种方式一般用来上传文件,偶尔上传表单数据键值对,没错这种方式也可以像application/x-www-form-urlencoded那样上传表单数据!它既可以上传键值对,也可以上传文件。
当上传表单数据时:
http请求中的multipart/form-data,它会将表单的数据处理为一条消息,以标签为单元,用分隔符分开。当用于上传文件时:
会有
Content-Type来表名文件类型;text/plain文本类型image/jpeg图片格式application/octet-stream脚本类型
content-disposition,传递文件信息,用来说明字段的一些信息;boundary用来分割数据。由于有boundary隔离,所以multipart/form-data既可以上传文件,也可以上传键值对,它采用了键值对的方式,所以可以上传多个文件
一个实际案例便于理解
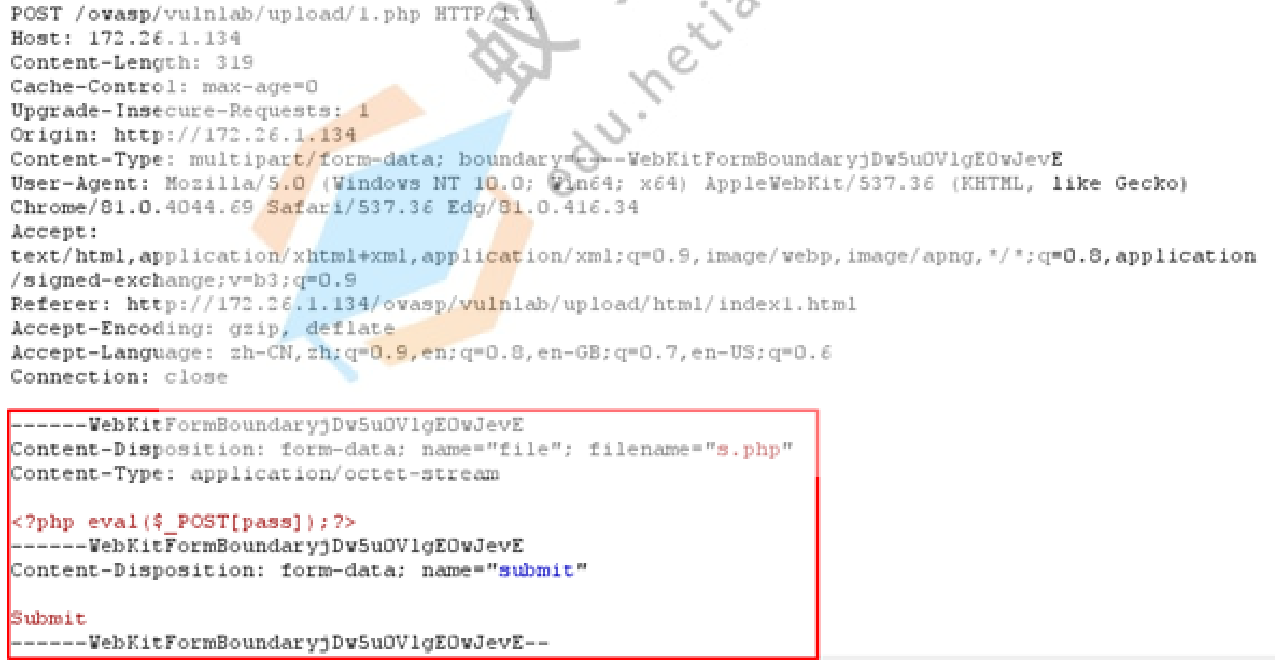
上图内容细节解释:
客户端生成一个 boundary ,其值是一个很长的字符串, 用于分割不同的字段,为了避免与正 文内容重复,boundary 很长很复杂;
然后 Content-Type 里指明了数据是以 mutipart/form-data 来编码,本次请求的 boundary 是什么内容。两个content-type,第一个在头部的告诉客户端我要用表单上传文件,第二个在响应正文中表示上传的文件类型
消息主体里按照字段个数又分为多个结构类似的部分,每部分都是以 —–boundary 开始
紧接着内容描述信息,然后是回车,最后是字段具体内容(文本或二进制)。
如果传输的是文件,还要包含文件名和文件类型信息。
消息主体最后以 ——boundary– 标示结束。
关于conetnt-disposition的解释:
conetnt-disposition就是定义文件内容呈现方式,在不同位置有不同的用法具体可参考链接的解释:在常规的 HTTP 应答中,Content-Disposition 响应头指示回复的内容该以何种形式展示,是以内联的形式(即网页或者页面的一部分),还是以附件的形式下载并保存到本地。
在 HTTP 场景中,第一个参数或者是 inline(默认值,表示回复中的消息体会以页面的一部分或者整个页面的形式展示),或者是 attachment(意味着消息体应该被下载到本地;大多数浏览器会呈现一个“保存为”的对话框,将 filename 的值预填为下载后的文件名,假如它存在的话)。
Content-Disposition: attachment
Content-Disposition: attachment; filename="filename.jpg"在 HTTP 场景中。第一个参数总是固定不变的 form-data;附加的参数不区分大小写,并且拥有参数值,参数名与参数值用等号 (‘=’) 连接,参数值用双引号括起来。参数之间用分号 (‘;’) 分隔。
Content-Disposition: form-data; name="fieldName"
Content-Disposition: form-data; name="fieldName"; filename="filename.jpg"Content-disposition是 MIME 协议的扩展,MIME 协议指示 MIME 用户代理如何显示附加的文件。如图中的,当 Internet Explorer 接收到头时,它会激活文件下载对话框,它的文件名框自动填充了头中指定的文件名。(请注意,这是设计导致的;无法使用此功能将文档保存到用户的计算机上,而不向用户询问保存位置。)
3. x-www-form-urlencoded(raw)
可以上传任意格式的文本,可以上传text、json、xml、html等
content-type= text/html(HTML 文档);text/plain(纯文本);text/css(CSS 样式表);application/json (json字符串)比如:
application/json在响应头中很常见,在请求头中用来告诉服务端消息主体是序列化后的json字符串。
4. application/octet-stream
从字面意思得知,只可以上传二进制数据,通常用来上传文件,由于没有键值,所以,一次只能上传一个文件。
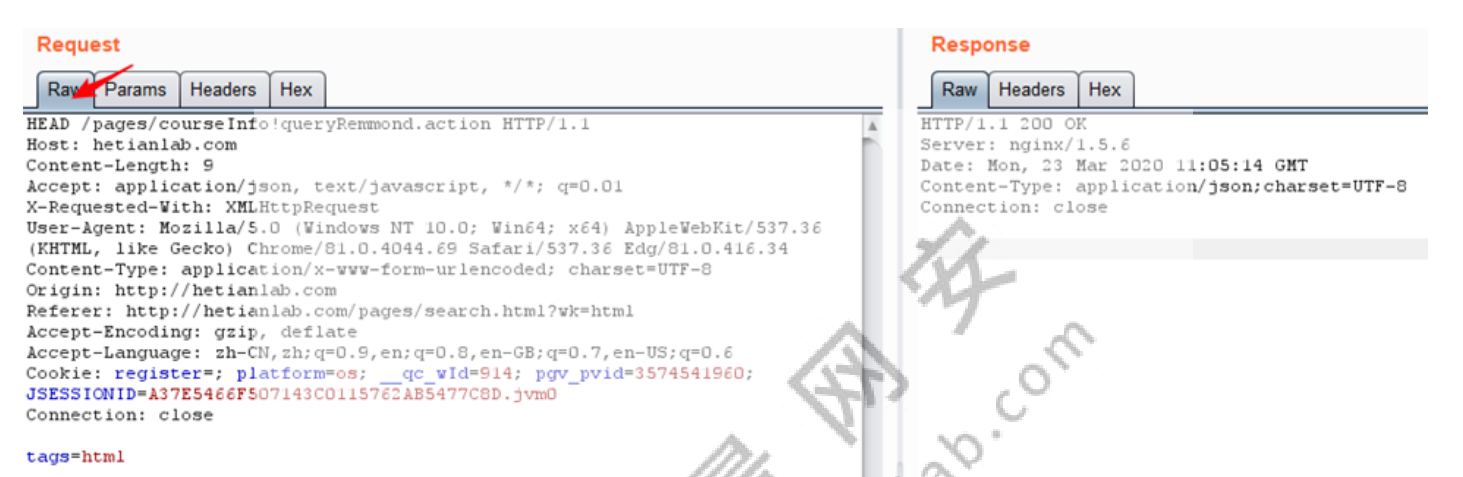
HEAD
HEAD:请求获取由Request-URI所标识的资源的响应消息报头首部,不会返回报文主体
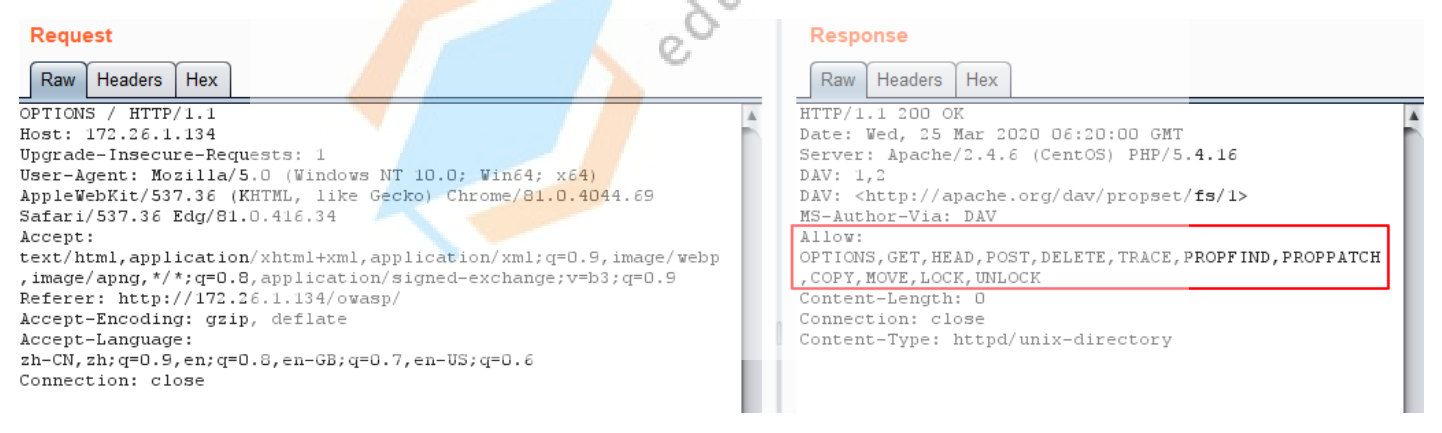
OPTIONS
OPTIONS:查询资源支持的方法。
PUT
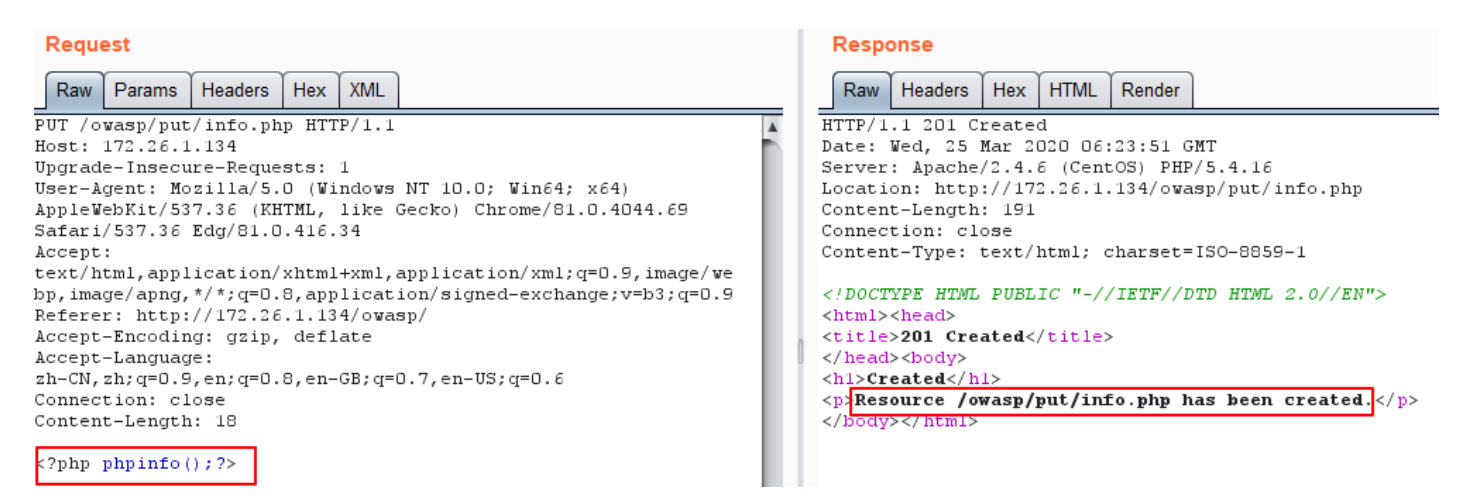
PUT:请求服务器存储一个资源,并用Request-URI作为其标识服务器会将请求主体的内容保存到URL指定的资源位置,包含两种情况:
URL指定的资源不存在,服务器会新建一个文件,将请求主体中的内容保存到新建的文件里,响应码为201。
URL指定的资源存在,服务器会重置文件内容,用请求主体中的内容覆盖原文件内容,响应码为200或204。
PUT方法自身不带验证机制,任何人都可以执行,存在安全问题,所以网站一般不会使用PUT方法。
DELETE
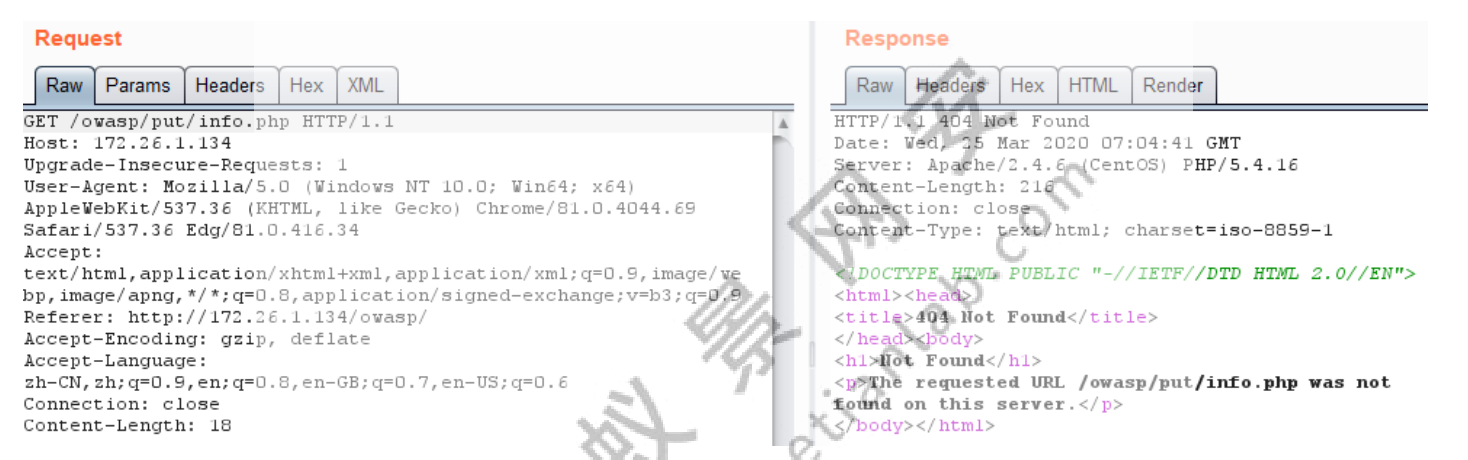
DELETE:请求服务器删除Request-URI所标识的资源
和PUT一样,DELETE方法同样不带验证机制,所以网站一般也不使用DELETE方法。
TRACE
TRACE:路径追踪,请求服务器回送收到的请求信息,主要用于测试或诊断发送的请求是否在客户端与服务端之间传送时被网关、防火墙、代理更改。
HTTPS与HTTP
HTTP与HTTPS的区别
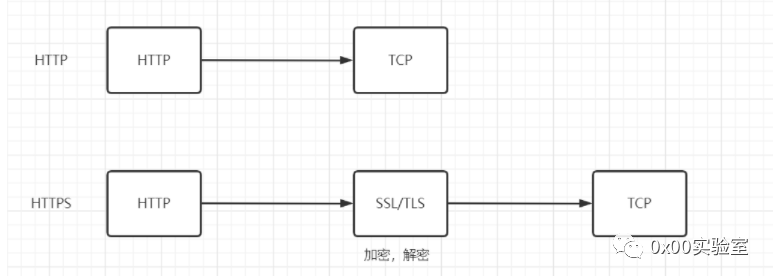
HTTP 是超文本传输协议,信息是明文传输,存在安全风险的问题。HTTPS 则解决 HTTP 不安全的缺陷,在 TCP 和 HTTP 网络层之间加入了 SSL/TLS 安全协议,使得报文能够加密传输。
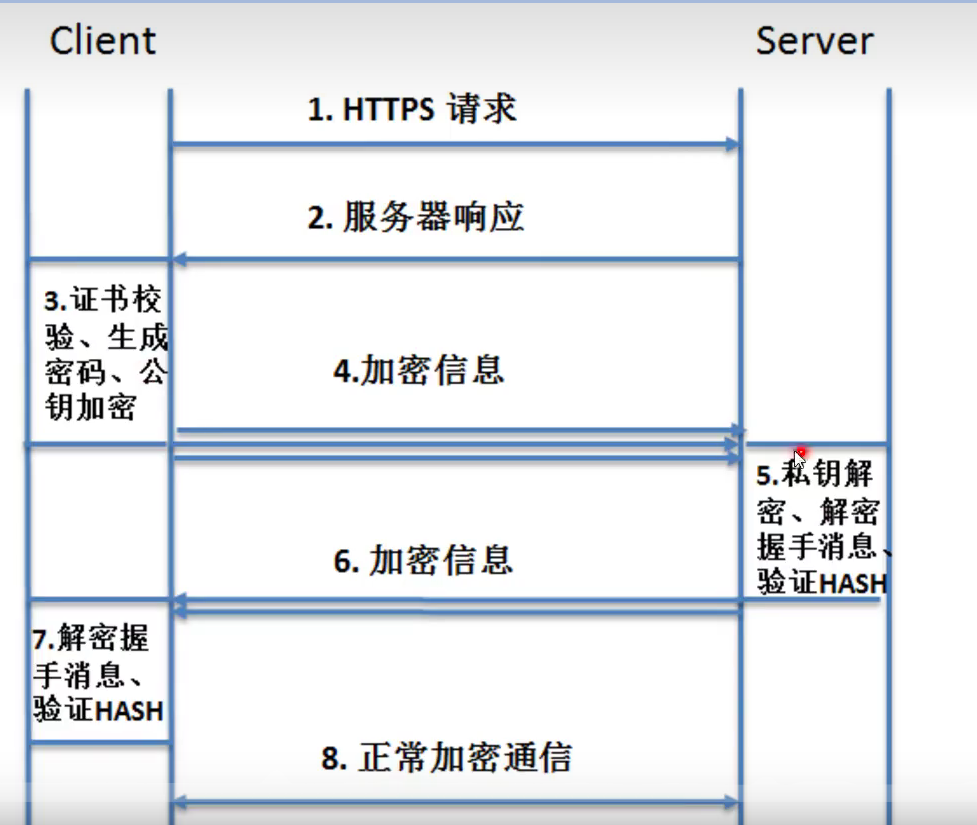
HTTP 连接建立相对简单, TCP 三次握手之后便可进行 HTTP 的报文传输。而HTTPS 在 TCP 三次握手之后,还需进行 SSL/TLS 的握手过程,才可进入加密报文传输。HTTP协议运行在TCP之上,所有传输的内容都是明文,HTTPS运行在SSL/TLS之上,SSL/TLS运行在TCP之上,所有传输的内容都经过加密的。
HTTP 的端口号是 80,HTTPS 的端口号是 443。
HTTPS 协议需要向 CA(证书权威机构)申请数字证书,来保证服务器的身份是可信的。一般免费证书很少,需要交费。
HTTPS可以有效的防止运营商劫持,解决了防劫持的一个大问题
HTTPS解决的问题
HTTP 由于是明文传输,所以安全上存在以下三个风险:
- 窃听风险,比如通信链路上可以获取通信内容,用户号容易没。
- 篡改风险,比如强制入垃圾广告,视觉污染,用户眼容易瞎。
- 冒充风险,比如冒充淘宝网站,用户钱容易没。
HTTPS 在 HTTP 与 TCP 层之间加入了 SSL/TLS 协议。
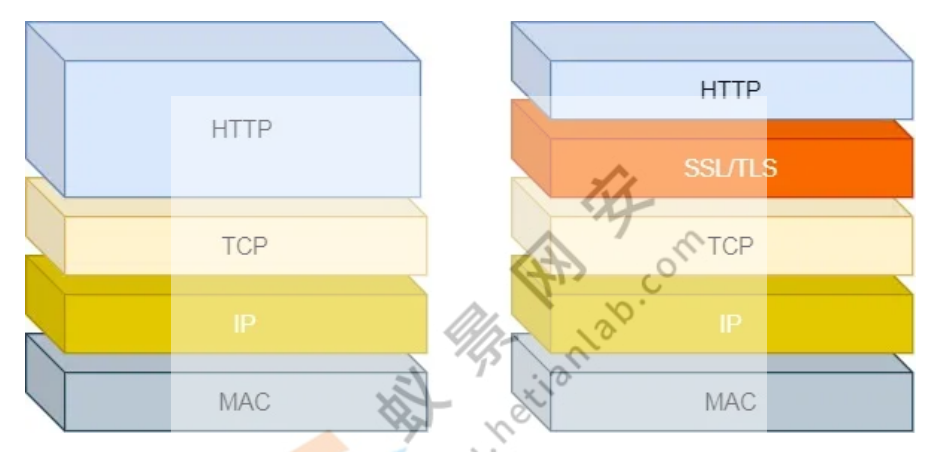
可以很好的解决了上述的风险:
- 信息加密:交互信息无法被窃取,但你的号会因为「自身忘记」账号而没。
- 校验机制:无法篡改通信内容,篡改了就不能正常显示,但百度「竞价排名」依然可以搜索垃圾广告。
- 身份证书:证明淘宝是真的淘宝网,但你的钱还是会因为「剁手」而没。
refer
-
声明:
若文章存在错误,望诸君不吝指正^
部分笔记由于年代久远,做的笔记找不到最初是引用谁的,若是不允许引用转载,请联系我