路由算法
路由算法综述
路由器转发分组是通过路由表转发的,而路由表是通过各种算法得到的。主机通常直接与一台路由器相连接,该路由器即为该主机的默认路由器(default router) ,又称该主机的第一跳路由器(first-hop router)每当主机发送一个分组时,该分组被传送给它的默认路由器。源主机的默认路由器称作源路由器(source router) ,目的主机的默认路由器称作目的路由器(destination router)。 一个分组从源主机到目的主机的路由选择问题显然可归结为从源路由器到目的路由器的路由选择问题。
【路由选择算法的分类】
- 1)静态路由算法(又称非自适应路由算法)
- 2)动态路由算法(又称自适应路由算法)
从掌握网络拓扑信息的规模来看常用的动态路由算法可分为两类:
- 距离-向量路由算法(分散路由选择算法)
- 链路状态路由算法(全局路由选择算法)
静态路由算法
- 由网络管理员手工配置路由信息。当网络的拓扑结构或链路的状态发生变化时,网络管理员需要手工去修改路由表中相关的静态路由信息。大型和复杂的网络环境通常不宜采用静态路由。
理由:
- 网络管理员难以全面了解整个网络的拓扑结构
- 当网络的拓扑结构和链路状态发生变化时,路由器中的静态路由信息需要大范围地调整,这一工作的难度和复杂程度非常高
- 路由信息更新慢
- 静态路由算法的优点是简便、可靠,在负荷稳定、拓扑变化不大的网络中运行效果很好,因此仍广泛用于高度安全的军事系统和较小的商业网络。且优先级高
动态路由算法
动态路由算法能改善网络的性能并有助于流量控制;但算法复杂,会增加网络的负担,有时因对动态变化的反应太快而引起振荡,或反应太慢而影响网络路由的一致性,因此要仔细设计动态路由算法,以发挥其优势。
特点:
- 路由更新快
- 定期更新(周期性)
距离-向量路由算法(RIP)-分散路由选择算法
简介:
路由信息协议RIP(Routing Information Protocol)采用距离-向量算法,利用跳数来作为计量标准,在实际使用中已经较少适用。距离向量路由算法,是基于Bellman-Ford方程,也就是动态规划算法实现的。
在距离向量路由算法中,同样是计算由u到其他任意一点。但在这种算法中,u无需知道整个网络的拓扑结构。对u来说,最重要的事情是知道,如果需要把数据运往z,最合适的邻居节点究竟是哪一个。
即节点只需获取最短路径的下一跳,无需知道整个网络拓扑的情况,并且该信息用于转发表中。
宏观:
在默认情况下,RIP使用一种非常简单的度量制度:距离就是通往目的站点所需经过的链路数,取值为0~16,数值16表示路径无限长。RIP进程使用UDP的520端口来发送和接收RIP分组。RIP分组每隔30s以广播的形式发送一次,为了防止出现“广播风暴”,其后续的分组将做随机延时后发送。在RIP中,如果一个路由在180s内未被刷新,则相应的距离就被设定成无穷大,并从路由表中删除该表项。RIP分组分为两种:请求分组和响应分组。
发送方(请求分组):
在距离-向量路由算法中,所有结点都定期地将它们的整个路由选择表传送给所有与之直接相邻的结点。这种路由选择表包含:
- 每条路径的目的地(另一结点)。
- 路径的代价(也称距离)。
【注意】:
这里的距离是一个抽象的概念,如RIP 就将距离定义为“跳数"。跳数指从源端口到达目的端口所经过的路由个数,每经过一个路由器,跳数加1 。
接收方(响应分组):
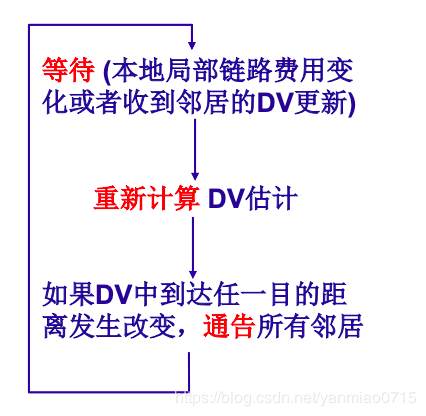
在这种算法中,所有结点都必须参与距离向量交换,以保证路由的有效性和一致性,也就是说,所有的结点都监听从其他结点传来的路由选择更新信息,并在下列情况下立刻更新它们的路由选择表:
- 被通告一条新的路由,该路由在本结点的路由表中不存在,此时本地系统加入这条新的路由。
- 发来的路由信息中有一条到达某个目的地的路由,该路由与当前使用的路由相比,有较短的距离(较小的代价)。此种情况下,就用经过发送路由信息的结点的新路由替换路由表中到达那个目的地的现有路由。
总结起来如下图:(DV即为距离向量)
距离向量路由算法的实质
迭代计算一条路由中的站段数或延迟时间,从而得到到达一个 目标的最短(最小代价)通路。它要求每个结点在每次更新时都将它的全部路由表发送给所有相邻的结点。显然,更新报文的大小与通信子网的结点个数成正比,大的通信子网将导致很大的更新报文。由于更新报文发给直接邻接的结点,所以所有结点都将参加路由选择信息交换。基于这些原因,在通信子网上传送的路由选择信息的数量很容易变得非常大。
距离向量路由算法是一种迭代的、异步的、分布式的算法。
迭代很好理解,在每个节点只需要知道他的下一跳的目的地的情况下,想要求得最小路径,那么必然需要使用迭代,使得最短路径不断趋近于真实值。为什么说是不断趋近于真实值呢?一开始,也就是初始化时,结点只知道他到其邻居结点的距离,而不知道到其他结点的距离。这就必然造成此结点到其直接邻居结点的距离并非是最优的,可能是绕过一个或两个结点再到此结点的情况,才是最短的路径。
所谓异步的,是因为我们不要求结点的步调整齐一致,也就是计算最短路径的时间可以是不同的。实际上,时间基本上就是不同。
所谓分布式的,是说每个节点都能接收到来自其邻居的信息,并执行计算,然后再将计算结果分发给邻居,邻居再将收到的数据进行计算,如果发现了其他最短路径,那么就会更新自身的信息,又进入了一个迭代的过程。
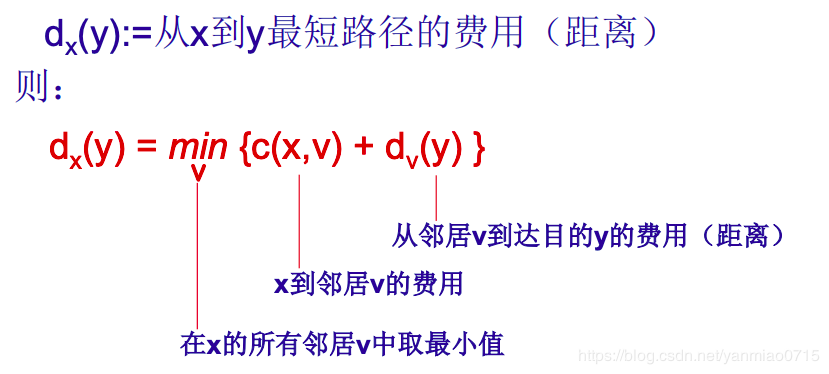
整个算法中最重要的是这样一个方程:
链路状态路由算法(OSPF)-全局路由选择算法
简介
在链路状态路由算法中,网络拓扑和所有的链路费用都是已知的。所有的结点或者说路由器都掌握着完整的网络拓扑和链路费用。
不论是链路状态路由算法还是距离向量选择算法,核心要义都是四个字:”最短路径“。并且知晓网络全貌,了解整个网络拓扑,那自然是会用到Prim和Dijkstra算法。
它们执行下述两项任务:
- 第一,主动测试所有邻接结点的状态。两个共享一条链接的结点是相邻结点,它们连接到同一条链路,或者连接到同一广播型物理网络。
- 第二,定期地将链路状态传播给所有其他结点。
典型的链路状态算法是OSPF算法。
在一个链路状态路由选择中,一个结点检查所有直接链路的状态,并将所得的状态信息发送给网上的所有其他结点,而不是仅送给那些直接相连的结点。每个结点都用这种方式从网上所有其他的结点接收包含直接链路状态的路由选择信息。
每当链路状态报文到达时,路由结点便使用这些状态信息去更新自己的网络拓扑和状态“视野图”,一旦链路状态发生变化,结点就对更新的网络图利用Dijsktra最短路径算法重新计算路由,从单一的源出发计算到达**==所有==**目的结点的最短路径。
【注意】
这是Dijsktra算法的一个实际应用
链路状态路由算法主要有三个特征:
- 向本自治系统中所有路由器发送信息,这里使用的方法是泛洪法,即路由器通过所有端口向所有相邻的路由器发送信息。而每个相邻路由器又将此信息发往其所有相邻路由器(但不再发送给刚刚发来信息的那个路由器)。
【洪泛法小知识】
洪泛法(Flooding)是一种简单的路由算法,将收到的封包,往所有的可能连结路径上递送,直到封包到达为止。洪泛法被使用在桥接器上,Usenet以及点对点档案分享等。部份的路由协定也以洪泛法为基础,例如开放式最短路径优先(OSPF)、距离向量群体广播路由协定(DistanceVectorMulticastRoutingProtocol,DVMRP)。无线随意网络也使用洪泛法来进行路由。
发送的信息是与路由器相邻的所有路由器的链路状态,但这只是路由器所知道的部分信息。所谓“链路状态”,是指说明本路由器与哪些路由器相邻及该链路的“度量”。对于OSPF 算法,链路状态的"度量”主要用来表示费用、距离、时延、带宽等。
只有当链路状态发生变化时,路由器才向所有路由器发送此消息。由于一个路由器的链路状态只涉及相邻路由器的连通状态,而与整个互联网的规模并无直接关系,因此链路状态路由算法可以用于大型的或路由信息变化聚敛的互联网环境。
优点
- 每个路由结点都使用同样的原始状态数据独立地计算路径,而不依赖中间结点的计算;
- 链路状态报文不加改变地传播,因此采用该算法易于查找故障。当一个结点从所有其他结点接收到报文时,它可以在本地立即计算正确的通路,保证一步汇聚。
- 由于链路状态报文仅运载来自单个结点关于直接链路的信息,其大小与网络中的路径结点数目无关,因此链路状态算法比距离-向量算法有更好的规模可伸展性。
距离-向量路由算法与链路状态路由算法的比较:
在距离-向量路由算法中,每个结点仅与它 的直接邻居交谈,它为它的邻居提供从自已到网络中所有其他结点的最低费用估计。在链路状态 路由算法中,每个结点通过广播的方式与所有其他结点交谈,但它仅告诉它们与它直接相连的链 路的费用。相较之下,距离-向量路由算法有可能遇到路由环路等问题。
- 【路由环路问题】:
在维护路由表信息的时候,如果在拓扑发生改变后,网络收敛缓慢产生了不协调或者矛盾的路由选择条目,就会发生路由环路的问题,这种条件下,路由器对无法到达的网络路由不予理睬,导致用户的数据包不停在网络上循环发送,最终造成网络资源的严重浪费。
OSPF(Open Shortest Path First开放式最短路径优先)是对链路状态路由协议的一种实现,著名的迪克斯加算法被用来计算最短路径树。OSPF支持负载均衡和基于服务类型的选路,也支持多种路由形式,如特定主机路由和子网路由等。OSPF的简单说就是两个相邻的路由器通过发报文的形式成为邻居关系,邻居再相互发送链路状态信息形成邻接关系,之后各自根据最短路径算法算出路由,放在OSPF路由表,OSPF路由与其他路由比较后优的加入全局路由表。
层次路由
当网络规模扩大时,路由器的路由表成比例地增大。这不仅会消耗越来越多的路由器缓冲区空间,而且需要用更多CPU 时间来扫描路由表,用更多的带宽来交换路由状态信息。因此路由选择必须按照层次的方式进行。
因特网将整个互联网划分为许多较小的自治系统(注意一个自治系统中包含很多局域网),每个自治系统有权自主地决定本系统内应采用何种路由选择协议。如果两个自治系统需要通信,那么就需要一种在两个自治系统之间的协议来屏蔽这些差异。据此,因特网把路由选择协议划分为两大类
- 一个自治系统内部所使用的路由选择协议称为内部网关协议(IGP), 也称域内路由选择,具体的协议有RIP 和OSPF 等。
- 自治系统之间所使用的路由选择协议称为外部网关协议(EGP), 也称域间路由选择,用在不同自治系统的路由器之间交换路由信息,并负责为分组在不同自治系统之间选择最优的路径。具体的协议有BGP 。
迪杰斯特拉算法(Dijkstra算法)
从一个例子开始
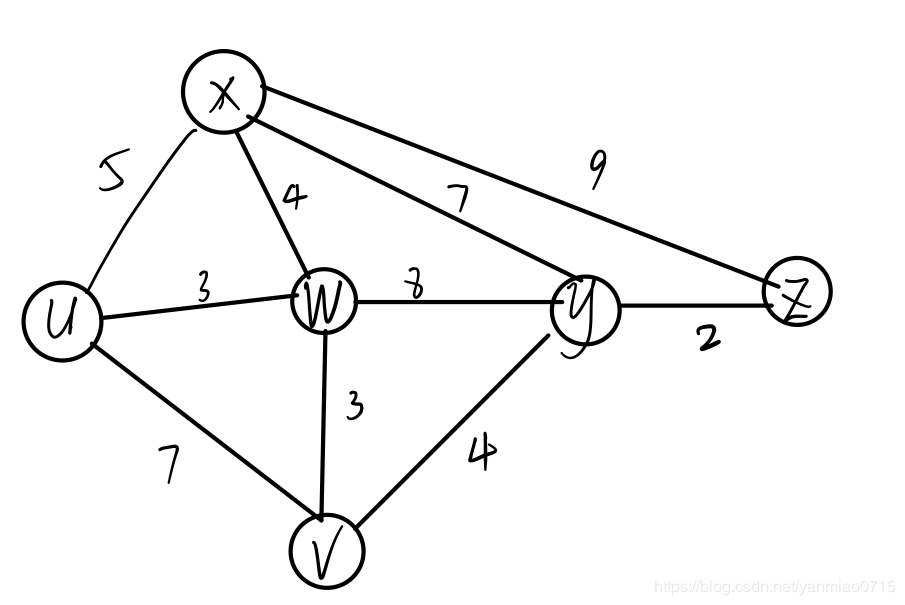
在上图中,我们以u为起点,计算u到z的最短路径。可见,若要计算u到z的路径,那么必须考虑全局信息。
实际上,迪杰斯特拉算法的核心内容是:找最小,然后找最小的邻居。
具体过程参考下图。
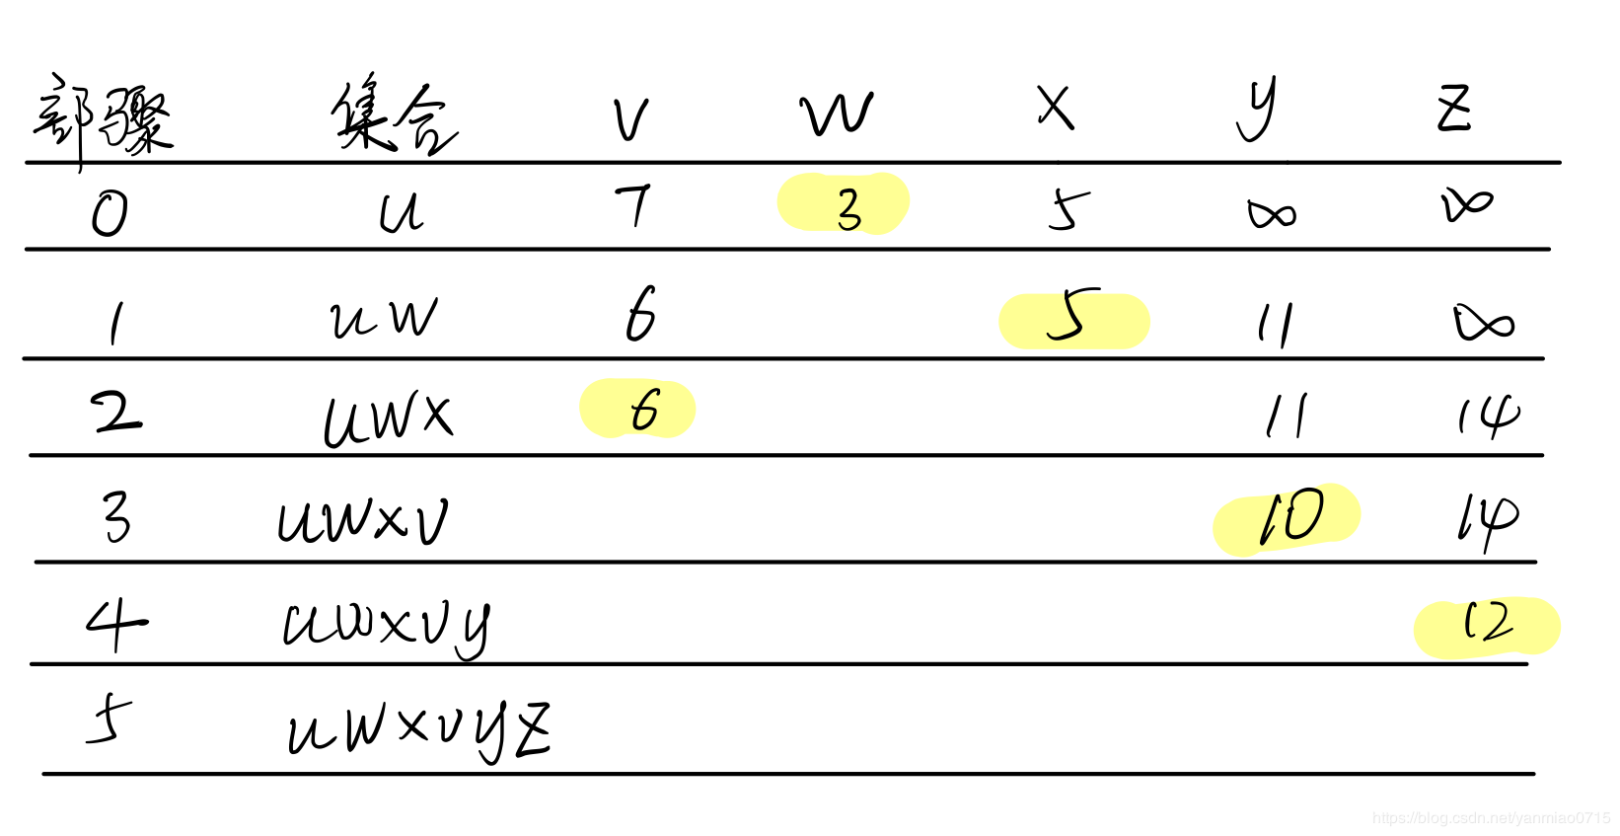
- 初始化 :与u相邻的置为权值,不与u相邻的置为无穷。
- 找到最小 :在上图中,与u相邻的权值最小的是(w,3),所以将w加入集合中。
- 在其余中找最小 :5为最小,则将x加入集合。经过x,可以到达z,这样最短,将z更新为14。
- 接着找最小 :6为最小,将v加入集合。经过uwv,可以到达y,最小值为10,则更新。
- 依次类推,得到最终结果
所以,我们能够得到最终的转发表。
| 目的 | 链路 |
|---|---|
| v | u-w-v |
| x | u-x |
| y | u-w-v-y |
| w | u-w |
| z | u-w-v-y-z |
Prim算法——最小生成树
prim算法被用来求给定图的最小生成树
普里姆算法的实现思路是:
- 将连通网中的所有顶点分为两类(假设为 A 类和 B 类)。初始状态下,所有顶点位于 B 类;
- 选择任意一个顶点,将其从 B 类移动到 A 类;
- 从 B 类的所有顶点出发,找出一条连接着 A 类中的某个顶点且权值最小的边,将此边连接着的 A 类中的顶点移动到 B 类;
- 重复执行第 3 步,直至 B 类中的所有顶点全部移动到 A 类,恰好可以找到 N-1 条边。
举个例子,下图是一个连通网,使用普里姆算法查找最小生成树,需经历以下几个过程:
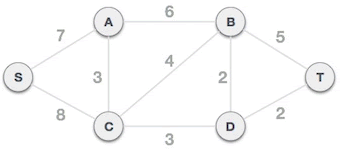
图 1 连通网
\1) 将图中的所有顶点分为 A 类和 B 类,初始状态下,A = {},B = {A, B, C, D, S, T}。
\2) 从 B 类中任选一个顶点,假设选择 S 顶点,将其从 B 类移到 A 类,A = {S},B = {A, B, C, D, T}。从 A 类的 S 顶点出发,到达 B 类中顶点的边有 2 个,分别是 S-A 和 S-C,其中 S-A 边的权值最小,所以选择 S-A 边组成最小生成树,将 A 顶点从 B 类移到 A 类,A = {S, A},B = {B, C, D, T}。
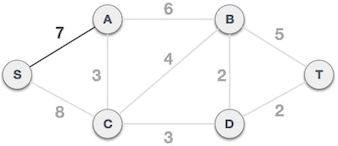
图 2 S-A 边组成最小生成树
\3) 从 A 类中的 S、A 顶点出发,到达 B 类中顶点的边有 3 个,分别是 S-C、A-C、A-B,其中 A-C 的权值最小,所以选择 A-C 组成最小生成树,将顶点 C 从 B 类移到 A 类,A = {S, A, C},B = {B, D, T}。
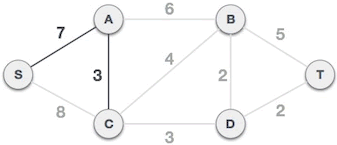
图 3 A-C 边组成最小生成树
\4) 从 A 类中的 S、A、C 顶点出发,到达 B 类顶点的边有 S-C、A-B、C-B、C-D,其中 C-D 边的权值最小,所以选择 C-D 组成最小生成树,将顶点 D 从 B 类移到 A 类,A = {S, A, C, D},B = {B, T}。
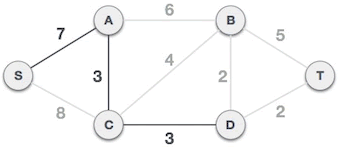
图 4 C-D 边组成最小生成树
\5) 从 A 类中的 S、A、C、D 顶点出发,到达 B 类顶点的边有 A-B、C-B、D-B、D-T,其中 D-B 和 D-T 的权值最小,任选其中的一个,例如选择 D-B 组成最小生成树,将顶点 B 从 B 类移到 A 类,A = {S, A, C, D, B},B = {T}。
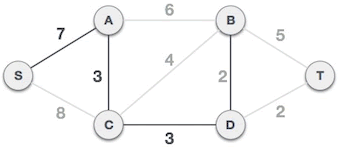
图 5 D-B 边组成最小生成树
\6) 从 A 类中的 S、A、C、D、B 顶点出发,到达 B 类顶点的边有 B-T、D-T,其中 D-T 的权值最小,选择 D-T 组成最小生成树,将顶点 T 从 B 类移到 A 类,A = {S, A, C, D, B, T},B = {}。
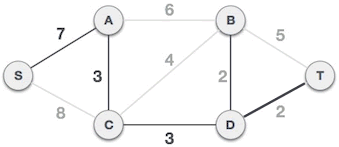
图 6 D-T 边组成最小生成树
\7) 由于 B 类中的顶点全部移到了 A 类,因此 S-A、A-C、C-D、D-B、D-T 组成的是一个生成树,而且是一个最小生成树,它的总权值为 17。
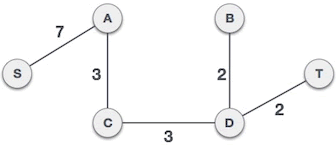
图 7 最小生成树
Prim与Dijkstra算法的区别
两者的区别在于,每次更新路径的不一样
- prim更新的是未标记集合到已标记集合之间的距离
- Dijkstra更新的是源点到未标记集合之间的距离
Prim算法
for k in range(n): #更新lowcost |
Dijkstra算法
for k in range(n): |
参考: